论文阅读——TSAI
现有方法的致命缺陷
当前免训练的方法主要有对比解码(Contrastive Decoding)和注意力干预(Attention Intervention)。但作者指出,它们普遍存在一个隐式的错误假设——“同质化假设”(Homogeneous Assumption):
- 一刀切的弊端:这些方法在整个文本生成的过程中,施加的是全局统一、上下文无关(Context-agnostic)的惩罚。
- 预算浪费:由于惩罚目标不明确,它们把有限的干预资源(干预预算)浪费在了原本“低风险”的 Token 上,导致模型的生成质量(语言流利度)与幻觉抑制之间无法达到最优平衡(比如管得太死导致模型话都不会说了)。
核心发现:幻觉的“多维异质性”
为了打破上述一刀切的局限,作者对 MLLM 的长文本解码过程进行了深度的定量分析(也就是我们刚才看的 Figure 1),并首次确凿地揭示了幻觉具有多维异质性:
- 时间轴上:后期累积。随着自回归解码的深入,幻觉在生成的中后期呈现出明显的累积趋势。
- 语义轴上:上下文共现错觉(Contextual Co-occurrence Illusion)。当模型开始胡说八道(产生幻觉)时,它对历史生成过的“语义 Token”的注意力会异常增高。
💡 深层根源(模态鸿沟):作者进一步指出了这种现象的底层数学本质——跨模态表示空间中的模态鸿沟(Modality Gap)。在模型内部,“文本-文本”的相似度天然高于“图像-文本”的对齐度。因此,随着自回归一步步往下走,视觉信息被不断稀释,大模型开始走捷径,顺着自己前面写过的文本高密度流形一路跑偏(即语义惯性),彻底把图片抛在了脑后。
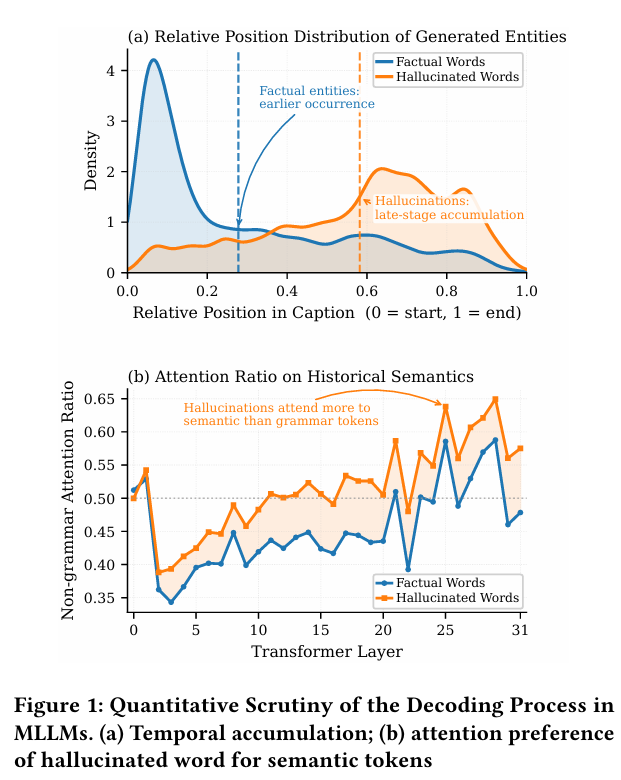
(a) 图:生成的实体在句子中的位置分布 (Temporal Position)
这张图统计了模型生成的词在整个句子(Caption)从开头(0.0)到结尾(1.0)的位置分布。
- 蓝色线(Factual Words / 真实词):波峰极度集中在 0.0 到 0.2 之间。这说明符合事实的物体描述往往在句子前半句就早早出现了(Factual entities earlier occurrence)。
- 橙色线(Hallucinated Words / 幻觉词):波峰显著向右偏移,大量堆积在 0.6 到 0.9 之间。这铁证了幻觉具有明显的“后期累积”特征(Hallucinations: late-stage accumulation),模型句子越写到后面,越容易胡思乱想。
(b) 图:不同层对历史语义的注意力比例 (Attention Ratio)
这张图统计了在 Transformer 的不同层数中,模型在生成下一个词时,注意力分配给“历史文本”的比例。
- 纵轴意义:非语法词注意力比例(Non-grammar Attention Ratio)。这里的“非语法词”指的就是具体的语义词(Semantic tokens),排除了无意义的介词、标点等语法锚点。
- 对比结果:无论在哪一层,橙色线(幻觉词)的注意力比例都死死压着蓝色线(真实词)。
- 核心结论:当模型在产生幻觉时,它对历史生成过的“语义词”分配了异常高的注意力(Hallucinations attend more to semantic than grammar tokens)。它不看图片,而是被自己前面说过的具体词汇给吸进去了,也就是摘要里说的产生“语义惯性”。
三个最核心的维度
1. 拆分了“时间轴”:从全局通罚到后期重罚 (Temporal Decoupling)
- 过去的方法:在生成的每一个字、每一秒,对历史文本的惩罚力度完全一样 。
- TSAI 的拆分:它把文本生成的过程按时间步(Steps)进行了切块 。在句子刚开头的语法构建期,它不怎么插手;随着自回归越往后走,幻觉风险在后期开始累积时,它的惩罚力度才像阶梯一样层层递增(步进式渐进惩罚) 。
- 分配结果:成功在开头保护了句子的流利度,并在后期精准扼杀了幻觉的累积 。
2. 拆分了“语义轴”:从无差别剥夺到语法保护 (Semantic Decoupling)
- 过去的方法:一旦决定惩罚历史,就把前面生成过的所有词(不论是标点还是具体名词)的注意力全部等比例扣除。
- TSAI 的拆分:它在历史文本的 Token 阵营里拉了一道防火墙 。它把历史词拆分成了“语法锚点(介词、标点等)”和“高危历史语义词(具体的物体、实体等)” 。对于语法词它网开一面(低剥夺),只把重罚精准地拍在那些容易引发共现幻觉的“历史语义词”上 。
- 分配结果:用最小的干预代价,击碎了引发幻觉的文本惯性,同时完全不伤及大模型说话的语言骨架 。
3. 拆分了“补偿去向”:从单向视觉注入到双特征特征补偿 (Dual-Axis Compensation)
- 过去的方法:把扣出来的注意力额度,全部粗暴地全额塞给图像。这会导致模型出现“指令遗忘(Instruction Forgetting)”——光看图不听指挥 。
- TSAI 的拆分:它把回收上来的“注意力资金池”进行了公允的二次切分,引入了双特征特征补偿(Dual Feature Compensation) 。这些额度会按照比例,同时分配给图像 Token(加强视觉锚定)和当前的用户指令 Token(保持任务意图) 。
- 分配结果:模型不仅看图看得很准,而且牢牢记着主人的任务要求,完美解决了管得太死导致模型不听话的行业痛点 。
相关工作
1. Logit 概率分布校准流派(Logit-level & Decoding Strategies)
这一流派的核心思想是在模型预测下一个词输出的概率分布(Logits)上做文章,通过人为调整概率来扼杀幻觉
OPERA :它发现模型在产生幻觉时,注意力往往会陷入局部自我循环(Over-trust 现象) 。因此它引入了一个基于注意力聚合模式的惩罚项,并搭配了一个“回溯-分配(Retrospection-allocation)”机制 。当发现不对劲时,它会触发序列回滚(Sequence Rollback),退回去重新生成 。
VCD 和 PAI :属于对比解码(Contrastive Decoding)流派 。
- VCD 通过给图像注入视觉噪声来制造一个“业余模型(Amateur)”,然后用原模型(Expert)的 Logits 减去业余模型的 Logits,从而过滤失真的语言先验 。
- PAI 则更激进,它直接剥离图像输入(只给文本历史),让业余模型纯靠文本惯性盲猜,再用原模型去减它,以此抵消文本惯性 。
DoLa 和 DeCo :属于层间对比(Layer Contrastive)流派。它们利用大模型深层(包含更多事实特征)和浅层(包含更多语言先验)的 Logits 进行对比或动态修正,以此放大真实表征 。
❌ 此类前作的共同痛点: 这些 Logit 校正方法往往需要多次前向传播(例如 VCD/PAI 生成每个 Token 需要跑 2 次前向)、层级追踪或序列回滚(如 OPERA),这不可避免地带来了高昂的计算和时间开销,导致推理变慢 。
2. 多阶段工作流流派(Multi-stage Pipeline Interventions)
这一流派不在单次生成里做微调,而是把任务做成了流水线 。
EAZY :在输入端下功夫,通过视觉掩码(Visual Masking)过滤掉容易引发幻觉的输入源 。
HalTrapper :设计了一套“诱导-检测-抑制”(Induce-Detect-Suppress)的完整 Pipeline,主动设套诱导模型暴露出幻觉倾向再加以拔除 。
Woodpecker :属于后处理修正(Post-hoc Correction),等模型全部说完了,再调用一个外部小工具像啄木鸟一样一行行去核对和纠错 。
❌ 此类前作的共同痛点: 架构过于流水线化(Pipeline-heavy),需要多步处理或外部调用,大幅度增加了推理延迟,无法做到真正的实时响应 。
3. 注意力矩阵干预流派(Attention Interventions)
直接修改 Transformer 内部的 post-softmax 注意力矩阵 。
AttnReal :它是 TSAI 最直接的近亲 。它同样在单次前向传播(Single Forward Pass)中运行 ,其做法是识别历史输出 Token 中的“注意力下水道(Attention Sinks)”,把这些无用权重强行抠出来挪给视觉 Token 。
TSAI 框架总览
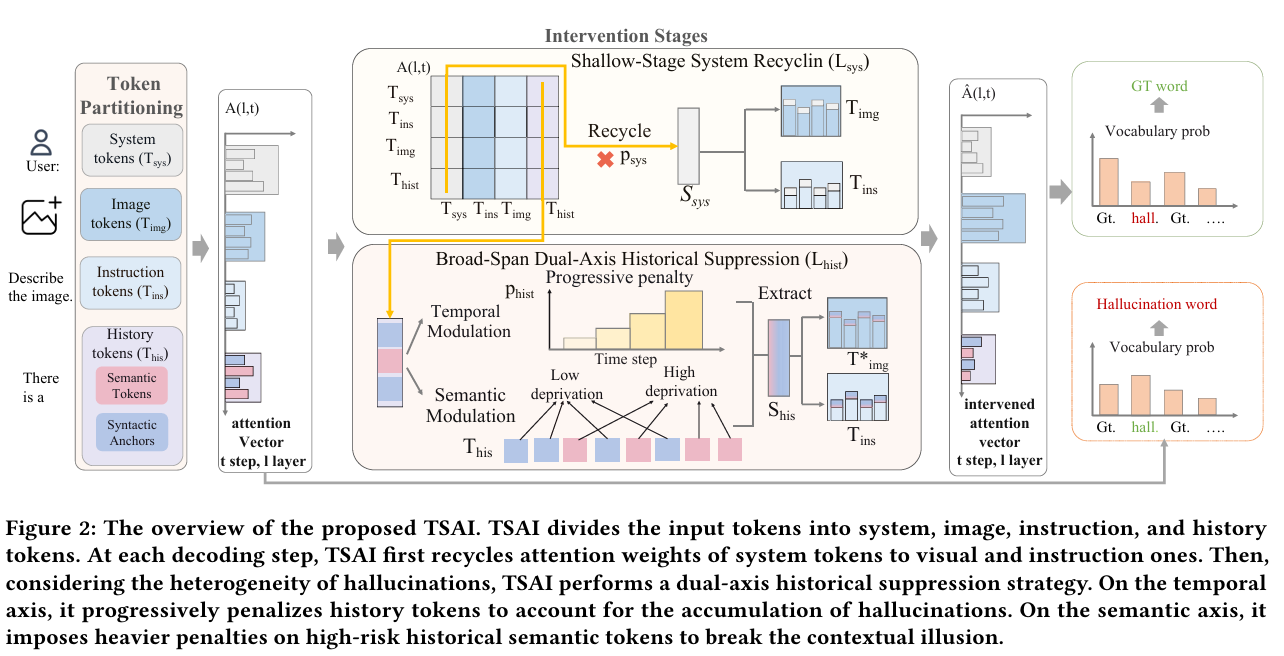
第一步:Token 空间划分 (Token Partitioning)
在输入端,TSAI 将上下文的所有 Token 严格划分为四个互斥的语义子集:
- $\mathcal{T}_{\text{sys}}$ (系统 Token):如大模型固定的 Prompt(“User: ”)。
- $\mathcal{T}_{\text{img}}$ (图像 Token):由视觉编码器转化而来的图像 Patch。
- $\mathcal{T}_{\text{ins}}$ (指令 Token):用户输入的具体任务文本(如 “Describe the image.”)。
- $\mathcal{T}_{\text{his}}$ (历史 Token):模型在前 $t-1$ 步已经自己生成出的响应文本。
- 进一步细分为:包含实际物体的语义词(Semantic Tokens)\和用于维持结构的*语法锚点(Syntactic Anchors)*。
划分后,在每一步($t$ 步)和每一层($l$ 层)都能得到一根初始的注意力向量 $A(l,t)$。
第二步:干预阶段(Intervention Stages)
这是 TSAI 最核心的两大并行/协同干预机制:
1️⃣ 浅层系统注意力回收 (Shallow-Stage System Recycling)
- 动作:针对浅层网络($\mathcal{L}{\text{sys}}$),算法发现系统词 $\mathcal{T}{\text{sys}}$ 占用了大量无用的注意力(形成 Attention Sink)。
- 操作:通过乘以一个提取因子 $\rho{\text{sys}}$,强行把分配给系统词的注意力“回收”上来,形成一个可调配的注意力预算总额 $S{\text{sys}}$。
- 去向:将回收来的这笔额度,按照固定比例补偿分配给视觉 Token ($\mathcal{T}{\text{img}}$) 和指令 Token ($\mathcal{T}{\text{ins}}$)。
2️⃣ 宽跨度双轴历史抑制 (Broad-Span Dual-Axis Historical Suppression)
针对较深层网络($\mathcal{L}_{\text{hist}}$),为了打破幻觉的异质性,实施双轴联合绞杀:
- 时间轴(Temporal Modulation):引入步进式渐进惩罚(Progressive penalty)。随着时间步(Time step)往后推移,幻觉风险越高,惩罚力度 $p_{\text{hist}}$ 呈阶梯状越来越重,完美贴合幻觉后期累积的节奏。
- 语义轴(Semantic Modulation):实施差异化剥夺(Differential deprivation)。对历史 Token ($\mathcal{T}_{\text{his}}$) 区别对待——如果是无意义的语法词,给予低剥夺(Low deprivation);如果是高危的历史语义词,给予高剥夺(High deprivation),从而狠狠压制语义惯性。
- 去向:通过双轴计算,从历史词中强行扣除一笔注意力总额 $S{\text{his}}$,同样将其补偿给经过 Prefill 阶段筛选的高显著视觉 Token ($\mathcal{T}^*{\text{img}}$) 以及指令 Token ($\mathcal{T}_{\text{ins}}$)。
第三步:生成与最终概率输出 (Unified Output)
- 经过上述“扣除与补充”的动态调整后,模型得到了一个全新的、经过干预的注意力向量 $\hat{A}(l,t)$。
- 最终效果对比:
- 如果没有干预(下路):模型在预测下一个词时,受语义惯性影响,词表概率(Vocabulary prob)中幻觉词(Hallucination word,如 “ball”)的概率会反超真实词,导致输出幻觉。
- 应用 TSAI 干预后(上路):由于高危历史语义被压制、视觉和指令被放大,词表概率得到完美校准,真实词(GT word)的概率遥遥领先,模型得以准确输出符合事实的文本。
Method
1. 问题建模与 Token 空间划分 (Problem Formulation)
在标准的 MLLM 自回归解码中,假设我们在第 $t$ 个生成步骤、第 $l$ 层 Transformer 网络中。此时,大模型算完 $Q \times K^\top$ 跑完 Softmax 后,会得到当前位置对过去所有位置的初始注意力分数向量 $A^{(l,t)} \in \mathbb{R}^L$($L$ 为当前总上下文序列长度)。
为了能够“数格子”动手术,TSAI 做的第一个拆分,就是将整个上下文空间 $L$ 划分为四个互不相交的语义子集 :
- $\mathcal{T}_{\text{sys}}$(系统 Token):视觉输入前固定的系统 Prompt 词(如
USER:)。 - $\mathcal{T}_{\text{img}}$(图像 Token):输入的 $N_v$ 个图像 Patch 块 。
- $\mathcal{T}_{\text{ins}}$(指令 Token):用户输入的具体文本命令(如
Describe the image.)。 - $\mathcal{T}_{\text{his}}$(历史 Token):截至当前步 $t$ 之前,模型自己吐出来的所有历史生成词 。
作者指出,幻觉的本质就是注意力预算在这四个子集里分配失调,模型过于死盯着历史文本 $\mathcal{T}{\text{his}}$ 产生了共现幻想,却忽略了图像事实 $\mathcal{T}{\text{img}}$ 。
2. 浅层系统注意力回收 (Shallow-Stage System Recycling)
通过前期的定量分析(Figure 3),作者注意到在网络的指定浅层($l \in \mathcal{L}{\text{sys}}$,如前 10 层)中,系统词 $\mathcal{T}{\text{sys}}$ 占用了极其巨大的无用注意力 。
为了“白嫖”这部分被白白浪费的预算,TSAI 在浅层网络直接祭出第一刀——硬性按比例扣除 :
$\rho_{\text{sys}} \in (0,1)$ 是预设的抽取比例 。
这些被强行剥夺出来的注意力分数,会被打包累加成一个可支配的浅层系统回收资金池 $S_{\text{sys}}^{(l,t)}$ :
随后,这笔额度会通过动态比例(超参数 $Y{\text{ins}}$ 和 $Y{\text{img}}$),按需补偿分配给指令 Token 和视觉 Token,从而在网络刚开始时就牢牢帮模型锚定住任务意图 。
3. 宽跨度双轴历史抑制 (Broad-Span Dual-Axis Historical Suppression)
这是 TSAI 最精妙的地方。在中深层网络中($l \in \mathcal{L}{\text{hist}}$),为了防止模型眼睛脱离图片、只盯着历史词瞎编,算法对历史 Token $\mathcal{T}{\text{his}}$ 进行了“时间 + 语义”的双轴细粒度拆分与重罚 :
轴一:时间轴 —— 步进式渐进惩罚 (Temporal Axis)
1. 为什么不能一刀切?
如果从句子的第一个字开始,就对历史文本施加一成不变的重罚,会带来灾难性的后果 。句子开头(如主语、谓语的构建期)大模型高度依赖前文的语法和结构,如果此时粗暴地扣掉历史注意力,大模型就会“失语”,逻辑彻底崩盘(F1分数塌陷) 。
2. 数学公式实现
作者通过 Figure 1 (a) 发现,幻觉往往在长文本生成的后半段才开始滚雪球式地爆发 。因此,作者为历史抑制设计了一个随时间步(Decoding Step $t$)阶梯状 monotonic 递增的动态基础惩罚因子 $\rho_{\text{his}}^{(t)}$ :
- $\lfloor\frac{t}{n}\rfloor$(分块下取整):$n$ 是指定的文本块大小(Chunk size) 。这意味着惩罚不是丝滑连续变化的,而是每隔 $n$ 个字(比如每隔 5 个字)才上一个台阶 。因为作者敏锐地洞察到,幻觉在模型内部往往是以“离散的语义块(Discrete semantic chunks)”形式累积的 。
- $\Delta\rho$:每个阶梯固定的惩罚增量 。
- $\rho_{\text{max}}$:惩罚的保护上限,防止到了生成极后期时把历史注意力彻底扣成 0,导致模型彻底忘掉前文 。
💡 时间轴的效果:
句子刚开头时($t$ 很小),$\rho_{\text{his}}^{(t)} = 0$,TSAI 选择冷眼旁观,不打扰大模型梳理语言结构 。随着文字越吐越多,大模型开始有编造幻觉的倾向时($t$ 变大),惩罚力度阶梯式暴涨,拦截网越收越紧 。
轴二:语义轴 —— 语法差异化剥夺 (Semantic Axis)
1. 拦截网里的“无辜者”
即使到了生成后期,大模型去查阅历史文本时,历史文本里也包含两类完全不同的 Token :
- 语法锚点(Syntactic Anchors):如标点符号(
,、.)、连词(and)、介词(in、on) 。 - 具体语义词(Semantic Tokens):如具体的物体名词(
dog、fridge、ball) 。
如果无差别通罚,把标点和介词的注意力也扣光,模型说话就会变得颠三倒四(比如连主谓宾都连不起来) 。真正引发幻觉惯性的,是那些具体的物体语义词 。
2. 数学公式实现
作者引入了一个指示函数 $\mathbb{I}[i \in \mathcal{G}]$(其中 $\mathcal{G}$ 是一个预设的、包含标点介词的静态语法词表库) 。通过它来作为标点符号的防护盾,计算出每个历史位置 $i$ 最终承受的 deprivation 比例 $\rho_i^{(t)}$ :
- 如果当前位置 $i$ 对应的是一个“标点/语法词”: 此时 $i \in \mathcal{G}$,指示函数 $\mathbb{I} = 1$ 。 代入公式后,括号里变成了 $1 - (1 - \beta) = \beta$。 最终惩罚降级为:$\rhoi^{(t)} = \beta \cdot \rho{\text{his}}^{(t)}$ 。 (注:$\beta \in [0, 1]$ 是一个保留系数 ,通常设得很小。这就形成了一道保护屏障,让语法词免受重罚 )。
- 如果当前位置 $i$ 对应的是一个“高危历史语义词(如具体的物体名)”: 此时 $i \notin \mathcal{G}$,指示函数 $\mathbb{I} = 0$ 。 代入公式后,括号里变成了 $1 - 0 = 1$。 最终惩罚直接吃满:$\rhoi^{(t)} = \rho{\text{his}}^{(t)}$ —— 全额重罚,毫不留情 !
💰 终局:从历史打劫,全额返还视觉与指令
通过“时间 $\times$ 语义”双轴合围后,TSAI 在当前中深层网络中,成功拦截并抢救出了一大笔原本要浪费在历史语义词上的注意力总额 $S_{\text{his}}^{(l,t)}$ :
随后,这一大笔预算会立刻通过大一统公式(Eq. 6)执行双特征特征补偿(Dual Feature Compensation),全额原地分赃 :
- 分给当前的用户指令 $\mathcal{T}_{\text{ins}}$:把一部分额度均分给所有指令 Token,强行锚定任务意图,防止模型看图太投入而发生“指令遗忘” 。
- 分给过滤后的视觉特征 $\mathcal{T}_{\text{img}}^*$:利用 PGF(预充填引导过滤) 机制 ,不把额度胡乱分给全图的背景噪声(比如空白墙壁、天空) ,而是根据初始 Prefill 阶段的眼动规律 ,只精准加到那些包含核心物体的 Top-k 高显著性视觉 Token($\mathcal{T}_{\text{img}}^*$)的格子里 。
做完这个大手术后,注意力向量 $\hat{A}^{(l,t)}$ 重新归一化 ,随后乘以当前层的 $V$ 矩阵 。
4. 统一干预公式与双特征特征补偿 (Unified Formulation)
现在,算法手里拿着两笔“巨款”:浅层从系统词抠出来的 $S{\text{sys}}$ ,以及中深层从历史语义词精准打劫来的 $S{\text{his}}$ 。
为了把这些额度聪明地还给图像($\mathcal{T}{\text{img}}$)和指令($\mathcal{T}{\text{ins}}$),作者提出了最终的注意力统一加性更新公式(针对任何目标 Token $j$):
在这个最终大一统公式里,作者完成了最妙的重新分配:
- 指令特征补偿($\Delta_{\text{ins}}^{(l,t)}$):把两笔钱中分给指令的部分合并,无缝补偿给指令 Token,彻底防止大模型只看图而“忘记任务意图” 。
- 图像预选过滤补偿($\mathcal{T}_{\text{img}}^*$):在深层往图像补注意力时,作者又贴心地加了一个 PGF(预充填引导过滤) 机制 。它不把额度胡乱分给全图的背景噪声,而是利用 Prefill 阶段的先验,只精准补偿给排名前 $k$ 的高显著性物体视觉 Token($\mathcal{T}_{\text{img}}^*$) 。
更新完毕后,代码会对整根 $\hat{A}^{(l,t)}$ 向量进行最后一步数值重新归一化(Re-normalization),保证分数值加起来重新等于 1,完美输送给下一步的 $V$ 矩阵相乘 。
Experiments
Decoding Overhead (解码开销分析)
这是 TSAI 最值得骄傲的物理防线。许多号称能缓解幻觉的方法,在实际落地时因为“推理太慢”根本没法商用。作者通过 Table 2 的前向传播次数($N_{\text{forward}}$)对比,扒下了前作们的效率底裤 。
我们来看一下论文中 Table 2 的数据分布和背后的本质含义 :
| 方法 (Method) | 核心范式 (Paradigm) | 生成每 Token 所需前向传播次数 (Nforward) |
|---|---|---|
| Vanilla | 标准贪婪解码 (Standard) | 1 |
| DoLa / DeCo | 层间对比流派 (Layer Contrastive) | 1(但需要层间隐藏状态追踪或回溯修正) |
| AttnReal | 注意力干预流派 (Attention-based) | 1 |
| Ours (TSAI) | 本文方法 (Attention-based) | 1(与标准 Vanilla 完全一致,零额外开销!) |
| VCD / PAI / CODE | 传统对比解码 (Contrastive) | 2(每吐一个字都必须跑 Expert 和 Amateur 双路前向) |
| OPERA | 回溯分配流派 (Retrospection) | $n \ (\ge 5)$(一旦触发局部循环,需要不断把序列回滚并重新计算) |
🔍 为什么 TSAI 能够死死守住 $N_{\text{forward}} = 1$ 的底线?
通过我们在 Method 章节里死磕的底层逻辑,你现在看这个表一定会产生降维打击的顿悟:
- 以 VCD、PAI 或者是 CODE 为代表的流派,因为必须要在“有图事实”和“无图/噪图先验”两个平行宇宙里反复对比 ,所以它们每吐一个字,模型都必须雷打不动地跑 2 次前向传播 ,推理延迟直接翻倍 !
- OPERA 更不用说了,遇到幻觉苗头就得序列回滚(Sequence Rollback)退回去重写 ,跑一次前向的代价甚至超过 5 次 ,极其卡顿 。
而 TSAI 框架是在同一个 forward 函数内部,直接在算好的 Softmax 注意力矩阵上做“原地切片、原地相加”的纯数学加减法 。它没有开辟第二条平行宇宙通道(无需跑第二次前向) ,也没有任何打断、退回和重写的动作 。因此,它完美保住了 $N_{\text{forward}} = 1$ 的原生速度 。
rebuttal
针对“相比前作 AttnReal 概念创新性不足”的问题
- 审稿人(Reviewer VX7Z, 15M9)质疑:TSAI 同样是在 Softmax 之后原地做注意力重新分配,核心贡献看起来只是公式微调,有夸大创新之嫌。
- 你的回复:直接阐明本质差异(解耦)。AttnReal 隐式地假设 Token 在时空上是同质的,而 TSAI 首次打破了这一假设,提出了4 维上下文空间注意力分配;TSAI 首次实现了对系统词(System Tokens)\中被困注意力的回收利用,且通过消退实验证明了*双特征特征补偿*显著优于单向视觉注入。
针对“单次前向传播并不等同于真正低开销”的问题
- 审稿人(Reviewer p1hu)质疑:Table 2 只数了前向传播次数,没有实际的时间运行延迟和显存开销。
- 你的回复:直接抛出物理硬核数据:TSAI 的逐 Token 推理延迟为 $46.67 \pm 2.74$ 毫秒,相比于原生 Baseline($31.78 \pm 2.20$ 毫秒)属于完全可接受的微弱增加;而作为交换,显存和内存占用增加极小,仅仅增加了几十个 KB,完全不构成算力瓶颈。
针对“如果固定文本生成长度为 64,结果会怎样”的问题
- 审稿人(Reviewer VX7Z)质疑:在不同输出长度下,模型的表现和评估指标是否依然鲁棒?
- 你的回复:补做实验证明稳健性。即使在生成的文本被强制截断为 64 个 Token 的严苛场景下,TSAI 在 LLaVA-1.5 上的 CHAIR_S / CHAIR_I 指标依然以 27.20 / 8.69 完爆原生模型的 44.00 / 13.66,同时 F1 分数(75.15 vs 73.96)依然逆势反超。
长文本后期单调递增惩罚是否会导致模型失忆、失去连贯性
代表语言长文本连贯性与质量的综合指标 F1 Score,TSAI 依然以 75.15 逆势反超了原生模型的 73.96。这用铁打的数据直接回击了审稿人——即便在长文本生成的后期,模型的长上下文连贯性和语言组织能力不仅没有发生任何“因为打压历史而崩溃失忆”的现象,反而表现得更加稳健和清醒。