论文阅读——ReAct
背景
作者指出,当时的大语言模型研究在“推理”和“行动”两个方向上各自取得了一定进展,但都存在明显的短板:
| 范式 | 代表技术 | 工作机制 | 致命缺陷 / 局限性 |
|---|---|---|---|
| 纯推理范式 (Reason-Only) | Chain-of-Thought (CoT) | 提示模型生成多步思维链来推导答案(如数学、逻辑题)。 | 静态黑盒,未接地(Ungrounded):仅依赖模型内部参数,无法与外部世界交互更新知识。极易导致事实幻觉(Fact Hallucination)和错误累积(Error Propagation)(见 Figure 1 (1b))。 |
| 纯行动范式 (Act-Only) | 机器人规划、Web 导航 agent | 将环境观测转化为文本,利用 LLM 先验生成具体动作计划。 | 缺乏高层规划与工作记忆:不使用语言进行抽象高层目标推理,无法维护工作记忆,难以在复杂交互中维持长 |
ReAct 范式的提出
为了打破这种割裂,作者提出了 ReAct(Reason + Act):
1 | ┌─────────────────────────┐ |
- Reason to
Act(推理指导行动):利用思考轨迹(Thoughts)来创建、维护和调整高层的行动计划。
- Act to Reason(行动支持推理):利用行动(Actions)与外部环境(如 Wikipedia、网页环境)交互,将获取的新信息反馈给后续推理步骤。
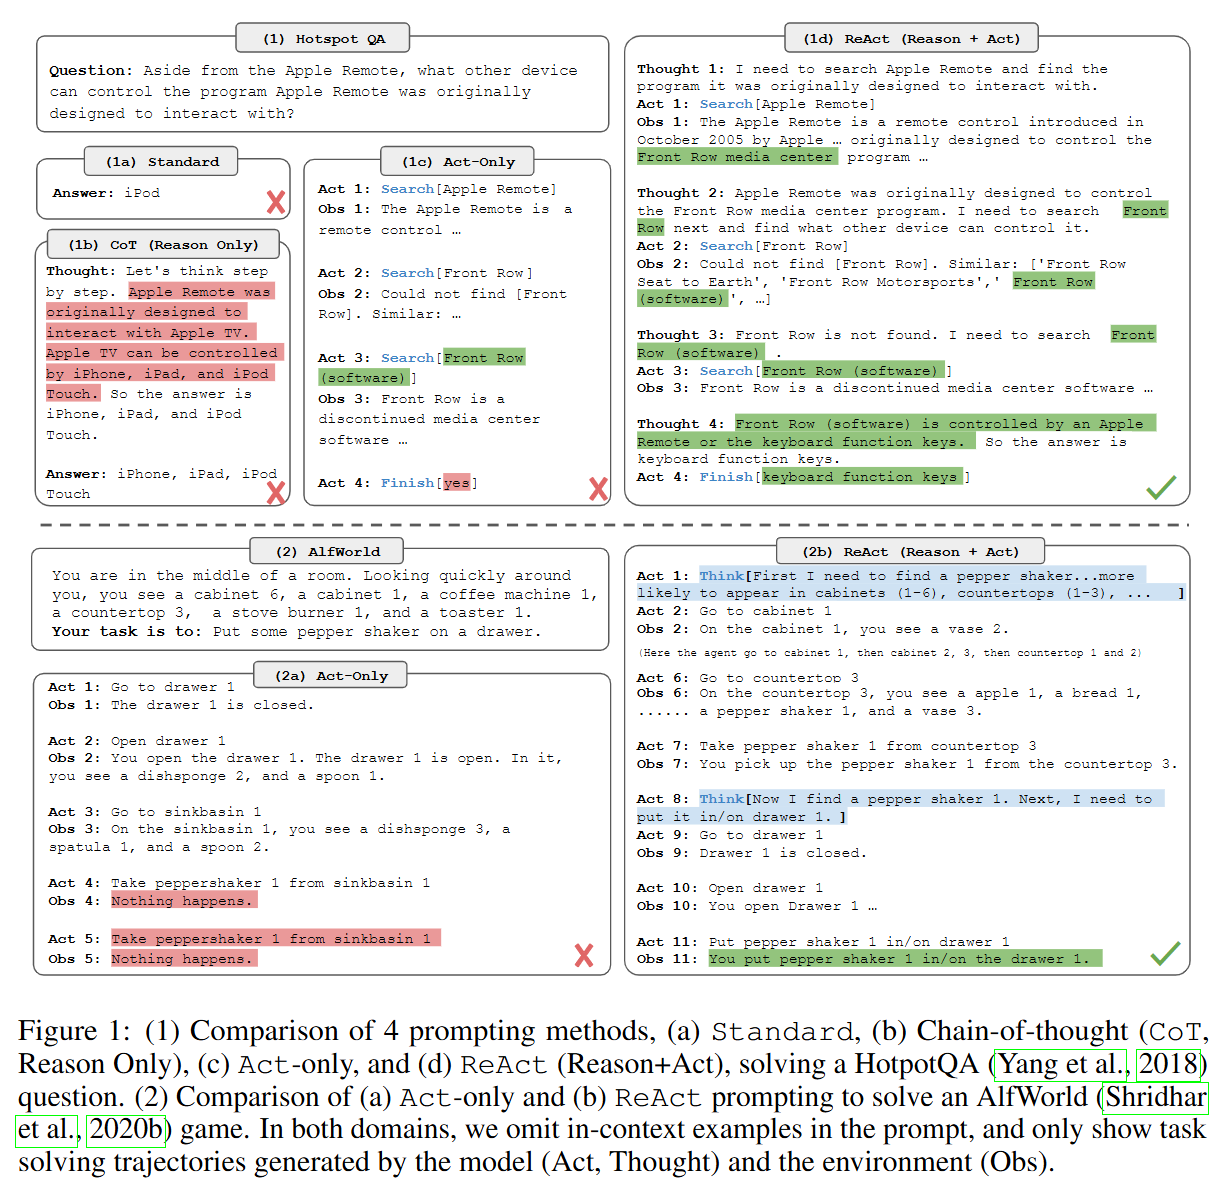
1. 上半部分:Hotpot QA(知识密集型问答任务)
- 任务问题:“除了 Apple Remote,还有什么设备可以控制 Apple Remote 最初设计用来交互的那个程序?”
| 方法范式 | 表现与执行路径 | 结果与失败原因分析 |
|---|---|---|
| (1a) Standard (标准回答) | 直接预测:iPod |
错误 ×:模型无法直接凭空猜出多步跳跃(Multi-hop)的复杂事实。 |
| (1b) CoT (纯推理/思维链) | 思考:“Apple Remote 最初是用来控制 Apple TV 的,而 Apple TV 可以被 iPhone/iPad 控制……” | 错误 ×(产生幻觉):模型依靠内部知识“闭门造车”,第一步就记错了事实(其实是 Front Row 程序),导致错误传导与严重幻觉。 |
| (1c) Act-Only (纯行动无思考) | Act 1: 搜索 Apple Remote → 观察到程序叫 Front Row; Act
2: 搜索 Front Row → 提示未找到; Act 3/4:
盲目搜索词项并直接结束。 |
错误 ×(陷入盲目):缺乏高层推理指导。当搜索遇到阻碍(搜索不到精确词项)时,无法分析原因,也不知道如何修正搜索关键词。 |
| (1d) ReAct (推理 + 行动) | Thought 1: 决定先搜 Apple Remote 找程序名;
Act 1 + Obs 1: 查到程序是 Front Row;
Thought 2 + Act 2 + Obs 2: 搜 Front Row
没找到,思考分析原因; Thought 3 + Act
3: 动态修正关键词搜
Front Row (software),成功查到; Thought 4 + Act
4: 提炼出答案并输出 keyboard function keys。 |
正确 ✓(闭环纠错):用思考指导检索方向,用检索结果验证并矫正思考,完美避开了幻觉与盲目。 |
2. 下半部分:ALFWorld(交互式具身决策任务)
- 任务目标:“把胡椒粉瓶(pepper shaker)拿到抽屉(drawer)里。”
| 方法范式 | 表现与执行路径 | 结果与失败原因分析 |
|---|---|---|
| (2a) Act-Only (纯行动) | Act 1-3: 去开抽屉 1,又跑去水槽 1; Act
4-5: 在没有看到胡椒瓶的情况下,强行尝试执行
Take peppershaker 1。 |
错误 ×(无效交互):系统不断提示
Nothing happens。模型失去了工作记忆,既不知道物品常识分布在哪,也记不住自己当前做到了哪一步。 |
| (2b) ReAct (推理 + 行动) | Act 1 (Think): 引入常识推理——“胡椒瓶最可能出现在柜子(1-6)或台面(1-3)”; Act 2-7: 有针对性地逐个检查,顺利在台面 3 找到并拿到胡椒瓶; Act 8 (Think): 追踪进度——“现在已拿到胡椒瓶,下一步该去放进抽屉 1”; Act 9-11: 前往 drawer 1,打开并成功放入。 | 正确 ✓(高效规划):推理提供了常识先验(去哪里找)和状态跟踪(当前完成了什么子目标),大幅提升了长流程决策的成功率。 |
知识密集型推理任务
什么是“知识密集型推理任务”?
我们可以把这种任务拆成两部分来理解:
- “知识密集”(Knowledge-Intensive):
- 意味着解决任务极其依赖海量、精准的外部事实知识(如具体的人物生卒年份、地理位置、历史事件、作品名称等)。
- 单凭模型自身的参数记忆(内部知识),极易因记忆模糊或知识过期而产生事实幻觉(Hallucination)。
- 意味着解决任务极其依赖海量、精准的外部事实知识(如具体的人物生卒年份、地理位置、历史事件、作品名称等)。
- “推理”(Reasoning):
- 意味着单靠简单的“关键词检索”或“直接查一次百科”是拿不到答案的。
- 它需要模型具备多步骤的逻辑拆解、信息聚合、常识判断与比较的能力(如:先查出 A 的身份,再根据身份去查 B,最后对比 A 和 B 的出生年份)。
- 意味着单靠简单的“关键词检索”或“直接查一次百科”是拿不到答案的。
两大测试基准(Domains)
1. HotpotQA(多跳问答基准)
任务类型:多跳复杂问答(Multi-hop Question Answering)。
核心特点:
“多跳”(Multi-hop) 指的是解答一个问题不能只查一个实体,而是需要跨越两个或更多个 Wikipedia 页面进行“跳跃式”的信息接力。
典型示例:
问题:“除了 Apple Remote,还有什么设备可以控制 Apple Remote 最初设计用来交互的那个程序?”
- 第 1 跳(查找中间实体):先搜索
Apple Remote,查出它最初设计控制的程序叫 Front Row。
- 第 2 跳(关联推理与检索):再搜索
Front Row,查找还有哪些设备可以控制 Front Row。
- 最终合成答案:得出键盘功能键(keyboard function keys)。
- 第 1 跳(查找中间实体):先搜索
论文中的实验设定(Question-only Setup):
- 传统的 HotpotQA
评估有时会直接把相关文本段落喂给模型,但本论文采用仅给定问题(Question-only)的严苛设定。
- 模型一开始只收到一句话问题,没有任何参考文档。它必须完全依靠 ReAct 机制,自己决定何时去搜索 Wikipedia API、搜什么词、如何根据观察结果(Observation)展开下一轮思考与搜索。
- 传统的 HotpotQA
评估有时会直接把相关文本段落喂给模型,但本论文采用仅给定问题(Question-only)的严苛设定。
2. FEVER(事实核查与验证基准)
任务类型:事实提取与验证(Fact Extraction and Verification)。
核心特点:
三分类判断:给出一个声明(Claim),要求模型结合 Wikipedia 事实,将其分类为以下三种结果之一:
SUPPORTS(支持):有明确的百科事实证明该声明为真。
REFUTES(反驳):有明确的百科事实证明该声明为假。
NOT ENOUGH INFO(信息不足):基于现有的百科信息无法判断真伪。
对细节极度敏感:
典型示例:
声明:“《怪奇物语》(Stranger Things)的背景设定在印第安纳州的布卢明顿(Bloomington, Indiana)。”
- 检索与推理:搜索
Stranger Things后发现,剧集背景设定在印第安纳州的虚构小镇霍金斯(Hawkins, Indiana),而不是布卢明顿。
- 最终结论:判别为
REFUTES。
- 检索与推理:搜索
为什么适合验证 ReAct:
- FEVER 任务中
SUPPORTS和REFUTES往往只差一两个关键词或数字细节。如果模型单凭凭记忆“硬猜”(CoT),极其容易记错或产生幻觉;只有通过 ReAct 去实时查阅 Wikipedia,才能做到精准把关。
- FEVER 任务中
基线(Baselines)构建
在 ReAct 论文中,CoT(思维链)和 Act-Only(纯行动)作为对比基线,确实都是通过消融(Ablation)和修改 Few-shot Prompt(少样本提示词)中的示例格式来实现的。
| 提示词方法 | Prompt 中保留的组件 | 实现方式(对 ReAct 轨迹的处理) | 作用与定位 |
|---|---|---|---|
| ReAct | Question + Thought +
Action +
Observation + Answer |
完整保留:交替生成思考与行动。 | 本文核心方法(推理 + 行动闭环) |
| CoT (Reason-Only) | Question + Thought +
Answer |
剥离 Action & Observation:删掉所有与外部 API/环境交互的步骤,只保留纯文本推导。 | 纯思考基线(评估仅靠内部记忆推导的表现) |
| Act-Only | Question + Action +
Observation + Answer |
剥离 Thought:删掉所有 Thought
思考语句,只保留环境动作和观察反馈。 |
纯行动基线(评估无规划、直接盲目操作的表现) |
| Standard | Question + Answer |
剥离 Thought, Action & Observation:删掉所有中间过程,直接给答案。 | 标准提示基线(直出答案) |
内部与外部知识的动态融合机制(Combining Internal & External Knowledge)
作者在分析中发现:
- ReAct
擅长结合外部知识,事实接地性(Groundedness)极强,但在遭遇复杂逻辑时,格式约束可能会稍微限制其推导灵活性。
- COT 擅长构建流畅的逻辑推理架构,但极其依赖模型内部记忆,容易发生事实幻觉(Hallucination)。
启发式退避规则(Back-off Heuristics)
作者设计了两种双向退避(Back-off)策略,由模型在运行过程中根据“置信度”或“步数限制”动态决定何时切换:
1 | ┌────────────────────────┐ |
策略 A:ReAct → CoT-SC(外部检索失败时,退回内部思考)
- 触发条件:先使用 ReAct 尝试与外部 Wikipedia API
交互。若 ReAct 在达到最大允许步数上限(HotpotQA 设为 7
步,FEVER 设为 5 步)后仍未给出答案;
- 动作:自动放弃 ReAct 交互,退避(Back-off)切换为
CoT-SC
模式,让大模型完全依靠自身的内部记忆与逻辑来硬拆并给出最终答案。
- 设计逻辑:如果外部搜索陷入死胡同或没查到关键词,与其直接报空失败,不如死马当活马医,信任模型自身的内部常识。
策略 B:CoT-SC → ReAct(内部推导自信度低时,退回外部检索)
- 触发条件:先对大模型运行 CoT-SC(采样 n 条思考轨迹,默认 n = 21
并取多数票)。如果在采样结果中,得票最高的那个答案,其票数占总采样数不到一半( < n/2);
- 动作:这说明模型内部知识非常犹豫、未能形成强共识(即内部置信度低),此时自动退避切换为
ReAct 模式,亲自去 Wikipedia 搜索验证。
- 设计逻辑:模型内部记忆有信心(投票集中)时就直接用 CoT-SC 输出;没信心(投票分散)时才去上网查,既省时又准确。