面经-计网
HTTP 全流程(从输入 URL 到页面呈现)
1 | [浏览器输入URL] |
URL 的标准解构:RFC 3986 规范
URL(Uniform Resource Locator,统一资源定位符)是 URI 的子集。标准通用格式如下:
1 | scheme:[//[user:password@]host[:port]][/]path[?query][#fragment] |
我们以一个复杂的企业级 URL 为例:https://admin:123456@api.example.com:8443/v1/models/chat?model=qwen&stream=true#token-usage
浏览器内核解析器会将其严格拆解为 7 个核心组件:
| 组件名称 | 示例中的内容 | 底层语义与作用 | 面试硬核考点 |
|---|---|---|---|
| 1. Scheme (协议方案) | https |
告诉客户端采用何种应用层及传输层协议与服务端交互(如 http, https, ftp, ws, file 等)。 |
决定了后续是走普通 Socket 还是先进行 TLS 握手,并确定默认端口(http 默认为 80,https 默认为 443)。 |
| 2. Userinfo (身份凭据) | admin:123456@ |
用户名和密码(早期 HTTP Basic Auth 规范)。 | ⚠️ 安全弃用:明文直接暴露在 URL 中极度不安全,现代浏览器基本已被废弃或发出强警告,但规范解析器仍需兼容。 |
| 3. Host (主机名) | api.example.com |
标识目标服务器的网络逻辑地址。可为域名、IPv4 地址(如 192.168.1.1)或 IPv6 地址(必须用方括号包围,如 [::1])。 |
这一步提取的值将作为接下来的 DNS 解析目标,并在随后的 HTTP 请求头中作为 Host: 标头发送(虚拟主机路由的核心依据)。 |
| 4. Port (端口号) | 8443 |
标识目标服务器操作系统上的具体网络进程/服务。 | 若 URL 中未显式指定,解析器会根据 Scheme 隐式自动补齐默认端口(HTTP 补 80,HTTPS 补 443)。 |
| 5. Path (资源路径) | /v1/models/chat |
标识服务器内部的具体逻辑资源或路由映射。 | 由 / 分隔的层级路径,服务端反向代理(如 Nginx location)与后端路由框架(如 FastAPI、Spring)据此分发请求。 |
| 6. Query (查询字符串) | ?model=qwen&stream=true |
客户端传递给服务端的动态键值对参数,以 ? 引导,& 分隔。 |
必须遵循百分号编码;解析后会转化为键值对映射表供后端读取。 |
| 7. Fragment (片段标识符 / Hash) | #token-usage |
页面内部的位置锚点或客户端路由状态。 | 🚨 极高频必考点:Fragment 绝对不会随 HTTP 请求发送给服务端!它完全停留在客户端浏览器内部。 |
DNS 递归与迭代解析
互联网的域名体系是自顶向下的树状层次结构:
- 根域名 (Root Domain):
.(通常在 URL 中被省略) - 顶级域名 (TLD, Top-Level Domain):
.com、.cn、.net、.org等 - 二级域名 (Second-Level Domain):
example.com、github.com - 三级/子域名 (Subdomain):
api.example.com、www.github.com
全链路解析时序图(递归 + 迭代):
1 | [浏览器] |
协议栈封装与下一跳寻址(TCP ➔ IP ➔ ARP 获取网关 MAC)
拿到目标服务器 IP 后,数据在真正被网卡物理发射出去之前,需要经过逐层协议封装与下一跳路由寻址。
- IP 与 MAC 地址的核心分工:
- IP 地址(网络层 / 逻辑地址):标定通信的终极目的地(如目标服务器公网 IP),在整个公网传输中全程保持不变。
- MAC 地址(数据链路层 / 物理地址):标定局域网内物理设备之间的下一跳交接棒,每经过一次路由器转发,下一跳的 MAC 地址都在不断被替换。
- 核心物理现实:主机网卡只能与局域网内的直连设备通信,物理上无法直接将电信号发射给千里之外的目标服务器网卡,因此第一跳必须发给身边的默认网关(路由器)。
- 自顶向下的协议栈封装(穿马甲):
- 传输层(TCP 首部 20 字节):封装源端口(内核分配的临时随机端口)和目的端口(80/443),加上序列号 Seq 和确认号 Ack,形成 TCP 报文段 (Segment)。
- 网络层(IP 首部 20 字节):封装源 IP(本机内网 IP)和目的 IP(服务器终极公网 IP),加上协议号 6 (TCP),形成 IP 数据报 (Packet)。
- 下一跳路由决策与 ARP 寻址:
- 跨网段判定:操作系统拿目标 IP 与本机子网掩码做与运算,判定目标服务器属于外网跨网段通信,依据路由表决定必须将数据首先交由默认网关(Default Gateway,如
192.168.1.1)转发。 - 目的 MAC 必须填网关 MAC:以太网帧头部的目的 MAC 绝不能填目标服务器的 MAC(跨网段根本接触不到),必须填写网关路由器的物理 MAC 地址。
- ARP 地址解析协议:
- 电脑首先查询本地内核 ARP 缓存表(
arp -a); - 若未命中,向局域网广播发送 ARP 请求报文(目的 MAC 为
FF:FF:FF:FF:FF:FF,询问“谁是网关 IP?请告诉我物理 MAC”); - 网关路由器收到后单播回复 ARP 应答报文,告知其物理 MAC(如
BB:BB:BB:BB:BB:BB),电脑将其写入缓存。
- 电脑首先查询本地内核 ARP 缓存表(
- 跨网段判定:操作系统拿目标 IP 与本机子网掩码做与运算,判定目标服务器属于外网跨网段通信,依据路由表决定必须将数据首先交由默认网关(Default Gateway,如
- 以太网帧组装与发射:
- 数据链路层组装以太网帧:目的 MAC 填网关 MAC、源 MAC 填本机 MAC,帧类型为
0x0800(IPv4),末尾附加 4 字节 FCS (CRC32) 差错校验; - 物理层网卡将帧转化为电信号/光脉冲发出;网关路由器接收后拆掉以太网头,根据 IP 头查询全局路由表,换上新的下一跳 MAC 继续接力转发(内层的源 IP 和目的 IP 全程保持不变)。
- 数据链路层组装以太网帧:目的 MAC 填网关 MAC、源 MAC 填本机 MAC,帧类型为
UDP(User Datagram Protocol)用户数据报协议
UDP(用户数据报协议)是传输层一个“无连接、不可靠、面向报文”的轻量级传输协议。
核心特点
- 无连接、零握手 (0-RTT):
- 发送数据前无需经历三次握手,结束后无需四次挥手,即发即走,无建连延迟。
- 极简头部、极低开销:
- 报文头固定仅 8 字节(源端口、目的端口、长度、校验和),相比 TCP 至少 20 字节节省大量网络带宽。
- 无连接状态、支撑海量并发:
- 内核不维护复杂的连接状态机、重传定时器与滑动窗口,单机承载高并发 Socket 的能力远超 TCP。
- 面向报文、天然无粘包:
- 保留应用层数据包的物理边界,发多大就收多大,既不拆分也不合并,无粘包半包困扰。
- 尽力而为(实时性优先):
- 无确认应答(ACK)、无超时重传、无拥塞控制,网络拥堵时不主动退避降速,保障极致低延迟。
- 原生支持广播与组播:
- 不仅支持一对一单播通信,还原生支持一对多(组播)和一对全(局域网广播)。
典型应用场景
- 强实时音视频交互 (RTC):
- 典型如 WebRTC(腾讯会议、飞书、Zoom)、VoIP 电话。人类感官“宁可掉一帧,也不能卡一秒”,用 UDP 避免 TCP 丢包重传导致的画面冻结与延迟累积。
- 高频状态同步的竞技网游:
- 典型如王者荣耀、CS:GO、英雄联盟。玩家高频同步实时坐标(每秒 30~60 次),历史旧坐标丢包无需重传,直接消费最新帧,防止人物回拉瞬移。
- 轻量即时的一问一答服务:
- 典型如 DNS 域名解析 (53)(单次往返即搞定,省去 TCP 握手)、DHCP 动态分配 IP (67/68)(局域网广播寻址)、NTP 时间校准 (123)。
- 局域网设备自动发现:
- 典型如智能家居 mDNS、手机投屏(DLNA / AirPlay),利用 UDP 广播/组播一次性搜寻局域网内所有可用设备。
- 现代可靠传输底座 (HTTP/3 / QUIC):
- 利用 UDP 的灵活性在应用层重写连接、多路复用与抗弱网拥塞控制,彻底根治传统 TCP 队头阻塞。
深度思考:UDP 报文为什么必须很小?为什么“丢了也没关系”?
- 为什么 UDP 报文在工程上都很小?(避开致命的 IP 级分片):
- 理论上单包最大可达 64 KB,但工程实践中严格限制在 MTU(通常 1500 字节,扣除包头后小于 1472 字节,常控制在 1400 字节以内);
- 根本原因:UDP 报文若超过 MTU,底层 IP 协议就会强行分片。IP 分片极其脆弱,数十个分片中只要有任意一个在网络中丢失,整包数据全部报废。因此 UDP 必须保持“小报文”以彻底杜绝底层分片。
- 为什么在 UDP 场景下数据“丢了也没关系”?(时效性压倒一切):
- 数据的价值具有极强的时效性,随着时间流逝旧数据会迅速变成无价值甚至有害的垃圾;
- 竞技网游:玩家 10ms 前的旧坐标丢了无需重传,因为 15ms 的最新坐标马上就到;若重传旧坐标反而导致人物在屏幕上“反复瞬移回拉”;
- 音视频通话:丢掉一帧画面人眼可通过视觉暂留脑补,若为了重传导致画面停滞 1 秒,通话体验将彻底毁灭(“宁可掉一帧,绝不卡一秒”);
- DNS 查询:报文仅几十字节,超时直接重发一个新查询即可,无需在内核为单次请求维护复杂的重传状态机。
TCP(Transmission Control Protocol)传输控制协议
理解TCP和UDP协议的核心原理和区别_哔哩哔哩_bilibili
TCP(传输控制协议)是传输层一个“面向连接的、端到端绝对可靠的、面向全双工字节流”的传输协议。
核心特点
- 面向连接(有始有终):
- 通信前必须经过 三次握手 建立连接,结束后通过 四次挥手 优雅释放。
- 绝对可靠交付(不丢、不重、不乱):
- 依靠 校验和、序列号(Seq 解决乱序)、确认应答(ACK) 和 超时/快速重传机制,确保不可靠的底层网络中数据 100% 正确送达。
- 流量控制(滑动窗口 —— 防撑爆对端):
- 接收方根据自己当前缓冲区剩余大小,动态通告发送方“还能发多少字节”,防止把接收端撑爆。
- 拥塞控制(BBR/慢启动 —— 防堵死公网):
- 根据全网拥堵状况动态计算拥塞窗口,防止海量并发流量压垮主干路由器。
- 面向全双工字节流(带来粘包):
- 双向可同时独立收发;数据像自来水一样无边界,底层自由分拆合并,应用层需自行界定报文边界。
典型应用场景
- Web 网页与 API 交互:HTTP/1.1、HTTP/2、HTTPS 全站通信,要求 HTML、JS、图片及接口数据 100% 完整无缺。
- 数据库与远程连接:MySQL、Redis、PostgreSQL、SSH 远程终端,严禁任何指令与数据字节发生丢失。
- 文件传输与关键指令:FTP/SFTP 大文件下载、金融交易指令、邮件收发(SMTP/IMAP),要求端到端绝对准确。
流量控制(Flow Control)
- 流量控制的关键:在于接收方能处理多大的数据。
- 接收方能吃多少,发送方才能喂多少,绝不能把接收方撑爆。
- 接收方根据自己接收缓冲区的剩余大小,在回包中动态通告接收窗口(
rwnd),限制发送方的发送速率。
- 流量控制的核心是滑动窗口机制:
- 分别定义发送方和接收方的滑动窗口。
- 只有确定接收了数据、发回了 ACK,滑动窗口才向后滑动。
- 在滑动窗口基础上,引申出后退 N 帧协议 (GBN) 和选择重传协议 (SR):
- 后退 N 帧协议 (GBN):发送窗口大于 1,接收窗口等于 1。接收端只能按序接收,一旦中间丢包,后续到达的数据全部丢弃,发送方必须从丢包处开始把后面的帧全部后退重传。
- 选择重传协议 (SR):发送窗口大于 1,接收窗口大于 1。接收端有缓存可以暂存乱序到达的包,发送方只需要精准重传丢失的那一帧。
- TCP 的演进:基础 TCP 使用累计确认(类似 GBN),但接收端会把乱序包暂存到队列中;现代开启 SACK(选择性确认) 后,只重传真正丢失的段,本质上进化为了选择重传(SR)。
拥塞控制(Congestion Control)
核心作用与本质:
- 拥塞控制的作用是为了防止网络拥堵。
- 数据传输的过程中要经过多个路由器和交换机,若路由器的缓冲区满了,就会发生丢包。
- 为了防止这种情况,发送端内核在本地维护了一个关键状态变量:
cwnd(Congestion Window,拥塞窗口)。 - 最终发包上限必须同时受制于“接收方的胃口”和“马路的承载力”,实际发送窗口大小:
四大经典算法阶段(加法增大,乘法减小 AIMD):
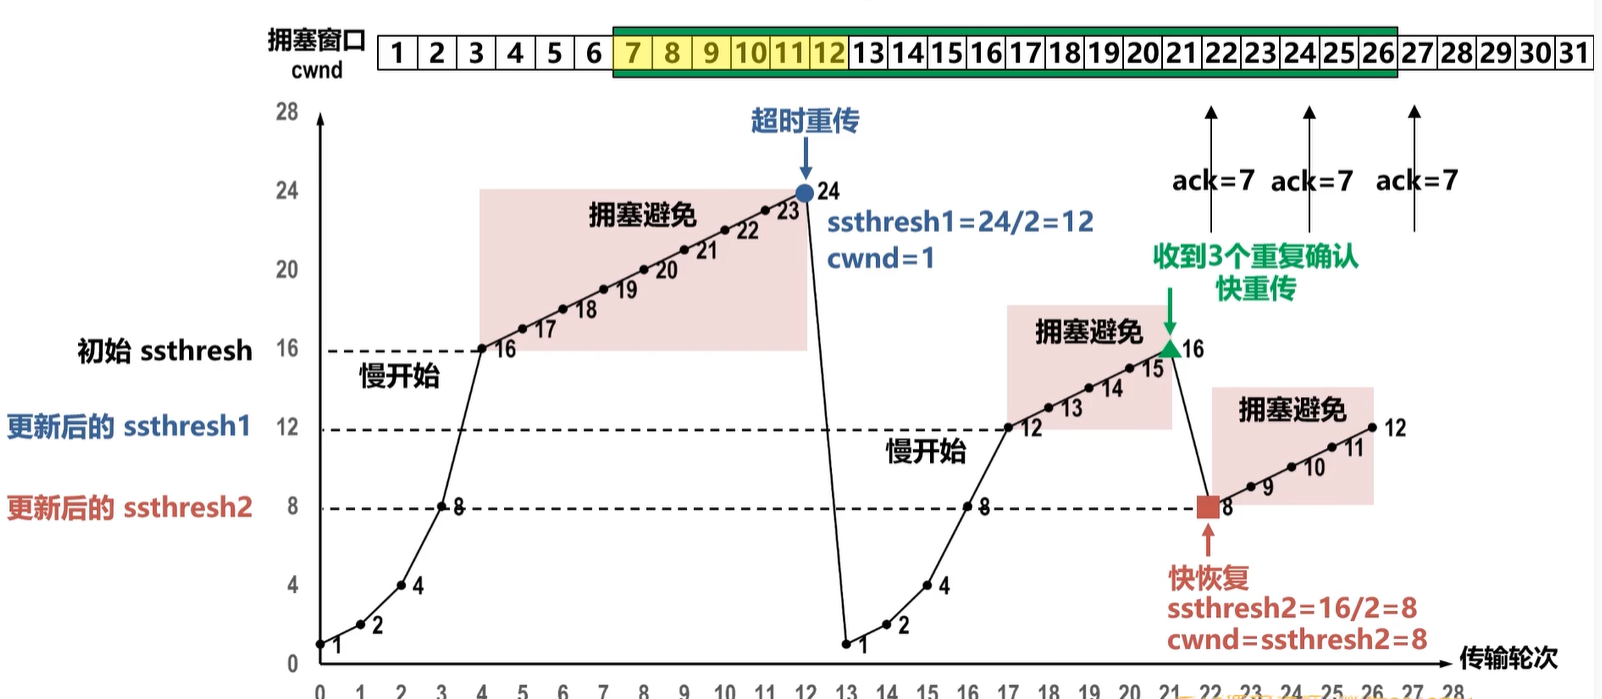
- 慢启动 (Slow Start):初始
cwnd很小(1~10 个 MSS),每收到一个 ACK 加 1,每个往返时间(RTT)翻一倍,呈指数级增长,快速试探空闲带宽。 - 拥塞避免 (Congestion Avoidance):当
cwnd >= ssthresh(慢启动阈值)时踩刹车,转为加法增大,每个 RTT 只线性增加 1 个 MSS,平缓摸索网络物理极限。 - 网络拥塞处理(丢包处置):
- 超时重传 (RTO 超时):恶性严重拥塞,阈值砍半(
ssthresh = cwnd / 2),cwnd直接被砸回 1,重新慢启动。 - 快速重传 (收到 3 个 Duplicate ACK):轻度拥塞,网络未瘫痪,立即重传缺失包,进入快速恢复。
- 超时重传 (RTO 超时):恶性严重拥塞,阈值砍半(
- 快速恢复 (Fast Recovery):阈值砍半(
ssthresh = cwnd / 2),设置cwnd = ssthresh + 3,绝不砸回 1,直接跳过慢启动从高位继续线性加法增大,维持高吞吐。
- 慢启动 (Slow Start):初始
深度思考:为什么 TCP 必须是字节流,而不能是报文?
- 避免全盘重传的灾难(细粒度重传):
- TCP 承载的数据量通常较大(Web 页面、大文件、数据库查询)。
- 若以“报文”为单位,一旦 10MB 的大报文在公网中丢失了某 1KB 片段,整整 10MB 就必须全部重传,公网带宽将瞬间被挤爆。
- 抽象为“字节流”后,TCP 将每个字节独立编号,哪一段(如第 1001~2000 字节)丢了,就精准只重传丢失的那一小段字节,极大降低重传代价。
- 赋予内核弹性调度的自由度:
- “报文”大小写死在应用层,而“字节流”没有物理边界;
- 内核可根据网络拥堵和滑动窗口弹性伸缩:链路通畅时把多个小写操作合并为大段(MSS 1460 字节)发出(Nagle 算法),网络拥塞时把大包拆碎成几十字节的小段发送,实现自适应流控。
套接字 Socket
1. 概念与本质
Socket(套接字)是由操作系统提供的一层抽象编程接口(API)。它将极其复杂的底层物理网络、协议栈(TCP/IP 状态机、滑动窗口、拥塞控制、丢包重传、路由寻址等)与硬件,全部封装在操作系统内核中,仅给上层应用程序暴露极其简洁统一的 API(如 socket()、bind()、listen()、accept()、send()、recv())。
- 用户态(程序员视角):表现为一个文件描述符 (FD),践行 Linux “一切皆文件” 哲学,读写网络与读写本地文件共用统一的 I/O 接口(
read/write)。 - 内核态(系统底层视角):是一个常驻内存的庞大数据结构实体(
struct socket/struct sock),内部封装了通信五元组、双向发送/接收缓冲区队列(sk_buff链表)、TCP 状态机、协议定时器、拥塞控制引擎及 epoll 等待队列。
2. Socket 的三大关键要素
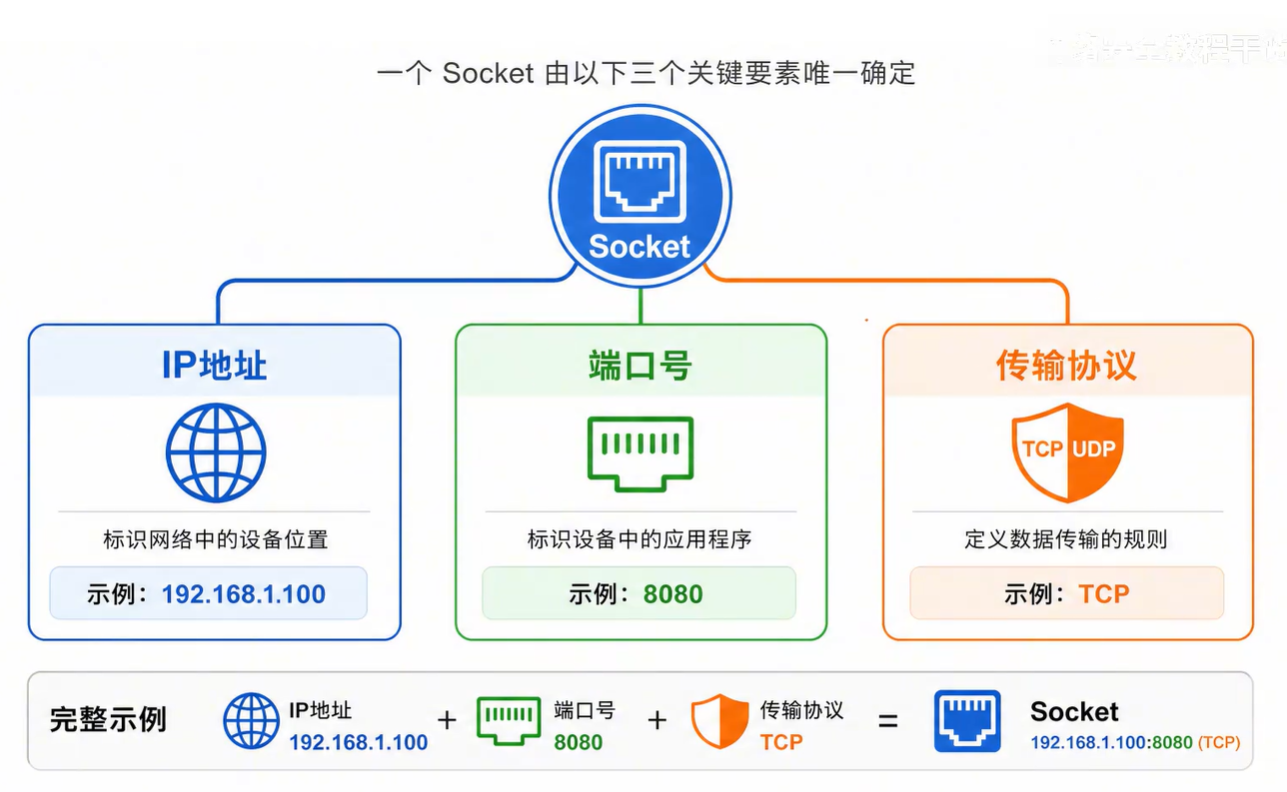
一个本地通信端点(Socket)在逻辑上由三大要素唯一确定:IP 地址 + 端口号 + 传输协议(例如:192.168.1.100:8080 (TCP))。
- IP 地址:标识网络中的设备位置(寻址);
- 端口号:标识设备中的具体应用程序进程(分流);
- 传输协议:定义数据传输的规则(TCP 或 UDP)。TCP 8080 与 UDP 8080 在内核中分属两张独立的哈希表,两者互不冲突。
3. TCP Socket 通信时序与 API 拆解
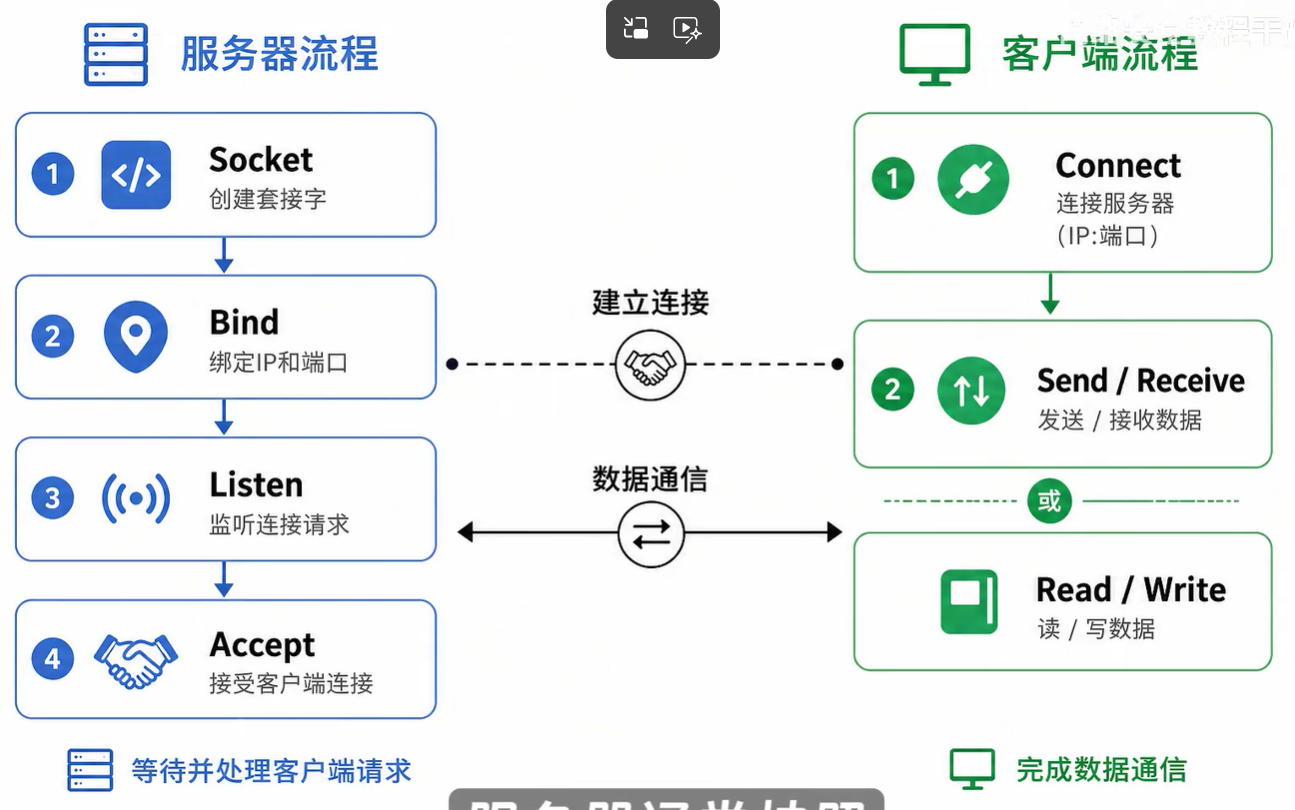
1 | 【服务端 Server】 【客户端 Client】 |
服务端核心流程(4 步):
socket()创建套接字:内核分配struct socket与struct sock结构体,此时为默认的主动套接字(Active Socket),初始状态为CLOSED。bind()绑定 IP 和端口:将套接字与物理网卡 IP 和固定服务端口绑定;若端口已被占用则报错EADDRINUSE。listen()监听连接请求(核心蜕变):- 角色由“主动”变为“被动监听”,状态变为
LISTEN; - 内核开辟两大核心队列:半连接队列 (SYN Queue) 暂存收到 SYN 后的半开连接;全连接队列 (Accept Queue) 存放三次握手彻底完成后的就绪连接(
backlog参数决定全连接队列上限)。
- 角色由“主动”变为“被动监听”,状态变为
accept()接受连接(产生专属套接字):- 绝不参与三次握手!三次握手完全由内核在底层自主闭环完成;
accept()仅负责从内核全连接队列中提取已完成握手的就绪连接;- 返回一个全新创建的已连接套接字(
conn_fd)与该客户端通信,原本的监听套接字继续守在大厅监听新连接。
客户端核心流程(2 步):
connect()发起连接:内核自动分配空闲临时端口,向服务端发送SYN报文触发三次握手;收到服务端SYN+ACK并回传ACK后,connect()成功返回,连接进入ESTABLISHED。send/recv或write/read数据通信:- 在 Linux “一切皆文件” 架构下,Socket 可直接使用通用文件接口
read/write读写; - 专用接口
send/recv多了flags控制标志位(如MSG_DONTWAIT非阻塞、MSG_PEEK预读不移出缓冲区、MSG_OOB带外紧急数据)。
- 在 Linux “一切皆文件” 架构下,Socket 可直接使用通用文件接口
分层模型
1 | OSI 七层模型 (理论标准) TCP/IP 四层模型 (工业界事实标准) 五层折中模型 (教学/面试经典) |
- OSI 七层参考模型:ISO 国际标准化组织提出的理论标准,划分细致,但因实现复杂、商业化滞后,成了“理论很丰满、现实没用上”的模型;
- TCP/IP 四层模型:工业界真实跑在互联网上的事实标准,将复杂的上三层统一合并为应用层,下两层合并为网络接口层;
- 五层原理模型:高校教学、408 考研及大厂面试最常用、最清晰的折中模型。
报文
我们在浏览器里访问网页,或者 Agent 调用大模型时,发送的 HTTP 请求就是一个最标准的应用层报文:
1 | ┌────────────────────────────────────────────────────────┐ |
这一整块包含请求行、请求头和请求正文的数据,合起来就构成了一个完整的 HTTP 请求报文。
服务器只有收到这样一个完整的报文,才能看懂你的意思并做出回答。
传输各层的“数据单位”叫什么?(术语避坑)
在五层网络协议栈里,数据每下沉一层,名字都会发生微妙的变化(面试经常考名词辨析):
| 层次 | 数据单位术语 | 英文名称 | 形象比喻 |
|---|---|---|---|
| 应用层 (Application) | 报文 | Message | 用户写的整封信(如 HTTP 报文、DNS 查询报文) |
| 传输层 (Transport) | 报文段 / 数据报 | Segment (TCP) / Datagram (UDP) | 传输层打上端口号后的包裹(UDP 数据报) |
| 网络层 (Network) | 分组 / 数据报 | Packet / IP Datagram | 网络层打上 IP 地址后的标准邮包 |
| 数据链路层 (Data Link) | 帧 | Frame | 局域网物理介质搬运的集装箱 |
| 物理层 (Physical) | 比特流 | Bits | 网线里跑的 0 和 1 电脉冲 |
HTTPS(HyperText Transfer Protocol Secure)超文本传输安全协议
HTTPS(HyperText Transfer Protocol Secure,超文本传输安全协议)并不是一个全新的应用层协议,它的本质是:披着 TLS/SSL 安全外衣的 HTTP。
1 | 【普通 HTTP 协议栈】 【安全 HTTPS 协议栈】 |
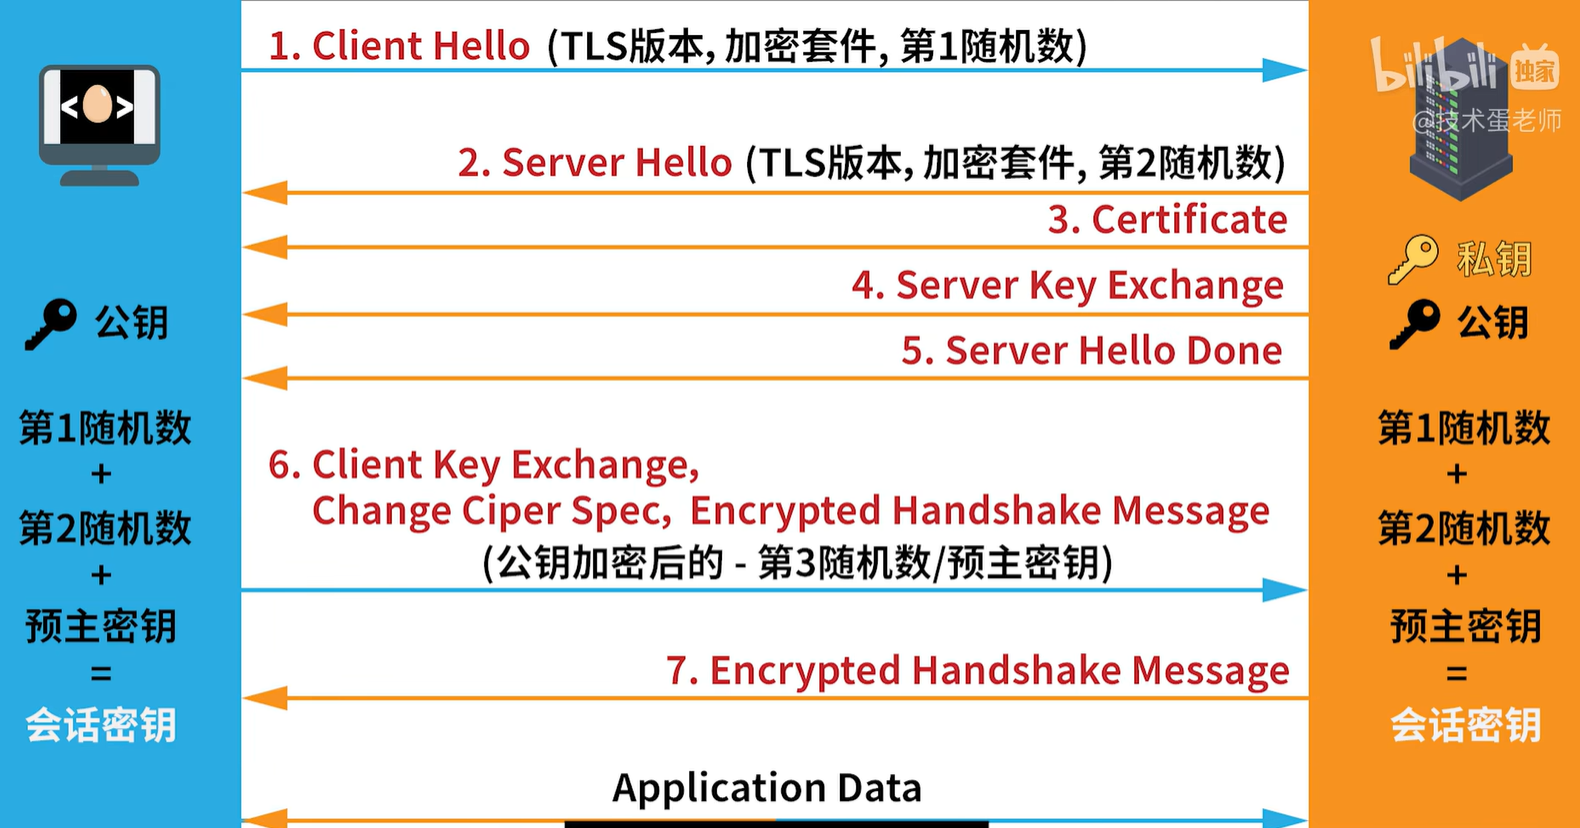
对称加密(Symmetric Encryption)
核心定义:加密和解密使用的是“同一把密钥(Secret Key)”。
- 密文 $C = \text{Encrypt}(\text{明文 } P, \text{密钥 } K)$
- 明文 $P = \text{Decrypt}(\text{密文 } C, \text{密钥 } K)$
1 | 【发送方 (Alice)】 【接收方 (Bob)】 |
- 核心优势:计算速度极快,CPU 硬件指令集(如 AES-NI)加速支持好,非常适合对网络大吞吐量数据进行全量加密。
- 致命缺陷:存在“密钥分发困难”(无法在不可信信道上直接传递钥匙)和“密钥管理数量随节点呈 $O(N^2)$ 平方级爆炸”的天然问题。
- 主流算法:AES(128/192/256 位,推荐 GCM 认证加密模式)、ChaCha20(移动端高效率流密码);历史上的 DES 与 3DES 已被淘汰。
非对称加密(Asymmetric Encryption)
核心理解:如果 A 想给 B 发消息,B 手上有一套公钥(公开)和一个私钥(保密)。用公钥加密的数据,只能用对应的私钥打开。B 先把公钥给 A,A 把想要传输的数据用 B 的公钥加密后发给 B,B 收到后再用自己的私钥解密。
1 | 【Alice 想发密文给 Bob】: |
- 核心原则:“想把秘密安全发给谁,就拿谁的公钥去加密;全世界只有接收方的私钥能解开”。
- 两大经典用法:
- 加密通信(公钥加密 ➔ 私钥解密):保障数据的机密性(防窃听);
- 数字签名(私钥签名 ➔ 公钥验签):保障发送方的身份真实性(防冒充、防篡改、防抵赖)。
- 优缺点分析:
- 优势:完美解决密钥分发难题,公钥可在不可信公网光明正大公开传播;
- 缺陷:计算极慢(涉及大数质因数分解或离散对数运算),比对称加密慢几百到上千倍,不能直接用来加密海量业务数据。