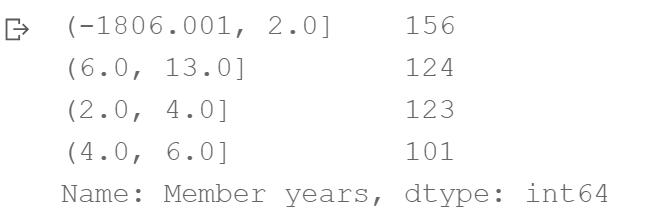机器学习——绪论
正文
参考文章
准确度(accuracy)、精确率(precision)、召回率(recall)、F1值 谈谈我的看法_recall f1-CSDN博客
南瓜书在线阅读:https://datawhalechina.github.io/pumpkin-book/#/
准确度(accuracy)、精确率(precision)、召回率(recall)、F1值 谈谈我的看法_recall f1-CSDN博客
南瓜书在线阅读:https://datawhalechina.github.io/pumpkin-book/#/

补全代码;
1 | import pandas as pd |
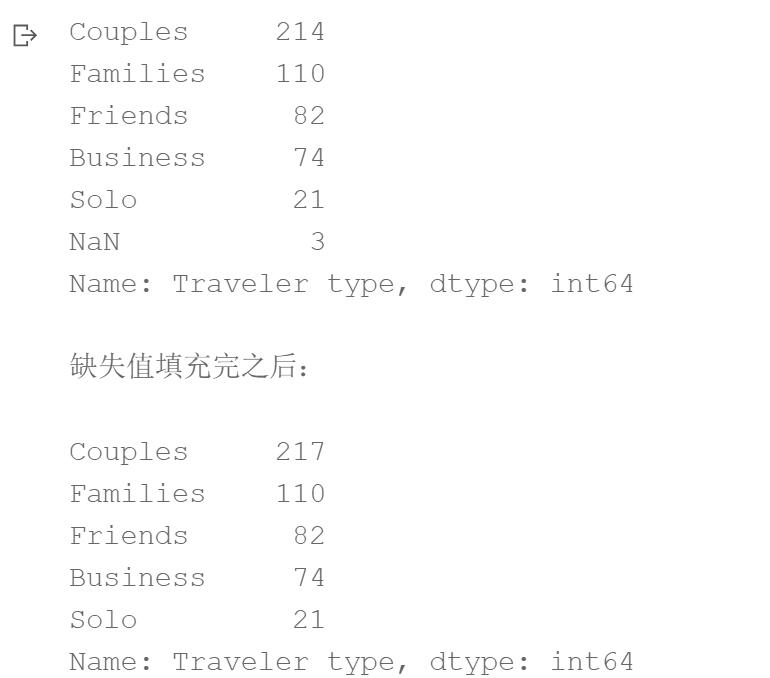
User continent North America 296 Europe 118 Oceania 41 Asia 36
Africa 7 South America 6 Name: count, dtype: int64 User
continent__Africa User continent__Asia User continent__Europe
0 False False False
1 False False False
2 False False False
3 False False True
4 False False False
.. … … …
499 False False True
500 False False False
501 False False False
502 False False False
503 False False False
User continent__North America User continent__Oceania
0 True False
1 True False
2 True False
3 False False
4 True False
.. … …
499 False False
500 True False
501 True False
502 True False
503 True False
User continent__South America
0 False
1 False
2 False
3 False
4 False
.. …
499 False
500 False
501 False
502 False
503 False
[504 rows x 6 columns]
补全代码:
1 | import pandas as pd |
补全代码:
1 | import pandas as pd |
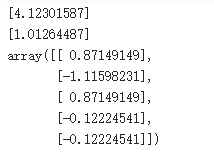
[4.12301587] [1.01264487]
array([[ 0.87149149], [-1.11598231], [ 0.87149149], [-0.12224541], [-0.12224541]])
补全代码:
1 | import pandas as pd |
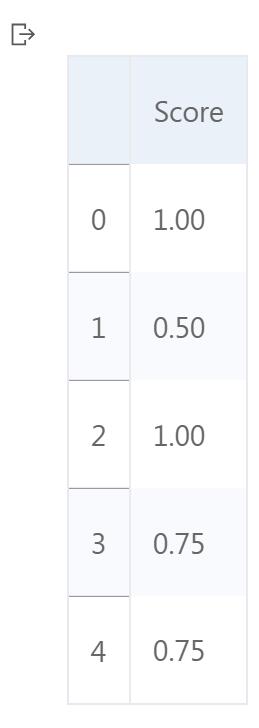
0 1.00 1 0.50 2 1.00 3 0.75 4 0.75 Name: Score, dtype: float64
补全代码
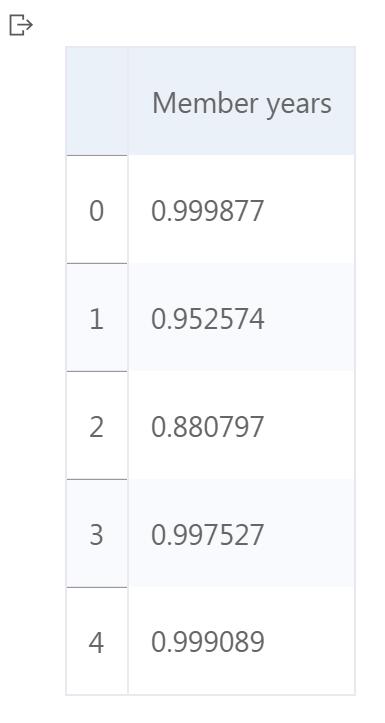
1 | #ogistic 标准化(Logistic Normalization)是一个将数据转换为 (0, 1) 范围的过程, |
0 0.999877 1 0.952574 2 0.880797 3 0.997527 4 0.999089 Name: Member years, dtype: float64
补全代码:
1 | import pandas as pd |
Member years (-1806.001, 2.0] 156 (6.0, 13.0] 124 (2.0, 4.0] 123 (4.0, 6.0] 101 Name: count, dtype: int64
补全代码:
1 | import pandas as pd |
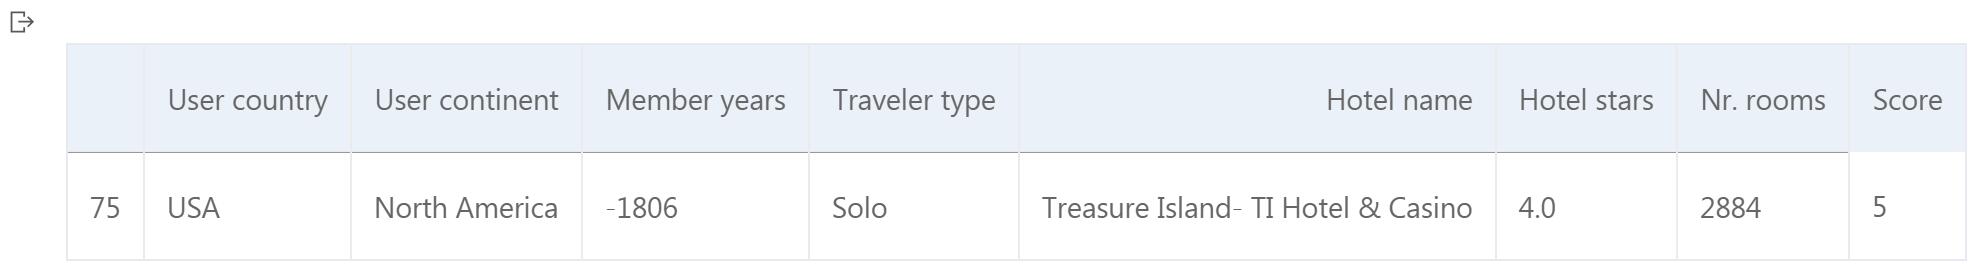
User country User continent Member years Traveler type
75 USA North America -1806 Solo
143 USA North America 13 Couples
Hotel name Hotel stars Nr. rooms Score
75 Treasure Island- TI Hotel & Casino 4.0 2884 5
143 Caesars Palace 5.0 3348 4
包括数据准备、模型训练、模型评估与选择、性能度量、参数选择
波士顿房价预测是一个经典的机器学习任务,类似于程序员世界的“Hello World”。和大家对房价的普遍认知相同,波士顿地区的房价受诸多因素影响。美国某经济杂志登出波士顿房价数据集,该数据集包含506条观测信息,统计了13种可能影响房价的因素(输入变量)和该类型房屋的均价(输出变量),其中每条观测信息包含城镇犯罪率、一氧化氮浓度、住宅平均房间数、到中心区域的加权距离以及自住房平均房价等关于波士顿周边或者城镇房价的描述,期望通过分析影响波士顿房价的因素来构建房价预测模型。相关属性描述如下图所示,其中最后一项就是想要预测的房屋均价。
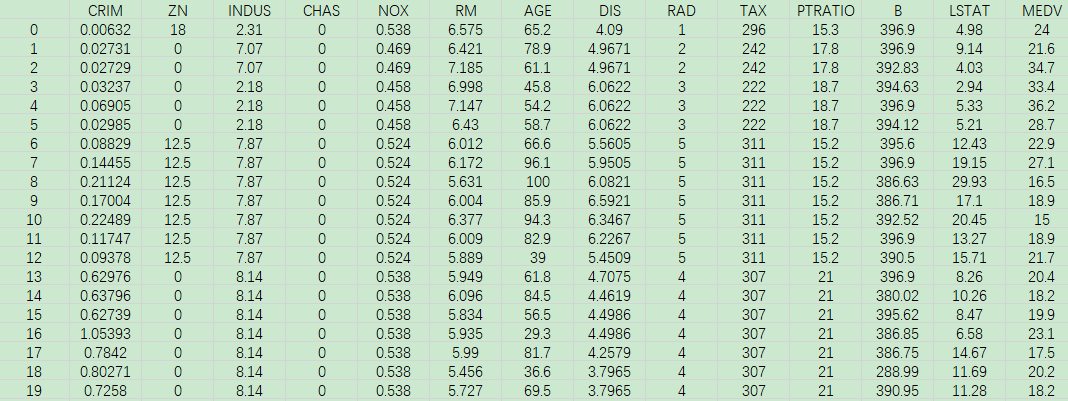
观测数据的示例如下图所示。
对于预测问题,可以根据预测输出的类型是连续的实数值,还是离散的标签,区分为回归任务和分类任务。因为房价是一个连续值,所以房价预测显然是一个回归任务。本次实验要求大家调用sklearn 的线性回归、岭回归模型来实现。
1 | from sklearn.datasets import load_boston |
通过观察不同属性与房价之间的关系,分析影响房价的主要因素。
boston.data 存储的是所有样本的属性值,boston.target 存储的是所有样本的房价。下段程序所展示的13幅图中,横坐标是该属性的取值,纵坐标是房价值。
1 | # 导入matplotlib库中的pyplot模块,用于绘制图表 |

调用sklearn.model_selection中的train_test_split()函数,把boston数据集分为训练集和测试集,划分比例是4:1。
补全代码:
1 | from sklearn.model_selection import train_test_split |
X_train:训练集的特征数据,形状为
(404, 13),即 80% 的数据(506 * 0.8 = 404
个样本),每个样本有 13 个特征。X_test:测试集的特征数据,形状为
(102, 13),即 20% 的数据(506 * 0.2 = 102 个样本)。y_train:训练集的目标值,形状为
(404,),即对应训练集的 404 个房价中位数。y_test:测试集的目标值,形状为
(102,),即对应测试集的 102 个房价中位数。train_test_split()
将数据集(包括特征和目标值)按照指定的比例随机划分为训练集和测试集。划分后的数据将用于模型的训练和评估,确保模型评估时使用的数据不会在训练过程中被“看见”。test_size=0.2 表示将 20% 的数据作为测试集,80%
的数据作为训练集。random_state=42
确保每次划分数据集时能得到一致的结果,保证实验的可复现性。首先使用StandardScaler()函数初始化对属性值的标准化器,然后调用fit_transform()方法对训练数据进行Z-score标准化,再将这个标准化器调用transform()方法用于测试数据的标准化。
补全代码:
1 | from sklearn.preprocessing import StandardScaler |
Z-score
标准化的过程是将数据转换为均值为0,标准差为1的分布。StandardScaler()
是 scikit-learn
提供的标准化工具,它通过去掉均值并除以标准差来实现这一标准化。
对训练数据进行标准化: -
1
X_train = ss_X.fit_transform(X_train)
fit():计算训练数据的均值和标准差。 -
transform():使用训练数据的均值和标准差将数据标准化。 -
fit_transform():这两个操作结合在一起,计算并转换训练数据,使其均值为0,标准差为1。
对测试数据进行标准化: -
对测试数据应用 1
X_test = ss_X.transform(X_test)
transform()
方法时,不会重新计算均值和标准差,而是使用在训练数据上计算得到的均值和标准差对测试数据进行转换。
-
这确保了测试数据的标准化是基于训练数据的统计信息,而不是测试数据本身的统计信息。
首先使用StandardScaler()函数初始化对属性值的标准化器,然后调用fit_transform()方法对训练数据进行Z-score标准化,再将这个标准化器调用transform()方法用于测试数据的标准化。
补全代码:
1 | from sklearn.preprocessing import MinMaxScaler |
在 MinMax 标准化(也称为
归一化)中,数据将被缩放到指定的最小值和最大值之间,通常是将数据缩放到
[0, 1]
范围内。这对于那些对特征的绝对范围敏感的算法非常有效。
MinMaxScaler 是 scikit-learn
提供的一个标准化工具,它会将每个特征缩放到一个指定的范围内,默认情况下是
[0, 1]。
对训练数据进行 MinMax 标准化: -
1
X_train1 = mm_X.fit_transform(X_train)
fit_transform()
方法会计算训练数据的最小值和最大值,并将数据缩放到 [0, 1]
范围内。 -
fit():计算训练数据的最小值和最大值。 -
transform():根据计算出的最小值和最大值,进行数据的转换。
- fit_transform()
是这两个操作的组合,直接返回标准化后的训练数据。
对测试数据进行 MinMax 标准化: -
1
X_test1 = mm_X.transform(X_test)
transform()
方法会使用训练数据上的最小值和最大值来转换测试数据。 -
注意:transform()
仅仅使用训练数据的统计量(即最小值和最大值)来对测试数据进行标准化,避免了数据泄露问题。如果对测试数据使用
fit_transform(),就会导致模型从测试数据中学习统计量,破坏了训练和测试数据的独立性。
MinMax 标准化是一种常用的数据预处理方法,尤其适用于特征的取值范围差异较大时。它将每个特征的最小值映射到 0,最大值映射到 1,其他值则在该区间内按比例进行缩放。这样做的好处是避免了某些特征因数值范围较大而在训练模型时占据主导地位,尤其是对于需要计算距离或内积的模型,如 KNN、SVM 等,使用 MinMax 标准化后的数据会使模型训练更加稳定。
调用sklearn.linear_model中的LinearRegression()函数,对训练集(X_train,y_train)进行模型训练,并预测测试集X_test的房价lr_y_predict。
补全代码:
1 | from sklearn.linear_model import LinearRegression |
训练模型: - 1
lr.fit(X_train, y_train)
fit()
方法会使用训练集数据 (X_train, y_train)
来训练线性回归模型。训练过程就是计算线性回归模型的系数(权重)和截距,以使预测值最接近真实目标值。
预测房价: - 1
lr_y_predict = lr.predict(X_test)
predict()
方法会使用已经训练好的模型来对测试集 X_test
进行预测,返回预测的房价(即预测值
lr_y_predict)。模型根据训练时学到的关系来预测测试集中的每个样本的房价。
回归模型常用的三种评价指标:(1)R方分数(决定系数)、(2)MSE均方误差、以及(3)MAE平均绝对误差。
方法一:调用sklearn.metrics中的相关函数,计算测试结果lr_y_predict与真实结果y_test之间的误差或精度。
1 | from sklearn.metrics import r2_score,mean_squared_error,mean_absolute_error |
the value of R-squared of LR is 0.7250808093832966
the MSE of LR is 23.56944609104811
the MAE of LR is 3.302381007591344
方法二:自己编写函数,计算上述指标。本实验要求学生至少完成MSE均方误差的计算,并打印输出结果。
1 | # 请在下方作答 |
R² (决定系数): 0.7250808093832966
MSE (均方误差): 23.56944609104811
MAE (平均绝对误差): 3.302381007591344
下面是 R²(决定系数)、MSE(均方误差) 和 MAE(平均绝对误差) 的计算公式:
R² 衡量模型对目标变量变化的解释程度。它的取值范围为 0 到 1,越接近 1,表示模型越能解释数据的变异性。
公式: $$ R^2=1-\frac{\sum_{i=1}^{n}(y_i-\hat{y}_i)^2}{\sum_{i=1}^{n}(y_i-\bar{y})^2} $$
MSE 衡量预测值与真实值之间差异的平方和的平均值,是一种常用的回归模型评估指标。
公式: $$ MSE = \frac{1}{n} \sum_{i=1}^{n} (y_i - \hat{y}_i)^2 $$
MAE 衡量预测值与真实值之间差异的绝对值的平均值,也是一种常用的回归模型评估指标。
公式: $$ MAE = \frac{1}{n} \sum_{i=1}^{n} |y_i - \hat{y}_i| $$
调用sklearn.linear_model中的Ridge()函数(参数设置为5),对训练集(X_train,y_train)进行模型训练,并预测测试集X_test的房价rd_y_predict。
补全代码:
1 | from sklearn.linear_model import Ridge |
[-0.89921997  1.17687007  0.06847273  0.58380163 -2.09273127  2.39227753
  0.15081088 -3.06269707  2.53630955 -1.8549535  -2.24256957  0.89722135
 -3.79040179]
岭回归(Ridge Regression),又称 L2 正则化回归,是一种扩展了普通最小二乘回归(OLS)的回归模型。其核心思想是在最小化 残差平方和(即普通最小二乘回归的目标函数)的同时,加入一个 正则化项,用于惩罚模型的复杂性,避免过拟合。
岭回归的目标函数为: $$ \text{minimize} \quad \left( \sum_{i=1}^{n} (y_i - \hat{y}_i)^2 + \alpha \sum_{j=1}^{p} \beta_j^2 \right) $$ 其中:
与线性回归一样,岭回归模型有两种方法计算评价指标,这里调用sklearn.metrics来实现。
1 | from sklearn.metrics import r2_score,mean_squared_error,mean_absolute_error |
the value of R-squared of Ridge is 0.7279447933421523
the MSE of Ridge is 23.323910246960786
the MAE of Ridge is 3.2535718613670053岭回归模型参数是正则化参数alpha,前面把它设置为5。为了选择最优参数,对训练集进行10次10折交叉验证。具体地,参数选择在[0,10]范围内,以1为步长,进行选择。 1. 总共进行11次实验(不同alpha值),每次实验将训练数据随机分成10份,重复10次; 2. 每一次划分,任意9份做训练,剩余1份测试,共执行10次,测试结果取平均; 3. 再将所有划分的结果再取平均,作为这一次alpha取值的分数; 4. 比较不同alpha取值的交叉验证模型分数,来选择其中表现最好的(分数最高的)模型的alpha值; 5. 用上述选择的alpha值对训练数据重新训练模型,再测试评估。
补全代码:
1 | from sklearn.model_selection import cross_val_score |
Best Alpha: 4
Mean Squared Error: 23.35986469628359
Mean Absolute Error: 3.260923268350155为了了解分类问题的建模与评估,本任务将连续值的波士顿房价数值使用阈值进行二值化(0,1,例如:廉价房、品质房),可以将房价预测的回归问题,改为简单的二分类问题。
同样是包括四个步骤:数据准备、数据预处理、模型训练、模型评估与选择。
下面的程序使用方法一调用sklearn.metrics中的相应函数计算预测结果的准确率accuracy、f1 score、auc值。
1 | from sklearn.datasets import load_boston |
The accuracy score of LR is 0.9117647058823529
The f1 score of LR is 0.8695652173913043
The auc of LR is 0.89002079002079


f:\project python\.conda\lib\site-packages\sklearn\utils\deprecation.py:87: FutureWarning: Function load_boston is deprecated; `load_boston` is deprecated in 1.0 and will be removed in 1.2.

    The Boston housing prices dataset has an ethical problem. You can refer to
    the documentation of this function for further details.

    The scikit-learn maintainers therefore strongly discourage the use of this
    dataset unless the purpose of the code is to study and educate about
    ethical issues in data science and machine learning.

    In this special case, you can fetch the dataset from the original
    source::

        import pandas as pd
        import numpy as np

        data_url = "http://lib.stat.cmu.edu/datasets/boston"
        raw_df = pd.read_csv(data_url, sep="\s+", skiprows=22, header=None)
        data = np.hstack([raw_df.values[::2, :], raw_df.values[1::2, :2]])
        target = raw_df.values[1::2, 2]

    Alternative datasets include the California housing dataset (i.e.
    :func:`~sklearn.datasets.fetch_california_housing`) and the Ames housing
    dataset. You can load the datasets as follows::

        from sklearn.datasets import fetch_california_housing
        housing = fetch_california_housing()

    for the California housing dataset and::

        from sklearn.datasets import fetch_openml
        housing = fetch_openml(name="house_prices", as_frame=True)

    for the Ames housing dataset.
  warnings.warn(msg, category=FutureWarning)
方法二:自己编写函数,计算上述指标。
本实验要求学生至少完成accuracy与f1 score的计算,并打印输出结果。
1 | # 请在下方作答 |
Accuracy: 0.9117647058823529
F1 Score: 0.8695652173913043准确率是正确分类的样本数与总样本数之比。
公式: $$ \text{Accuracy} = \frac{\text{正确预测的数量}}{\text{总样本数}} $$
F1 分数是准确率 (Precision) 和召回率 (Recall) 的调和平均数。
公式: $$ F1 = 2 \times \frac{\text{Precision} \times \text{Recall}}{\text{Precision} + \text{Recall}} $$ 其中: $$ \text{Precision} = \frac{\text{True Positive}}{\text{True Positive} + \text{False Positive}} $$
$$ \text{Recall} = \frac{\text{True Positive}}{\text{True Positive} + \text{False Negative}} $$
AUC 是 ROC 曲线下面积,用于衡量分类模型的性能,范围在 0 到 1 之间,越接近 1,模型表现越好。AUC 是一个广泛使用的评估二分类问题模型的性能的指标。
今天是2025年3月5日,是我的20岁生日,现在是9点45分,刚上完算法课,逃了上机课来到了机房,在开始一天的学习之前,我还是决定写一篇随笔记录一下自己的心情,或许多年之后,我已经忘记当时的心情,但这些文字会保留下来,会见证我的成长。
小时候,或许人人都希望生日到来的那一天,因为生日的到来意味着成长,代表着长大成人,当时的自己得知自己又成长了一岁,心中确实是喜悦的;但今日的我,却没有了这份喜悦,换来的是感慨与思考。自从上大学之后,觉得时间真的好快,转眼我已经是大二下的学生,四年的大学生活已经过半,我到底做了什么,有没有成长与进步,有没有荒度这些时光,这些天我无时无刻不反问自己。我觉得我还有很多事情,很多方面需要成长,但是时间却仿佛没有这么多了,大学本科毕业那年我22岁,如果在国内读研究生,那就是3年,毕业之后我就是25岁,在我的认知里,25岁就算是开始步入中年了,而那时的我才研究生毕业初入社会,可以说是稚嫩一无所有,这是我不能接受的。所以,这也是很大一部分原因让我选择出国留学,我希望更早地步入社会,去闯去打拼,而且就我自身而言,我觉得我的性格,在社会中会更能展现出优势,而不是科研的料。希望我可以在25岁这个结点,能做到小有成就,能做到让自己满意。
再简单记录一下自己这个学期的情况,学校的课程基本要从早八上到下午三点,下课之后在图书馆学习到七点20左右,然后去吃饭,八点在健身房锻炼到9点半左右,十点多洗完澡跟好朋友玩一玩游戏到十二点左右。我秉承着德智体美劳全面发展与劳逸结合,学习不能光学书本上的知识,网上很多各种类型的视频也常常可以给我启发,学习劳累之后去运动运动把身体搞好,学就是学玩就是玩,我分的很开,所以我每天晚上多少会玩一会游戏让自己放松一下。
差不多就说到这吧,写一写随笔真的挺好的,我经常心中有很多话,仿佛构思鸿篇巨制,却常因懒惰没有记录下来,希望以后勤写勤记,加油!
前一阵子与很久不见的学长交谈了一阵,两个小时感觉转瞬即逝,从未来选择到现在学业,和学长的交谈总能让我醍醐灌顶。我很喜欢和优秀的人谈话,他们的想法和建议总能让我豁然开朗。我最近一直对未来的选择十分迷惘,想学的东西太多,但时间精力有限,这时候就不得不做出选择。我需要好好想想我未来到底想从事什么方向的工作,并以此为目标钻研下去,而不是像无头苍蝇一样这学一点那学一点,泛而不精的人企业是不会要的。
摆在我眼前的有三个选择,第一个,我最近一直在看前端的知识,并跟着网上的教程编点小项目实操一下,我考虑的是一方面大创需要前端,我近期就可以用得上,另一方面我学的并不是前端很深入的知识,做一个知识上的普及还是有必要的;第二个,近期又来到计算机设计大赛的时间点,我要不要重拾unity的学习,后面走unity游戏开发方向的工作呢。但其实现在这个我不考虑了;第三个,我个人对金融,投资很感兴趣,我自己又是人工智能专业,后续去香港留学也想走ai+金融的方向,我是不是应该把更多的时间用在学习ai相关呢。
学长建议我还是要把更多的时间花在ai相关的学习,现在ai正是主流方向,沿着这个方向努力肯定是不会有问题的,平时要把人工智能相关的专业课,比如机器学习等,学扎实,而且我既然打算香港读研也是这个方向,就更要把时间花在这个地方。后续我打算把手头的项目写完后,有时间就开始在网上学习相关知识。
感觉废话有点多了,特别是上大学之后,选择与方向真的太多,但不管是哪个选择,都要大步走下去,而不是犹犹豫豫原地踏步,任重而道远啊!
最后说点题外话,把能认识到像学长这样优秀的人,我着实感到十分幸运。这两天又看了看学长的博客,每次看都能让我受益良多,我能开始写博客很大部分也受他的影响,但相比之下,确实感到自惭形愧,向学长学习!
我觉得学会投资,学会钱生钱,是一件很重要的事情,一开始这是我父亲告诉我的,后来我自身也是深刻地感受到了。投资,可以避免通货膨胀带了的损失,如果做到了一定的境界,更可以真正实现财富自由。但是想要学好投资并不是一件容易的事。投资的成功,不仅需要敏锐的洞察力与眼光,社会经验的积累,还要有一种成熟的投资心态,进而探索出适合自身的投资理念。我觉得,这是需要一件长期实践的事情,所以我决定早些开始,虽然我现在并没有什么资产,但在投资的过程中,包括看新闻看热点,去搜索去了解一家公司,这都是在锻炼我的视野,为以后做铺垫吧
因为“习惯”的力量,仍然有许多人把所有的收入存放在收益率较低的“储蓄”里,让通货膨胀
代码格式化:shift+alt+f
向上或向下移动一行:Alt+Up或Alt+Down
快速开始新一行:ctrl+enter
快速复制一行代码:Shift+Alt+Up 或Shift+Alt+Down
快速保存:Ctrl +S
快速查找:Ctrl + F
快速替换:Ctrl+ H
快速移动一行 alt + ↓或↑
多光标: alt + 鼠标左键
合并单元格
h5新标签
<header></header> 头部<nav></nav> 导航<section></section>定义文档中的节,比如章节、页眉、页脚<aside></aside> 侧边栏<footer></footer> 脚部<article></article>
代表一个独立的、完整的相关内容块,例如一篇完整的论坛帖子,一篇博客文章,一个用户评论等查漏补缺
<figure>元素表示文档流中独立的内容块。这个内容通常与主文档相关,但可以被移动到文档的其他位置(如侧边栏、脚注或独立的附件)而不会影响理解文档的其余部分。
<section>元素用于定义文档中的一个区域(section),它通常表示文档中的一个主题或内容块。
图像标题(figcaption)元素用于添加标题以描述
figure 元素中包含的图像。<figcaption>
必须是 <figure> 元素的子元素,并且它必须是
<figure> 中的第一个或最后一个子元素
“URL” 是 “Uniform Resource Locator” 的缩写,中文意思是 “统一资源定位符”。它是一种用于在互联网上定位和访问资源(如网页、图像、视频等)的地址。
fieldset 元素用于在 Web
表单中将相关的输入和标签组合在一起。 fieldset
元素是块级元素,这意味着它们出现在新的一行上。
legend 元素充当 fieldset 元素中内容的标题。
它为用户提供了应该在表单的该部分中输入什么的上下文。
<meta name="viewport" content="width=device-width, initial-scale=1.0" />是一个非常重要的
HTML 元标签,用于控制网页在移动设备上的布局和显示方式
article和section
article标签表示文档、页面、应用或网站的一部分,具有独立性和完整性。它通常包含一些内容,如新闻报道、博客文章、论坛帖子等,这些内容可以被单独地分享、链接和索引。
section标签则表示文档或应用的一部分,但不具有独立性和完整性。它通常用于组织内容,将页面或应用分成不同的部分,例如头部、主体、脚注等。
method 属性指定了如何将表单数据发送到
action 属性中指定的 URL。 表单数据可以通过 GET
请求作为 URL 参数发送(method="get")或通过
POST
请求作为请求正文中的数据发送(method="post")。
给密码 input 元素添加 pattern
属性,要求输入匹配 [a-z0-5]{8,}。上面是一个正则表达式,匹配
8 个以上的小写字母或数字 0 到 5。
<select> 和 <option> 是 HTML
中用于创建下拉列表的元素
<textarea> 是 HTML
中的一个表单元素,用于多行文本输入,允许用户输入和编辑大量文本。
英文全称记忆
<ul> : “Unordered List”
<li> : “List - item”
src: “source”
css text-align: “text alignment”(文本对齐方式)
link rel:relationship
<hr>:“Horizontal Rule”
查漏补缺
opacity 是 CSS
中用于控制元素透明度的属性。它可以设置一个元素的透明度级别,取值范围从
0(完全透明)到 1(完全不透明)
box-shadow
属性允许你在元素周围应用一个或多个阴影。box-shadow: offsetX offsetY blurRadius color;
linear-gradient 是 CSS
中用于创建线性渐变背景的属性。它允许你在元素的背景中定义多种颜色之间的平滑过渡效果
hsla(Hue色相, Saturation饱和度, Lightness,
Alpha透明度)是一种在 CSS 中定义颜色的方式,基于
HSL(色相、饱和度、亮度)颜色模型,并且允许设置透明度(alpha 值)。
vh 是 CSS 中的一种相对长度单位,表示视口高度(Viewport
Height)的百分比。具体来说,1vh 等于视口高度的
1%。视口是指浏览器窗口中可见的部分,不包括工具栏、地址栏等非内容区域。
em 是 CSS
中的一种相对单位,用于表示元素的字体大小(font-size)的倍数。具体来说,1em
等于当前元素的字体大小。例如,如果一个元素的字体大小为
16px,那么 1em 就等于 16px。
rem(Root Em)是 CSS
中的一种相对单位,表示相对于根元素(html
元素)的字体大小(font-size)的倍数。
在 CSS 中,cursor
属性用于定义鼠标指针位于元素上时的形状或图标。它对于改善用户体验非常重要,因为它为用户提供了视觉反馈,让他们知道可与页面上的不同元素进行哪些操作。
z-index属性设置元素的堆叠顺序。拥有更高堆叠顺序的元素总是会处于堆叠顺序较低的元素的前面
1 | .box1{ |
css3新特性
圆角
使用 CSS3 border-radius 属性,你可以给任何元素制作
“圆角”
border-radius 属性,可以使用以下规则:
阴影
box-shadow 向框添加一个或多个阴影。
1 | box-shadow: h-shadow v-shadow blur color; |
| 值 | 描述 |
|---|---|
| h-shadow | 必选,水平阴影的位置 |
| v-shadow | 必选,垂直阴影的位置 |
| blur | 可选,模糊距离 |
| color | 可选,阴影的颜色 |
动画
使用@keyframes规则,你可以创建动画
1 | @keyframes name { |
name:动画名称,开发人员自己命名;
percent:为百分比值,可以添加多个百分比值;
animation执行动画
1 | animation: name duration timing-function delay iteration-count direction; |
| 值 | 描述 |
|---|---|
| name | 设置动画的名称 |
| duration | 设置动画的持续时间 |
| timing-function | 设置动画效果的速率(如下) |
| delay | 设置动画的开始时间(延时执行) |
| iteration-count | 设置动画循环的次数,infinite为无限次数的循环 |
| direction | 设置动画播放的方向(如下) |
| animation-play-state | 控制动画的播放状态:running代表播放,而paused代表停止播放 |
| timing-function值 | 描述 |
|---|---|
| ease | 逐渐变慢(默认) |
| linear | 匀速 |
| ease-in | 加速 |
| ease-out | 减速 |
| ease-in-out | 先加速后减速 |
| direction值 | 描述 |
|---|---|
| normal | 默认值为normal表示向前播放 |
| alternate | 动画播放在第偶数次向前播放,第奇数次向反方向播放 |
切换背景颜色
1 | <div class="animation"></div> |
1 | .animation { |
设置meta标签
使用设备的宽度作为视图宽度并禁止初始的缩放。在<head>标签里加入这个meta标签。
1 | <meta name="viewport" content="width=device-width, initial-scale=1,maximum-scale=1, user-scalable=no"> |
参数解释
width = device-width 宽度等于当前设备的宽度initial-scale 初始的缩放比例(默认设置为1.0)maximum-scale
允许用户缩放到的最大比例(默认设置为1.0)user-scalable 用户是否可以手动缩放(默认设置为no)querySelector()
常用命令行工具有两种
CMD 命令行工具PowerShell 命令行工具CMD命令行
cmd,回车win+r 快速打开命令行窗口E:win:dirwin:clscd 文件夹名称cd ../tabmkdir 文件夹名称PowerShell
PowerShell打开shift+右键,打开ECMAScript 和 JavaScript 的关系是,前者是后者的规格,后者是前者的一种实现,通常场合,这两个词是可以互换的。
ECMAScript 6(以下简称 ES6)是 JavaScript 语言的标准,在 2015 年 6 月发布。它的目标,是使得 JavaScript 语言可以用来编写复杂的大型应用程序,成为企业级开发语言。
为什么你应当使用 TypeScript? TS 十分钟快速入门_哔哩哔哩_bilibili
【HTML+CSS+JS+Vue】比大学课程还详细的Web前端教程,整整180集,学完即可兼职就业!附学习文档PDF,随时都能学_前端开发_WEB入门_哔哩哔哩_bilibili
代码格式化:shift+alt+f
向上或向下移动一行:Alt+Up或Alt+Down
快速开始新一行:ctrl+enter
快速复制一行代码:Shift+Alt+Up 或Shift+Alt+Down
快速保存:Ctrl +S
快速查找:Ctrl + F
快速替换:Ctrl+ H
快速移动一行 alt + ↓或↑
多光标: alt + 鼠标左键
合并单元格
h5新标签
<header></header> 头部<nav></nav> 导航<section></section>定义文档中的节,比如章节、页眉、页脚<aside></aside> 侧边栏<footer></footer> 脚部<article></article>
代表一个独立的、完整的相关内容块,例如一篇完整的论坛帖子,一篇博客文章,一个用户评论等查漏补缺
<figure>元素表示文档流中独立的内容块。这个内容通常与主文档相关,但可以被移动到文档的其他位置(如侧边栏、脚注或独立的附件)而不会影响理解文档的其余部分。
<section>元素用于定义文档中的一个区域(section),它通常表示文档中的一个主题或内容块。
图像标题(figcaption)元素用于添加标题以描述
figure 元素中包含的图像。<figcaption>
必须是 <figure> 元素的子元素,并且它必须是
<figure> 中的第一个或最后一个子元素
“URL” 是 “Uniform Resource Locator” 的缩写,中文意思是 “统一资源定位符”。它是一种用于在互联网上定位和访问资源(如网页、图像、视频等)的地址。
fieldset 元素用于在 Web
表单中将相关的输入和标签组合在一起。 fieldset
元素是块级元素,这意味着它们出现在新的一行上。
legend 元素充当 fieldset 元素中内容的标题。
它为用户提供了应该在表单的该部分中输入什么的上下文。
<meta name="viewport" content="width=device-width, initial-scale=1.0" />是一个非常重要的
HTML 元标签,用于控制网页在移动设备上的布局和显示方式
article和section
article标签表示文档、页面、应用或网站的一部分,具有独立性和完整性。它通常包含一些内容,如新闻报道、博客文章、论坛帖子等,这些内容可以被单独地分享、链接和索引。
section标签则表示文档或应用的一部分,但不具有独立性和完整性。它通常用于组织内容,将页面或应用分成不同的部分,例如头部、主体、脚注等。
method 属性指定了如何将表单数据发送到
action 属性中指定的 URL。 表单数据可以通过 GET
请求作为 URL 参数发送(method="get")或通过
POST
请求作为请求正文中的数据发送(method="post")。
给密码 input 元素添加 pattern
属性,要求输入匹配 [a-z0-5]{8,}。上面是一个正则表达式,匹配
8 个以上的小写字母或数字 0 到 5。
<select> 和 <option> 是 HTML
中用于创建下拉列表的元素
<textarea> 是 HTML
中的一个表单元素,用于多行文本输入,允许用户输入和编辑大量文本。
英文全称记忆
<ul> : “Unordered List”
<li> : “List - item”
src: “source”
css text-align: “text alignment”(文本对齐方式)
link rel:relationship
<hr>:“Horizontal Rule”
查漏补缺
opacity 是 CSS
中用于控制元素透明度的属性。它可以设置一个元素的透明度级别,取值范围从
0(完全透明)到 1(完全不透明)
box-shadow
属性允许你在元素周围应用一个或多个阴影。box-shadow: offsetX offsetY blurRadius color;
linear-gradient 是 CSS
中用于创建线性渐变背景的属性。它允许你在元素的背景中定义多种颜色之间的平滑过渡效果
hsla(Hue色相, Saturation饱和度, Lightness,
Alpha透明度)是一种在 CSS 中定义颜色的方式,基于
HSL(色相、饱和度、亮度)颜色模型,并且允许设置透明度(alpha 值)。
vh 是 CSS 中的一种相对长度单位,表示视口高度(Viewport
Height)的百分比。具体来说,1vh 等于视口高度的
1%。视口是指浏览器窗口中可见的部分,不包括工具栏、地址栏等非内容区域。
em 是 CSS
中的一种相对单位,用于表示元素的字体大小(font-size)的倍数。具体来说,1em
等于当前元素的字体大小。例如,如果一个元素的字体大小为
16px,那么 1em 就等于 16px。
rem(Root Em)是 CSS
中的一种相对单位,表示相对于根元素(html
元素)的字体大小(font-size)的倍数。
在 CSS 中,cursor
属性用于定义鼠标指针位于元素上时的形状或图标。它对于改善用户体验非常重要,因为它为用户提供了视觉反馈,让他们知道可与页面上的不同元素进行哪些操作。
z-index属性设置元素的堆叠顺序。拥有更高堆叠顺序的元素总是会处于堆叠顺序较低的元素的前面
1 | .box1{ |
css3新特性
圆角
使用 CSS3 border-radius 属性,你可以给任何元素制作
“圆角”
border-radius 属性,可以使用以下规则:
阴影
box-shadow 向框添加一个或多个阴影。
1 | box-shadow: h-shadow v-shadow blur color; |
| 值 | 描述 |
|---|---|
| h-shadow | 必选,水平阴影的位置 |
| v-shadow | 必选,垂直阴影的位置 |
| blur | 可选,模糊距离 |
| color | 可选,阴影的颜色 |
动画
使用@keyframes规则,你可以创建动画
1 | @keyframes name { |
name:动画名称,开发人员自己命名;
percent:为百分比值,可以添加多个百分比值;
animation执行动画
1 | animation: name duration timing-function delay iteration-count direction; |
| 值 | 描述 |
|---|---|
| name | 设置动画的名称 |
| duration | 设置动画的持续时间 |
| timing-function | 设置动画效果的速率(如下) |
| delay | 设置动画的开始时间(延时执行) |
| iteration-count | 设置动画循环的次数,infinite为无限次数的循环 |
| direction | 设置动画播放的方向(如下) |
| animation-play-state | 控制动画的播放状态:running代表播放,而paused代表停止播放 |
| timing-function值 | 描述 |
|---|---|
| ease | 逐渐变慢(默认) |
| linear | 匀速 |
| ease-in | 加速 |
| ease-out | 减速 |
| ease-in-out | 先加速后减速 |
| direction值 | 描述 |
|---|---|
| normal | 默认值为normal表示向前播放 |
| alternate | 动画播放在第偶数次向前播放,第奇数次向反方向播放 |
切换背景颜色
1 | <div class="animation"></div> |
1 | .animation { |
设置meta标签
使用设备的宽度作为视图宽度并禁止初始的缩放。在<head>标签里加入这个meta标签。
1 | <meta name="viewport" content="width=device-width, initial-scale=1,maximum-scale=1, user-scalable=no"> |
参数解释
width = device-width 宽度等于当前设备的宽度initial-scale 初始的缩放比例(默认设置为1.0)maximum-scale
允许用户缩放到的最大比例(默认设置为1.0)user-scalable 用户是否可以手动缩放(默认设置为no)querySelector()
常用命令行工具有两种
CMD 命令行工具PowerShell 命令行工具CMD命令行
cmd,回车win+r 快速打开命令行窗口E:win:dirwin:clscd 文件夹名称cd ../tabmkdir 文件夹名称PowerShell
PowerShell打开shift+右键,打开ECMAScript 和 JavaScript 的关系是,前者是后者的规格,后者是前者的一种实现,通常场合,这两个词是可以互换的。
ECMAScript 6(以下简称 ES6)是 JavaScript 语言的标准,在 2015 年 6 月发布。它的目标,是使得 JavaScript 语言可以用来编写复杂的大型应用程序,成为企业级开发语言。
为什么你应当使用 TypeScript? TS 十分钟快速入门_哔哩哔哩_bilibili
【HTML+CSS+JS+Vue】比大学课程还详细的Web前端教程,整整180集,学完即可兼职就业!附学习文档PDF,随时都能学_前端开发_WEB入门_哔哩哔哩_bilibili
希尔排序:希尔排序是一种基于插入排序的排序算法,通过按一定步长将待排序的元素分组,对每组内的元素进行插入排序,不断缩小步长,最终实现整体排序。希尔排序的时间复杂度依赖于步长的选择,最坏情况下时间复杂度为O(n^2),最好的情况下接近O(nlogn)。
快速排序:快速排序是一种分治法思想的排序算法,选择一个基准元素,将待排序的数组分为左右两部分,左侧部分的元素都小于基准元素,右侧部分的元素都大于基准元素,然后分别对左右两部分进行递归排序。时间复杂度为O(nlogn),最坏情况下为O(n^2)。
堆排序:堆排序是一种选择排序的改进算法,利用堆数据结构(通常是大顶堆或小顶堆)来找到最大值或最小值,并将其移到数组的末尾,然后调整堆。时间复杂度为O(nlogn),适合大数据量排序。
归并排序:归并排序是一种分治法的排序算法,它将待排序的数组分为两部分,分别排序后再合并。时间复杂度为O(nlogn),且具有稳定性。
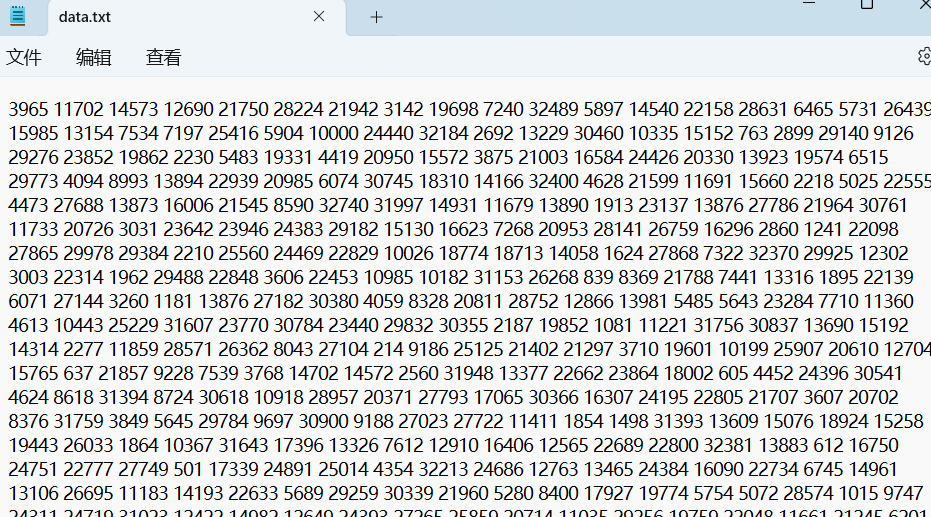
数据生成:程序首先生成10000个随机数并将其存储到文件
data.txt 中。
排序算法实现:实现了四种排序算法:希尔排序、快速排序、堆排序和归并排序。
文件操作:程序从文件中读取数据,然后使用不同的排序算法对数据进行排序,并将排序结果保存到文件中。
程序组成
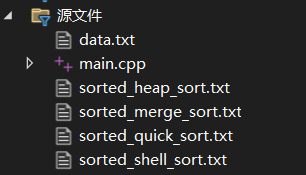
生成数据
排序结果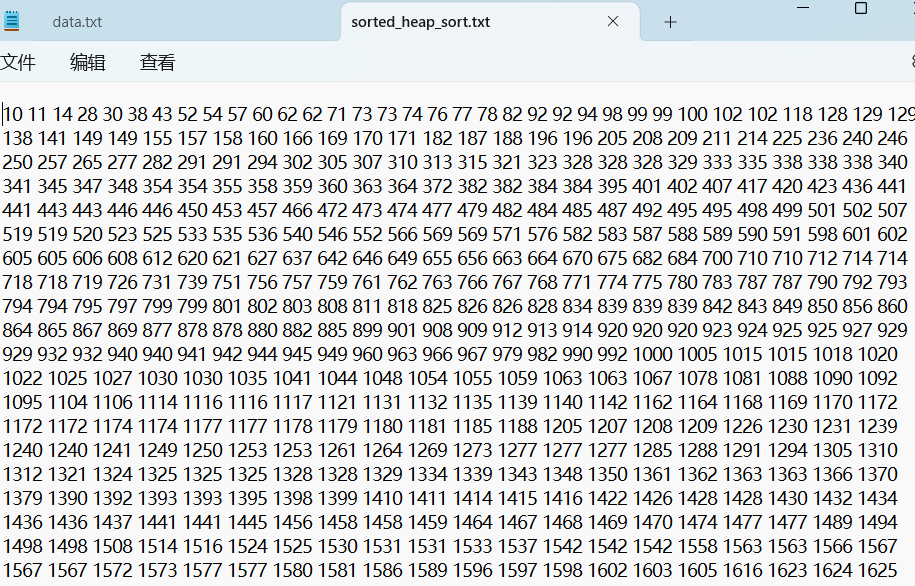
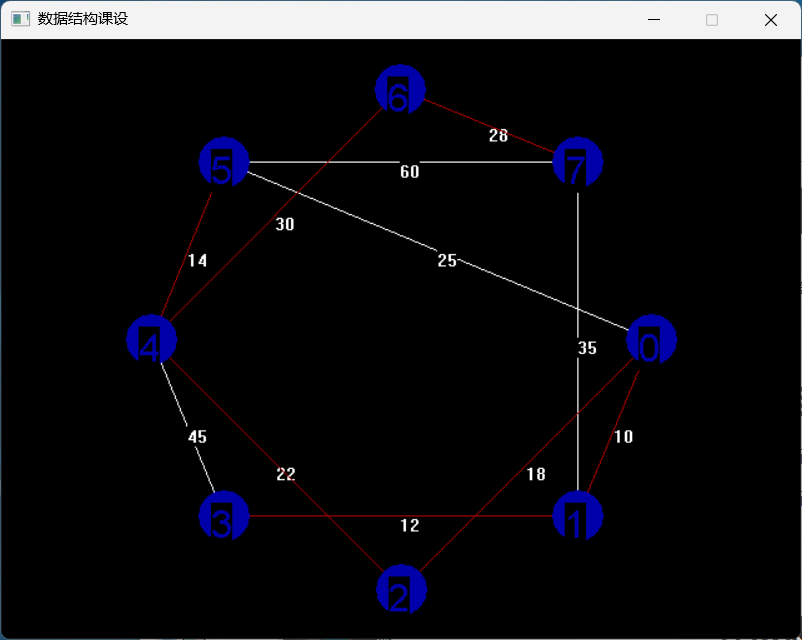
本题使用了Kruskal算法来求解最小生成树。Kruskal算法是一种典型的贪心算法,步骤如下:
该算法通过选择最小权重的边逐步构建最小生成树,保证了铺设煤气管道的总代价最小。
costs.txt,并根据这些信息构建图。通过程序实现,成功展示了根据最小生成树算法铺设的煤气管道图形,并显示了连接每个居民区的最小代价路径。图形显示了所有居民区和最小生成树路径的直观效果,确保了程序的正确性和可视化。
vscode
插件:
HTML CSS Support 写css代码
Live Serve 实时预览html网页
Auto Rename Tag 同步修改标签名称
html (hyper text markup language) 超文本标记语言
网页是又html标签描述出来的
html文件结构
1 |
|
块元素(block):块级元素通常用于组织和布局页面的主要结构和内容,例如段落、标题、列表、表格等。它们用于创建页面的主要部分,将内容分隔成逻辑块。
行内元素(inline):行内元素通常用于添加文本样式或为文本中的一部分应用样式。它们可以在文本中插入小的元素,例如超链接、强调文本等。
常用标签
<h1> </h1>一级标签
<p> </p>段落标签
<b> </b> bold 文本加粗
<u> </u> 下划线
<s> </s> 删除线
无序列表
<ul> <li>1</li>
<li>2</li> </ul>
有序列表
<ol> <li>1</li>
<li>2</li> </ol>
表格
1 | <table border="1">//边框宽度为1 |
html属性 基本语法:<开始标签 属性名="“属性值”">
<a href="www.zxj-2023.github.io" target="_blank">超链接</a>
超链接,target决定链接打开方式
<br> 换行
<hr> 分割线
<img src="图片路径或链接" alt="代替文本" width="宽度" height="高度"></img>
图片
<div class="名称"></div>块级标签,用于创建页面的布局结构,如导航栏,页眉等
优先级:id>class>标签名
<span></span>包装文本以便对其使用css,js行为或样式等
form标签是html表单的容器
1 | <form action="#">//URL |
css cascading style sheets 用于定义网页样式和布局的样式表语言,通过CSS,可以指定页面中各个元素的颜色、字体、大小、间距、边框、背景等样式,从而实现更精确的页面设计。
语法:
选择器{
属性1:属性值1;
属性2:属性值2;
}
内部样式表:放在head里面
1 | <head> |
外部样式:需在head链接
1 | <head> |
内联样式:标签内
1 | <h1 style="color=red;"> |
优先级:内联样式>内部样式表>外部样式
css选择器:
元素选择器:标签名
类选择器:.+类名
id选择器:#+id名
通用选择器:*
子代选择器:父+>+子
后代选择器:父+空格+子
相邻元素选择器:1+2 需要满足相邻条件
伪类选择器
css属性:
<h1 style="font: bolder 50px 'KaiTi';">复合属性</h1>
font符合属性示例
区分块、行内、行内块元素width和height的差异
通过display转换以上三者(block,inline,inline-block)
1 | .div-inline{ |
盒子模型:
浮动:改变元素默认的排列顺序,使网页布局更加灵活多变(letf right)
1 | .son{ |
清除浮动的方式
1 | .father{ |
定位布局:
相对定位(relative)∶相对于元素在文档流中的正常位置进行定位。
绝对定位(absolute)︰相对于其最近的已定位祖先元素进行定位,不占据文档流。
固定定位(fixed)︰相对于浏览器窗口进行定位。不占据文档流,固定在屏幕上的位置,不随滚动而移动。
1 | .box-relative{ |
JavaScript是一种轻量级、解释型、面向对象的脚本语言。它主要被设计用于在网页上实现动态效果,增加用户与网页的交互性。 作为一种客户端脚本语言,JavaScript可以直接嵌入HTML,并在浏览器中执行。 与HTML和CSS不同,JavaScript使得网页不再是静态的,而是可以根据用户的操作动态变化的。
客户端脚本:用于在用户浏览器中执行,实现动态效果和用户交互。
网页开发:与HTML和CSS协同工作,使得网页具有更强的交互性和动态性。
后端开发︰使用Node.js,JavaScript
也可以在服务器端运行,实现服务器端应用的开发。
js的导入
内联
1 | <script> |
外联
1 | <head> |
1 | console.log('hello,world')//控制台输出 |
js语句
1 | //变量 |
利用html属性触发事件
1 | <body> |
DOM
当网页被加载时,浏览器会创建页面的文档对象模型,也就是DOM (Document Object Model) .每个HTML或XML文档都可以被视为一个文档树,文档树是整个文档的层次结构表示。
文档节点是整个文档树的根节点。
DOM为这个文档树提供了一个编程接口,开发者可以使用JavaScript来操作这个树状结构。
1 | <body> |
对象
对象(object)是 JavaScript 语言的核心概念,也是最重要的数据类型
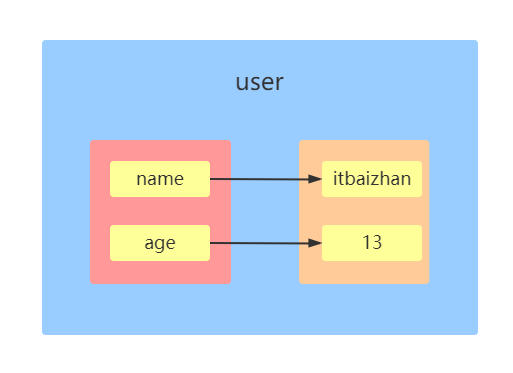
简单说,对象就是一组“键值对”(key-value)的集合,是一种无序的复合数据集合
1 | var user = { |
对象的每一个键名又称为“属性”(property),它的“键
值”可以是任何数据类型。如果一个属性的值为函数,通常把这个属性称为“方法”,它可以像函数那样调用
1 | var user = { |