openai与claude响应格式
Claude 的 Messages API 与 OpenAI 的 Responses API
前者是无状态(Stateless),每次对话会将历史记录传回服务端,利用promptcaching技术(大模型服务器의网关会计算你这段历史文本的哈希值(Hash),当发现前面的字符和之前一致时,会从内存的 KV Cache读取,而不是重新计算)。
前者第二个特点是结构上的,核心差别就是claude选择使用数组存储,称之为 (Content Blocks),里面按时间顺序并列存放不同的“块”(如思维链块、文本块、工具调用块)。这里可以和传统的openaiCompletions api进行对比思考,传统的Completions是将对话存入一个”message”对象的字段下,”message”对象内包含”content””reasoning_content””role”等字段。
但核心问题就是,JSON 语法绝对不允许出现重复的键(Key),如果单次对话出现多次工具调用或思考,Completions很难正确表示这个过程。
我的分析是,旧的Completions还停留在与模型对话一问一答的形式,而现在agent通常一次对话包含多次工具调用或模型思考,因此Completions不再适用,从而claude选择使用数组存储多个json对象,每个json使用type区分块的功能。
后者结构上沿用和Claude相同的设计,使用json数组实现对对话内容的存储,每次请求和响应只会包含最新的一轮对话,而不像claude完整的历史记录,每个Response都会包含一个id,从而支持随时回滚;而item的id可以类比claude的type,说明单次的功能。
Plaintext
1 | [第 1 轮对话] |
后者最大的特点是在服务端是有状态(Stateful),工具调用和上下文历史管理完全托管在云端服务器。
这样的好处有:
- 发新请求时,不用反复传完整的聊天记录,只要带上上一次回复的 previous_response_id,服务端会自动在后台回溯、拼接历史,甚至自动触发上下文压缩(Compaction)。
- 云厂商将网络搜索、代码解释器等工具直接托管在云端。在单次 API 请求的生命周期内,模型如果发现需要联网或跑代码,会在云端沙盒里自己反复调用并纠错,跑完整个智能体循环后,直接把最终成果包吐给客户端,客户端只负责“解析最终数据”。
- 模型方面,openai可以因此保护模型的隐藏推理链(Reasoning Traces),OpenAI 就可以把所有的推理中间态完美地封锁在自己的云端服务器里,客户端只能拿到剥离后的干净结果。
- 数据方面,一旦完全托管在服务端,由于数据是由 OpenAI 的数据库统一规范存储的,服务器在计算 KV Cache 的持久化和重用时,可以做到对齐和命中。
但这样也有坏处:
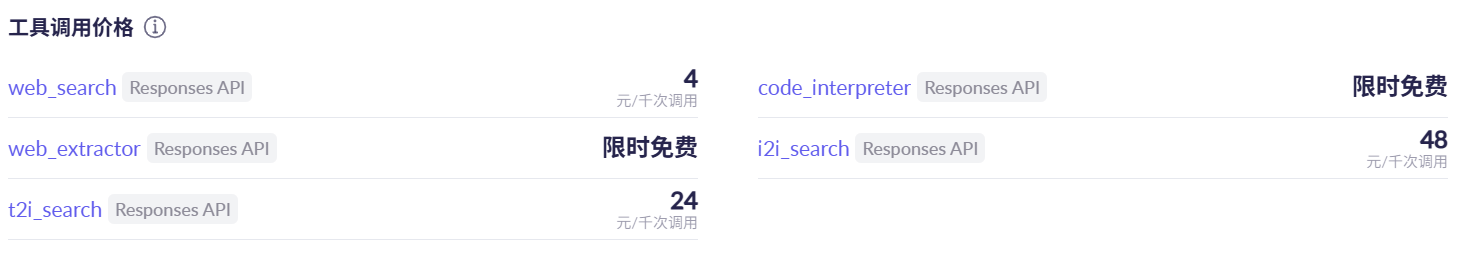
由于是云端调用工具,除了 Token 费,调用内置的联网搜索、代码沙箱通常需要额外支付固定通道费或容器会话费。
prompt caching
kvcache的原理不多赘述,简单来说,就是大模型会把kv矩阵计算的值存储起来,再次遇到历史字符时就不用计算了,只计算新字符的矩阵,最后拼接起来。
对于Completions API和Anthropic 官方的 Messages API,他们每次请求与详细都会传输完整的上下文,因此为了节省token的消耗,prompt caching便是关键
这里可以参考提示缓存 |OpenAI API
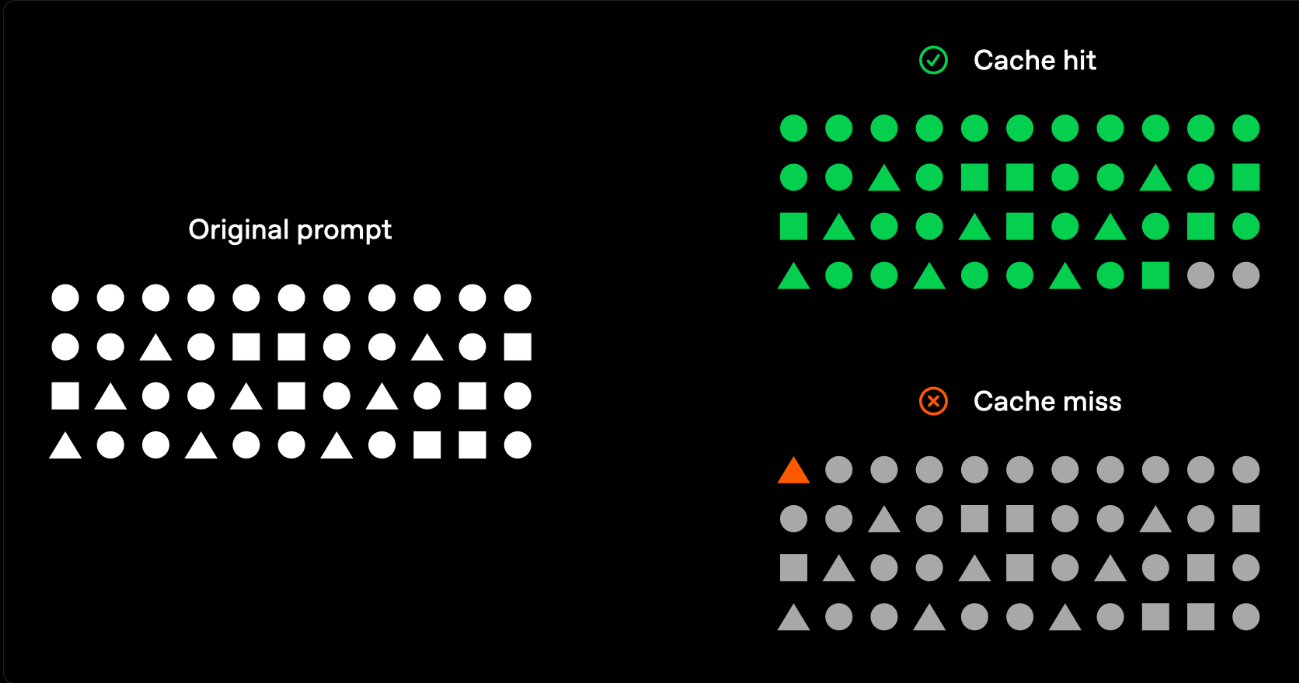
模型提示通常包含重复内容,如系统提示和通用指令。OpenAI 将 API 请求路由到最近处理过相同提示的服务器,这使得它比从零开始处理提示更便宜、更快。提示缓存可将延迟降低高达80%,输入令牌成本降低高达90%。提示缓存会自动处理你所有的 API 请求(无需修改代码),且没有额外费用。
缓存命中只能针对提示内的精确前缀匹配。
工作流程
缓存功能对于1024个token及以上的提示会自动启用。当您发送API请求时,会执行以下步骤:
1.根据提示词初始前缀计算哈希值,去内存的 KV Cache 索引表里检索。
2.如果找到匹配的前缀,系统会使用缓存结果。
kv的存储
它最初在 GPU 显存(VRAM)里,但为了存更久,会被“吐”到 GPU 本地的 NVMe SSD 硬盘或内存中。
大模型的显存(VRAM)是极其昂贵且稀缺的资源。如果把所有用户的 KV 缓存都永久塞在 GPU 显存里,GPU 瞬间就会爆显存(OOM)。因此,厂商引入了分层存储架构:
热缓存(In-Memory 状态):当模型刚处理完你的请求时,生成的 KV 张量确实老老实实呆在 GPU 显存(VRAM) 或该服务器节点的 系统内存(RAM) 中。因为读写速度最快,随时准备应对你几分钟内的下一轮对话。
冷缓存(Extended 状态):当缓存需要保存几小时甚至 24 小时时,服务器会把这些 KV 张量进行加密,然后从珍贵的显存中释放出来,转储到 GPU 本地服务器的高速 NVMe SSD 硬盘 上。
当你下一次请求命中缓存时,服务器会以极快的速度把加密的 KV 张量从本地硬盘重新加载(Load)回 GPU 显存中。虽然比纯显存慢一点点,但比起让大模型重新推理一遍几万字的输入,速度依然快了 80% 以上。
openai Completions API和Responses API区别
1. 响应数据结构(JSON)对比
两者的最直观区别在于返回的 JSON 报文层级和字段设计。
传统的 Completions API (以 Chat Completions 为例)
在传统规范中,模型生成的内容被深度嵌套在 choices 数组中:
1 | { |
- 代码提取路径:
response.choices[0].message.content - 痛点:层级过深;由于早期的设计允许返回多个结果(通过
n参数控制choices的数量),导致普通的单次对话也必须套一层数组。
全新的 Responses API
为了简化代码并原生支持更复杂的 AI 行为,新规范将结构打平,引入了 output 概念:
1 | { |
- 代码提取路径:在新版 SDK 中,通常可以直接通过
response.output_text拿到最终文本。 - 亮点:原生支持深度思考(Reasoning)。当使用具备类 o1/Qwen3.5 等带有思维链(CoT)功能的推理模型时,其思考过程会直接作为平级的
reasoning字段输出,无需再像以前那样通过特殊的content拼接或不透明的魔改字段来传输。
2. 核心维度深度对比
| 维度 | Completions API (传统) | Responses API (新一代) |
|---|---|---|
| 设计定位 | 纯文本生成 / 简单对话交互 | 彻底面向智能体 (Agentic Loop) 和新型推理模型设计 |
| 结构复杂度 | 较高。嵌套在 choices[0].message 内 |
较低。外层通常直接暴露 output 或扁平化字段 |
| 思维链支持 (Reasoning) | 较弱。通常需要占用 content 空间或使用魔改字段透传 |
原生支持。拥有独立的 reasoning 字段,与最终回答完美分离 |
| 多步骤工具调用 (Tool Call) | 复杂。多轮 Tool 调用需要开发者在代码里频繁手动拼装、维护上下文历史 | 原生自动化。支持单次请求内模型自主进行多步工具调用(如网络搜索、执行代码)并直接返回最终 Response |
| 存储与状态保持 | 默认无状态(Stateless),每次交互需全量上传历史记录 | 部分环境支持原生上下文状态保持(Stateful),降低长对话的 Token 传输成本 |
Anthropic 官方的 Messages API 规范
样例
1 | { |
核心对比矩阵
| 维度 | Claude 响应格式 (Messages API) | OpenAI Responses API |
|---|---|---|
| 设计核心 | 富内容块 (Rich Content Blocks) 驱动 | 智能体循环 (Agentic Loop) 与托管工具驱动 |
| 基础数据对象 | 消息 (messages) 与 内容块 (content) |
项 (items) 与 响应对象 (response) |
| 多轮状态管理 | 无状态 (Stateless):需由客户端每次回传完整上下文(配合 Prompt Caching 优化成本) | 有状态 (Stateful):支持通过 previous_response_id 在服务端自动链式追踪状态 |
| 工具调用机制 | 客户端编排:模型返回 tool_use,开发者在本地执行后用 tool_result 回传 |
服务端托管:一次请求内,服务端自动运行多轮内置工具(Web 搜索、代码执行、MCP等) |
| 结构化输出 | 支持 JSON Schema / 借助 SDK 的 messages.parse 确保强一致性 |
原生支持强类型的 Structured Outputs 和自动修复 |
核心差异深度解析
1. 返回数据结构:Content Blocks vs Output Items
Claude 的响应格式(块结构)
Claude 的核心创新在于将响应内容拆解为一个个并列的 Content Block(内容块)。一条响应的
content是一个数组,里面可以同时包含思维链(thinking)、文本、工具调用等多种类型。JSON
1
2
3
4
5
"content": [
{ "type": "thinking", "thinking": "用户需要计算..." },
{ "type": "text", "text": "好的,我为你算一下。" },
{ "type": "tool_use", "id": "toolu_123", "name": "calculator", "input": {...} }
]这种设计的优势在于透明度高、扩展性极强,完美融合了文本、多媒体(PDF/图片)和原生推理。
OpenAI Responses API(对象与项结构)
Responses API 彻底抛弃了早期 Chat Completions 繁琐的
choices[0].message嵌套,返回一个具有独立id的response对象,其内部核心是output数组,由各种类型的 Item(项) 组成。1
2
3"output": [
{ "id": "item_abc", "type": "message", "message": { "role": "assistant", "content": [...] } }
]它在顶层解耦了
instructions(系统指令)和input(用户输入),语义更加符合现代 Agent 架构。
2. 状态与多轮对话管理
Claude:客户端保留 + 提示词缓存 (Prompt Caching)
Claude API 本身是无状态的。这意味着做多轮对话时,你必须把之前的聊天历史全部打包传回去。
巧妙的优化: 尽管每次都要重传历史,但 Claude 提供了极其强大的 Prompt Caching(瞬时缓存)。只要历史对话没有变,重复传入的部分会直接命中缓存,不仅响应速度极快,还能帮你省下高达 90% 的输入 Token 费用。
OpenAI Responses API:服务端自动追踪 + 引用 ID
Responses API 引入了真正的“有状态”模式。你不需要在客户端维护一个长长的数组,你只需要传入当前最新的用户输入,并附带上一次的
previous_response_id:Python
1
2
3
4
5response2 = client.responses.create(
model="gpt-5",
previous_response_id=response1.id,
input="那它的常住人口是多少?"
)OpenAI 的服务器会自动在后台保留和拼接历史,甚至在上下文过长时自动触发服务端压缩 (Compaction),免去了开发者手动管理长上下文的痛苦。
3. 工具调用与智能体编排 (Tool Use & Agentic Loop)
Claude:协作式编排
当你给 Claude 绑定自定义工具时,交互是“回合制”的:客户端发请求 $\rightarrow$ Claude 返回
tool_use块并中断请求 $\rightarrow$ 你的代码在本地执行该工具 $\rightarrow$ 你的代码把tool_result发回给 Claude $\rightarrow$ Claude 给出最终文本。这种模式下,控制权完全在开发者手里,你可以非常安全地在本地读取数据库或执行敏感操作。OpenAI Responses API:全面托管的自动循环
Responses API 的最大杀手锏是它的 Agentic by default(默认智能体化)。它把工具调用的控制权收归到了云端。
它内建了诸如 Web Search(网络搜索)、File Search(文件搜索)、Code Interpreter(代码解释器)以及远程 MCP(模型上下文协议)服务器。当你发出一个请求时,模型可以在一次 API 调用的生命周期内,自己在云端反复调用多次工具,直到得出完美答案。开发者不需要写任何多轮编排的代码。