convertapi

ConvertAPI: Powerful File Conversion API for Developers & Businesses

档次 官方名称 月费 (CNY) 每月包含转换次数 单文件上限 并发任务数
1 Developer ¥249 1,000 次 200 MB 1
2 Startup ¥677 5,000 次 300 MB 2
3 Growth ¥1,247 15,000 次 500 MB 3
4 Business ¥2,495 50,000 次 1 GB 无限制

CloudConvert

模式 价格 包含内容
一次性购买积分 $9 美元 起 500 个转换积分
月度订阅 $9 美元/月 每月 1000 个转换积分,未用完可滚存

每天免费 10 次转换

pdf转ppt,一次要花费4积分,平均下来一份需要0.47元,付费情况下可以做到 5个并发任务

定价 |云转换

PDF to PowerPoint | CloudConvert

GroupDocs.Conversion/Aspose.PDF Cloud

每个月1000次以内的api调用是30美金,平均下来是一份0.21元,但是如果超过1000次每个月,就要0.09美金一次转换

付费默认5并发

https://products.groupdocs.cloud/conversion/python/pdf-to-ppt/

Dashboard

Dashboard

Pricing Guide - Purchase - groupdocs.cloud

Adobe PDF

每个月五百次的免费转换

Adobe PDF Services API Pricing | PDF Embed API Pricing | Adobe Acrobat Services Pricing - Adobe Developers

度慧科技

这个很便宜,我在腾讯云上看,300r可以买五千次,500r可以买5万次转换。阿里云,100r可以买3000次,有效期一个月

并发数为200

度慧文档转换

[度慧]PDF转Word,PPT,Excel,TXT,OFD(OCR高级版)-腾讯云市场

【度慧文档转换】PDF转Word/PPT/Excel/TXT/OFD - 支持扫描版OCR【最新版】数据API_OCR_API-云市场-阿里云

技术路线

方案 A:html → PDF → pptx(我尝试下来不大可行,无法再进行编辑了)

方案 B:html → PPTXGenJS

方案 C:html → python-pptx (主流)

方案 D:markdown → Slidev

我尝试了当前市面的ppt生成产品,在网页里面展示还会有良好的动画效果,但是一旦导出成pptx,都是会变成静态页面,没有动画

reveal.js可以利用页面生成丰富的ppt动画效果;Slidev可以将markdown语法转化成ppt,可以导出为pdf或pptx,需要注意的是,PPTX 文件中的所有幻灯片都会被导出为图片。

PPTXGenJS和python-pptx的原理基本一致,区别一个是使用js一个是python,使用方法都是通过解析HTML标签内容,定义一个ppt实例,将html的内容一点点加入这个示例中,最后导出pptx。这样都仅能实现最基本的ppt演示,不会有复杂的结构,而且经常会出现一个问题——某个标签内文字太多往往会超出ppt演示范围

直接让AI来生成非常自由的PPT,最终的效果一般来说都比较烂,大部分都是预定义一个html模板,然后让AI来自动的选择模板往里面填充内容

相关工具

Slidev 是一个为开发者设计的基于 Web 的幻灯片制作工具。它帮助您以 Markdown 的形式专注于编写幻灯片的内容,并制作出具有交互式演示功能的、高度可自定义的幻灯片。

reveal.js 是一个开源的 HTML 演示框架,用 JavaScript 写成。只要你会写 HTML/CSS/JS,就可以像做网页一样做出 酷炫、响应式、支持键盘/鼠标/触控交互 的幻灯片。

PptxGenJS 允许您使用 JavaScript 生成专业的 PowerPoint 演示文稿——直接从 Node、React、Vite、Electron,甚至浏览器中生成。

python-pptx 是一个用于创建、读取和更新 PowerPoint (.pptx)文件的 Python 库。典型的使用场景是从动态内容(如数据库查询、分析输出或 JSON 负载)生成 PowerPoint 演示文稿,可能是在响应 HTTP 请求时生成 PPTX 文件并下载。

python-pptx使用方式:根据标签解析html文件,如h1,div等,然后一点点添加到定义的页中

市面同类产品

  1. Genspark

    • Genspark 是 MainFunc 公司(由前小度 CEO 景鲲和前小度 CTO 朱凯华联合创立)推出的 AI Agent 搜索引擎(或称“AI 原生搜索引擎”)。
  2. skywork

    • Skywork 是昆仑万维(Kunlun Inc.)旗下 SkyWork AI 推出的一系列 开源大模型 与 AI 技术品牌。
  3. manus

  4. Gamma 是一个 “AI 驱动的在线内容工作站”:输入一句话、一段大纲或任何资料,它就能在 1-3 分钟内 帮你生成 高颜值、品牌化、可互动 的演示文稿、网站、社媒图文或 PDF,并可一键导出为 PPT / Google Slides / PDF / 网站链接。

manus是每页ppt都是一个html文件,我猜测应该是使用像python-pptx的库生成

ppt-mcp

可以参考其中的工具实现,这两个我看下来都是使用python-pptx包

GongRzhe/Office-PowerPoint-MCP-Server: A MCP (Model Context Protocol) server for PowerPoint manipulation using python-pptx. This server provides tools for creating, editing, and manipulating PowerPoint presentations through the MCP protocol.

ltc6539/mcp-ppt: A mcp server supporting you to generate powerpoint using LLM and natural language automatically.

架构思考

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
flowchart TB
subgraph "Plan-and-Execute阶段"
A["用户输入"] --> B["Planner Agent"]
B --> C["Agent Executor"]
C --> D["Replanner"]
D -->|"需要更多信息"| C
D -->|"信息充足"| E["输出结构化信息"]
end

subgraph "内容生成阶段"
E --> F["大纲设计节点"]
F --> G["页面内容生成节点"]
G --> H["HTML代码生成节点"]
end

subgraph "文件转换阶段"
H --> I["html演示生成"]
I --> J["转换pptx节点"]
J --> K["输出PPTX文件"]
end

利用APRYSE将pdf转成pptx

Apryse(曾用名 PDFTron)是一家加拿大公司推出的商用 SDK 家族,专注 “任何格式进、任何格式出” 的文档处理。

获取apikeyFree trial key for Apryse SDK | Apryse documentation

Python 3.X PDF Library for Windows, Linux and Mac | Apryse documentation

安装 Apryse SDK 的“结构化输出模块”(Structured Output Module)。该模块是一个可选的扩展包,PDF → PPTX、PDF → Word 等高级转换功能都依赖它。库插件:OCR、CAD 转 PDF - 适用于服务器/桌面 SDK | Apryse 文档 —- Library Add-ons: OCR, CAD to PDF - for Server/Desktop SDK | Apryse documentation

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
from apryse_sdk import PDFNet, PDFDoc, Convert, StructuredOutputModule

# 1. 初始化(许可证)
PDFNet.Initialize("demo:1756369085114:")

# 2. 告诉 SDK 模块放在哪里
PDFNet.AddResourceSearchPath(r"F:\project python\test\StructuredOutputWindows\Lib\Windows")

# 3. 可选:确认模块已就位
if not StructuredOutputModule.IsModuleAvailable():
raise RuntimeError("StructuredOutput module not found!")

# 4. 正常调用
doc = PDFDoc("input.pdf")
Convert.ToPowerPoint(doc, "output.pptx")

Overview

参考资料

动手实现一个做PPT的MCP服务器_哔哩哔哩_bilibili

前言

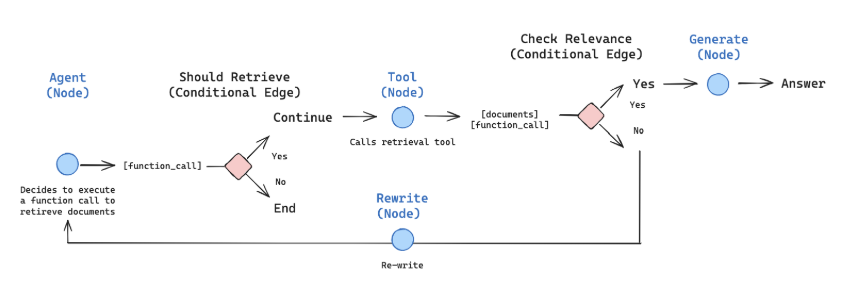
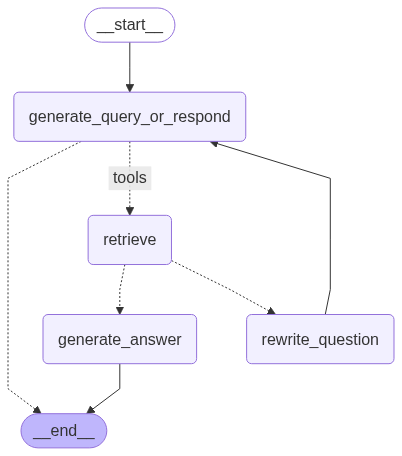
这个agentic rag主要是作用于检索部分,由是否需要调用检索工具判定是否进入检索阶段,当检索到相关的文章,则进行回答,否则对问题进行改写,再次检索

代码见learn-rag-langchain/agentic-rag at main · zxj-2023/learn-rag-langchain

在这个教程中,我们将构建一个检索代理。当您希望 LLM 决定是否从向量存储中检索上下文或直接响应用户时,检索代理非常有用。

完成教程后,我们将完成以下工作:

  1. 获取并预处理用于检索的文档。
  2. 为这些文档建立语义索引,并为代理创建一个检索工具。
  3. 构建一个能够决定何时使用检索工具的代理式 RAG 系统。

image-20250819165309335

1. 预处理文档

获取用于我们 RAG 系统的文档。我们将使用 Lilian Weng 优秀博客中最新的三页。我们将从使用 WebBaseLoader 工具获取页面内容开始:

1
2
3
4
5
6
7
8
9
from langchain_community.document_loaders import WebBaseLoader

urls = [
"https://lilianweng.github.io/posts/2024-11-28-reward-hacking/",
"https://lilianweng.github.io/posts/2024-07-07-hallucination/",
"https://lilianweng.github.io/posts/2024-04-12-diffusion-video/",
]

docs = [WebBaseLoader(url).load() for url in urls]
1
docs[0][0].page_content.strip()[:1000]

将获取的文档分割成更小的块,以便索引到我们的向量存储中:

1
2
3
4
5
6
7
8
from langchain_text_splitters import RecursiveCharacterTextSplitter

docs_list = [item for sublist in docs for item in sublist]

text_splitter = RecursiveCharacterTextSplitter.from_tiktoken_encoder(
chunk_size=100, chunk_overlap=50
)
doc_splits = text_splitter.split_documents(docs_list)
1
doc_splits[0].page_content.strip()

2. 创建检索工具

现在我们已经有了分割的文档,我们可以将它们索引到一个向量存储中,我们将使用这个向量存储进行语义搜索。

使用内存向量存储和 OpenAI 嵌入:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
from langchain_chroma import Chroma  # 导入 Chroma
from langchain_openai import OpenAIEmbeddings
import os

# 确保安装了 langchain-chroma
# pip install langchain-chroma

embedding = OpenAIEmbeddings(
api_key="sk-",
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
model="text-embedding-v4",
check_embedding_ctx_length=False,
dimensions=1536,
chunk_size=5 # 设置较小的批次大小
)

# 使用 Chroma 替代 InMemoryVectorStore
vectorstore = Chroma.from_documents(
documents=doc_splits,
embedding=embedding,
persist_directory="./chroma_db" # 指定持久化目录
)
1
2
3
4
5
6
7
# 重新加载已存在的 Chroma 数据库
vectorstore = Chroma(
persist_directory="./chroma_db",
embedding_function=embedding
)

retriever = vectorstore.as_retriever()

使用 LangChain 的预构建 create_retriever_tool 创建检索工具

1
2
3
4
5
6
7
from langchain.tools.retriever import create_retriever_tool

retriever_tool = create_retriever_tool(
retriever, # 【输入】一个已经配置好的检索器(例如:向量数据库的检索器)
"retrieve_blog_posts", # 【工具名称】这个工具的唯一标识名(供模型内部调用)
"Search and return information about Lilian Weng blog posts." # 【工具描述】模型看到的说明,用于决定是否调用它
)
1
retriever_tool.invoke({"query": "types of reward hacking"})

3. 生成查询

现在我们将开始构建我们智能体 RAG 图中的组件(节点和边)。

构建一个 generate_query_or_respond 节点。它将调用 LLM 来根据当前图状态(消息列表)生成响应。根据输入消息,它将决定使用检索工具进行检索,或直接响应用户。请注意,我们通过 .bind_tools 向聊天模型提供了先前创建的 retriever_tool 访问权限:

1
2
3
4
5
6
7
from langchain_community.chat_models import ChatTongyi
llm = ChatTongyi(
model="qwen3-235b-a22b",
api_key="sk-",
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
model_kwargs={"enable_thinking": False} # 关键在这里
)
1
2
3
4
5
6
7
8
9
10
from langgraph.graph import MessagesState

def generate_query_or_respond(state: MessagesState):
"""调用模型,根据当前状态生成响应。根据问题,模型将决定是使用检索工具进行检索,还是直接回复用户。
"""
response = (
llm
.bind_tools([retriever_tool]).invoke(state["messages"])
)
return {"messages": [response]}

提出一个需要语义搜索的问题:

1
2
3
4
5
6
7
8
9
input = {
"messages": [
{
"role": "user",
"content": "What does Lilian Weng say about types of reward hacking?",
}
]
}
generate_query_or_respond(input)["messages"][-1].pretty_print()

4.评定文件

添加一个条件边 — grade_documents — 来判断检索到的文档是否与问题相关。

我们将使用一个具有结构化输出模式 GradeDocuments 的模型来对文档进行评分。 grade_documents 函数将根据评分决策( generate_answer 或 rewrite_question )返回要前往的节点的名称:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
from pydantic import BaseModel, Field
from typing import Literal

# 定义评分提示模板
GRADE_PROMPT = (
"你是一个评分员,负责评估检索到的文档与用户问题的相关性。\n "
"以下是检索到的文档内容:\n\n {context} \n\n"
"以下是用户的问题:{question} \n"
"如果文档包含与用户问题相关的关键词或语义含义,则将其评为相关。\n"
"请给出一个二元评分:'yes'(是)表示相关,'no'(否)表示不相关。"
)

# 定义用于评估文档相关性的 Pydantic 模型
class GradeDocuments(BaseModel):
"""使用二元评分对文档进行相关性评估。"""

binary_score: str = Field(
description="相关性评分:'yes' 表示相关,'no' 表示不相关"
)

# 初始化用于评分的聊天模型
grader_model = llm

def grade_documents(
state: MessagesState,
) -> Literal["generate_answer", "rewrite_question"]:
"""
判断检索到的文档是否与用户问题相关。

参数:
state: 包含消息历史的状态对象,其中第一条消息是用户问题,
最后一条消息是检索到的文档内容。

返回:
如果文档相关,返回 "generate_answer";
如果不相关,返回 "rewrite_question",表示需要重写问题并重新检索。
"""
question = state["messages"][0].content # 获取用户问题
context = state["messages"][-1].content # 获取检索到的文档内容

# 将问题和文档内容填入提示模板
prompt = GRADE_PROMPT.format(question=question, context=context)

# 调用模型,并以结构化输出(Pydantic 模型)的形式获取评分结果
response = (
grader_model
.with_structured_output(GradeDocuments)
.invoke([{"role": "user", "content": prompt}])
)
#print(response)
score = response.binary_score # 获取二元评分结果

# 根据评分决定下一步操作
if score == "yes":
return "generate_answer" # 文档相关,生成答案
else:
return "rewrite_question" # 文档不相关,重写问题后重新检索
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
from langchain_core.messages import convert_to_messages

input = {
"messages": convert_to_messages(#将一系列消息转换为 BaseMessage 类型的消息列表。
[
{
"role": "user",
"content": "What does Lilian Weng say about types of reward hacking?",
},
{
"role": "assistant",
"content": "",
"tool_calls": [
{
"id": "1",
"name": "retrieve_blog_posts",
"args": {"query": "types of reward hacking"},
}
],
},
{"role": "tool", "content": "meow", "tool_call_id": "1"},
]
)
}
grade_documents(input)

5. 重写问题

构建 rewrite_question 节点。

检索工具可能会返回潜在的不相关文档,这表明需要改进原始用户问题。为此,我们将调用 rewrite_question 节点:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
REWRITE_PROMPT = (
"Look at the input and try to reason about the underlying semantic intent / meaning.\n"
"Here is the initial question:"
"\n ------- \n"
"{question}"
"\n ------- \n"
"Formulate an improved question:"
)

def rewrite_question(state: MessagesState):
"""
重写用户最初的提问,以更好地表达其语义意图。

参数:
state: 包含消息历史的状态对象,其中第一条消息是用户原始问题。

返回:
一个字典,包含一条新的用户消息,内容为改写后的问题。
该消息将用于后续的检索步骤,以提高检索结果的相关性。
"""
messages = state["messages"]
question = messages[0].content # 获取用户最初的提问
prompt = REWRITE_PROMPT.format(question=question) # 将问题填入提示模板
response = llm.invoke([{"role": "user", "content": prompt}]) # 调用模型生成改写后的问题

# 返回新的消息结构,内容为改写后的问题
return {"messages": [{"role": "user", "content": response.content}]}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
input = {
"messages": convert_to_messages(
[
{
"role": "user",
"content": "What does Lilian Weng say about types of reward hacking?",
},
{
"role": "assistant",
"content": "",
"tool_calls": [
{
"id": "1",
"name": "retrieve_blog_posts",
"args": {"query": "types of reward hacking"},
}
],
},
{"role": "tool", "content": "meow", "tool_call_id": "1"},
]
)
}

response = rewrite_question(input)
print(response["messages"][-1]["content"])

6. 生成答案

构建 generate_answer 节点:如果我们通过了评分器的检查,我们可以根据原始问题和检索到的上下文生成最终答案:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
GENERATE_PROMPT = (
"You are an assistant for question-answering tasks. "
"Use the following pieces of retrieved context to answer the question. "
"If you don't know the answer, just say that you don't know. "
"Use three sentences maximum and keep the answer concise.\n"
"Question: {question} \n"
"Context: {context}"
)


def generate_answer(state: MessagesState):
"""Generate an answer."""
question = state["messages"][0].content
context = state["messages"][-1].content
prompt = GENERATE_PROMPT.format(question=question, context=context)
response = llm.invoke([{"role": "user", "content": prompt}])
return {"messages": [response]}
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
input = {
"messages": convert_to_messages(
[
{
"role": "user",
"content": "What does Lilian Weng say about types of reward hacking?",
},
{
"role": "assistant",
"content": "",
"tool_calls": [
{
"id": "1",
"name": "retrieve_blog_posts",
"args": {"query": "types of reward hacking"},
}
],
},
{
"role": "tool",
"content": "reward hacking can be categorized into two types: environment or goal misspecification, and reward tampering",
"tool_call_id": "1",
},
]
)
}

response = generate_answer(input)
response["messages"][-1].pretty_print()

7. 组装图表

以 generate_query_or_respond 开头,并确定是否需要调用 retriever_tool

使用 tools_condition 跳转到下一步:

  • 如果 generate_query_or_respond 返回 tool_calls ,调用 retriever_tool 获取上下文
  • 否则,直接回复用户

对检索到的文档内容按与问题的相关性( grade_documents )进行评分,并路由到下一步:

  • 如果不相关,使用 rewrite_question 重写问题,然后再次调用 generate_query_or_respond
  • 如果相关,请继续到 generate_answer 并使用检索到的文档上下文生成最终响应 ToolMessage
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
from langgraph.graph import StateGraph, START, END
from langgraph.prebuilt import ToolNode
from langgraph.prebuilt import tools_condition

# 创建一个基于状态图(StateGraph)的流程,用于管理对话或任务的执行流程
workflow = StateGraph(MessagesState)

# 定义流程中将循环执行的各个节点
workflow.add_node(generate_query_or_respond) # 判断是生成检索查询还是直接回复用户
workflow.add_node("retrieve", ToolNode([retriever_tool])) # 检索节点:使用检索工具(retriever_tool)从知识库中查找相关文档
workflow.add_node(rewrite_question) # 重写问题节点:当检索结果不相关时,优化并重写用户的问题
workflow.add_node(generate_answer) # 生成答案节点:基于检索到的信息生成最终回答

# 设置流程的起始点:从 `generate_query_or_respond` 节点开始
workflow.add_edge(START, "generate_query_or_respond")

# 添加条件边:决定是否进行文档检索
workflow.add_conditional_edges(
"generate_query_or_respond",
# 使用 `tools_condition` 函数判断 LLM 的输出意图:
# 如果 LLM 决定调用 `retriever_tool` 工具,则进入检索;如果选择直接回复,则结束流程
tools_condition,
{
# 将条件判断结果映射到图中的具体节点
"tools": "retrieve", # 若需调用工具,则跳转到检索节点
END: END # 若无需调用工具(即可以直接回答),则结束流程
},
)

# 在 `retrieve` 节点执行后,根据文档相关性判断下一步操作
workflow.add_conditional_edges(
"retrieve",
# 调用 `grade_documents` 函数评估检索到的文档是否与问题相关
grade_documents,
# 根据评分结果决定流向:
# - 如果相关,进入 `generate_answer`
# - 如果不相关,进入 `rewrite_question`
# (该逻辑在 `grade_documents` 函数中返回 "generate_answer" 或 "rewrite_question")
)

# 添加固定边:生成答案后流程结束
workflow.add_edge("generate_answer", END)

# 重写问题后,回到初始节点重新判断是否需要检索
workflow.add_edge("rewrite_question", "generate_query_or_respond")

# 编译整个工作流,生成可执行的图结构
graph = workflow.compile()

image-20250826170834571

参考资料

《Agentic RAG》 —- Agentic RAG

前言

代码见learn-rag-langchain/multi-agent at main · zxj-2023/learn-rag-langchain

什么是多智能体

当我们谈论”多智能体”时,我们指的是由llm驱动的多个独立的agent以特定方式连接在一起。

每个agent可以拥有自己的提示、LLM、工具和其他自定义代码,以最佳方式与其他智能体协作。

这种思维方式非常适合用图来表示,就像 langgraph 所提供的那样。在这种方法中,每个智能体都是图中的一个节点,而它们之间的连接则表示为一条边。控制流由边管理,它们通过向图的状态中添加信息来进行通信。

多智能体架构梳理

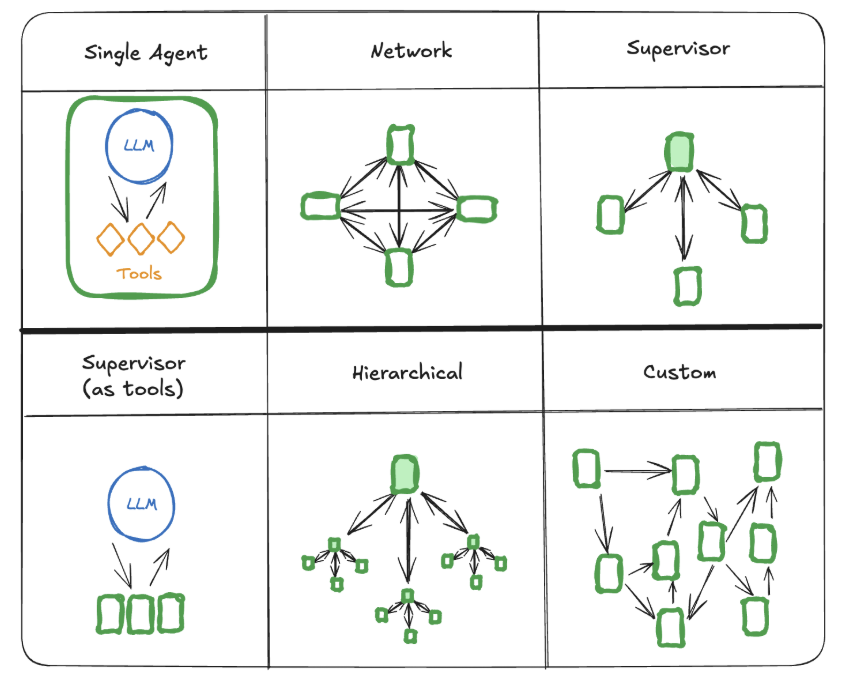
langgraph给我们提供了几种多智能体架构

image-20250818163359517

Network: 每个智能体可以与其他所有智能体通信。任何智能体都可以决定下一步调用哪个其他智能体。

Multi-agent network

Supervisor:每个智能体与一个单一的监督者智能体通信。监督者智能体决定下一步应该调用哪个智能体。

代理监督者 —- Agent Supervisor

Hierarchical: 你可以定义一个具有监督者监督者的多代理系统。这是监督者架构的泛化,并允许更复杂的控制流程。

层级代理团队 —- Hierarchical Agent Teams

Custom multi-agent workflow: 每个代理只与代理子集通信。流程的部分是确定的,只有一些代理可以决定下一步调用哪些其他代理。

Agent Supervisor

在本教程中,你将构建一个包含两个代理的监督者系统——一个研究专家和一个数学专家。

环境

1
pip install -U langgraph langgraph-supervisor langchain-tavily "langchain[openai]"

1. 创建工作代理

首先,让我们创建我们的专业工作代理——研究代理和数学代理:

研究代理

对于网络搜索,我们将使用 TavilySearch 工具来自 langchain-tavily :

1
2
3
4
5
6
from langchain_tavily import TavilySearch

web_search = TavilySearch(max_results=3,tavily_api_key="tvly-dev-")
web_search_results = web_search.invoke("南京在哪")

print(web_search_results["results"][0]["content"])

为了创建单个工作代理,我们将使用 LangGraph 的预构建代理。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
from langgraph.prebuilt import create_react_agent
from langchain_openai import ChatOpenAI

llm=ChatOpenAI(
model="qwen3-235b-a22b-thinking-2507",
api_key="sk-",
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1"
)

research_agent = create_react_agent(
model=llm,
tools=[web_search],
prompt=(
"你是一个研究代理。\n\n指令:\n- 仅协助与研究相关的任务,不得进行任何数学计算\n- 完成任务后,直接向主管回复\n- 仅回复你的工作结果,不得包含任何其他文字。"
),
name="research_agent",
)

让我们运行代理来验证它的行为是否符合预期。我们将使用 pretty_print_messages 辅助工具来美观地渲染流式代理输出

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
from langchain_core.messages import convert_to_messages


def pretty_print_message(message, indent=False):
"""
美化打印单条消息

Args:
message: 要打印的消息对象
indent: 是否需要缩进打印
"""
# 将消息转换为美观的HTML格式表示
pretty_message = message.pretty_repr(html=True)
if not indent:
# 如果不需要缩进,直接打印
print(pretty_message)
return

# 如果需要缩进,为每一行添加制表符前缀
indented = "\n".join("\t" + c for c in pretty_message.split("\n"))
print(indented)


def pretty_print_messages(update, last_message=False):
"""
美化打印消息更新

Args:
update: 包含消息更新的数据结构
last_message: 是否只打印最后一条消息
"""
is_subgraph = False # 标记是否为子图更新

# 检查更新是否为元组格式(包含命名空间信息)
if isinstance(update, tuple):
ns, update = update
# 如果命名空间为空,跳过父图更新的打印
if len(ns) == 0:
return

# 提取图ID并打印子图更新信息
graph_id = ns[-1].split(":")[0]
print(f"来自子图 {graph_id} 的更新:")
print("\n")
is_subgraph = True

# 遍历每个节点的更新
for node_name, node_update in update.items():
# 构造更新标签
update_label = f"来自节点 {node_name} 的更新:"
if is_subgraph:
# 如果是子图,添加缩进
update_label = "\t" + update_label

print(update_label)
print("\n")

# 将节点更新中的消息转换为消息对象列表
messages = convert_to_messages(node_update["messages"])
# 如果只要求最后一条消息,则截取最后一条
if last_message:
messages = messages[-1:]

# 打印每条消息
for m in messages:
pretty_print_message(m, indent=is_subgraph)
print("\n")
1
2
3
4
for chunk in research_agent.stream(
{"messages": [{"role": "user", "content": "南京在哪?"}]}
):
pretty_print_messages(chunk)
数学代理

对于数学代理工具,我们将使用纯 Python 函数:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
def add(a: float, b: float):
"""将两个数字相加。"""
return a + b


def multiply(a: float, b: float):
"""将两个数字相乘。"""
return a * b


def divide(a: float, b: float):
"""将两个数字相除。"""
return a / b


math_agent = create_react_agent(
model=llm,
tools=[add, multiply, divide],
prompt=(
"你是一个数学代理。\n\n"
"指令:\n"
"- 仅协助处理数学相关任务\n"
"- 完成任务后,直接回复给主管\n"
"- 仅回复你的工作结果,不要包含任何其他文字。"
),
name="math_agent",
)

让我们运行数学代理:

1
2
3
4
for chunk in math_agent.stream(
{"messages": [{"role": "user", "content": "what's (3 + 5) x 7"}]}
):
pretty_print_messages(chunk)

2.创建监督者 langgraph-supervisor

为了实现我们的多智能体系统,我们将使用预构建的 langgraph-supervisor 库中的 create_supervisor

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
from langgraph_supervisor import create_supervisor
from langchain.chat_models import init_chat_model

supervisor = create_supervisor(
model=llm,
agents=[research_agent, math_agent],
prompt=(
"你是一个管理两个代理的主管:\n"
"- 一个研究代理。将研究相关任务分配给这个代理\n"
"- 一个数学代理。将数学相关任务分配给这个代理\n"
"一次只分配工作给一个代理,不要并行调用代理。\n"
"不要自己做任何工作。"
),
add_handoff_back_messages=True,
output_mode="full_history",
).compile()
1
2
3
from IPython.display import display, Image

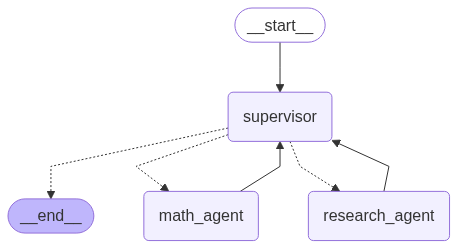
display(Image(supervisor.get_graph().draw_mermaid_png()))

image-20250819113009108

现在让我们用一个需要两个代理的查询来运行它:

研究代理将查找必要的 GDP 信息;数学代理将执行除法以找到纽约州 GDP 的百分比,如所请求

3.从头创建监督者

现在让我们从头实现这个多智能体系统。我们需要:

  1. 设置主管如何与各个代理进行沟通
  2. 创建监督代理
  3. 将监督代理和工作代理组合成一个多代理图。
设置代理通信

我们需要定义一种方式,让监督代理能够与工作代理进行通信。在多代理架构中,实现这一功能的一种常见方法是使用handoffs,即一个代理将控制权交给另一个代理。交接允许你指定:

  • destination:要转移到的目标代理
  • payload:要传递给该智能体的信息

我们将通过handoff tools(转接工具)实现转接,并将这些工具交给监督代理:当监督代理调用这些工具时,它将控制权转交给工作代理,并将完整消息历史传递给该代理。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
79
80
81
82
83
84
from typing import Annotated
from langchain_core.tools import tool, InjectedToolCallId
from langgraph.prebuilt import InjectedState
from langgraph.graph import StateGraph, START, MessagesState
from langgraph.types import Command


def create_handoff_tool(*, agent_name: str, description: str | None = None):
"""
创建一个“交接”工具函数,用于在 LangGraph 的 Supervisor-Worker 架构中
把当前对话状态移交给指定名称的子 Agent。

参数
----
agent_name : str
目标子 Agent 的名称,必须与 Supervisor 图中注册的节点名一致。
description : str | None
工具的描述文本。如果为 None,则使用默认描述 "Ask {agent_name} for help."。

返回
----
handoff_tool : Callable
一个已用 @tool 装饰的函数,可直接注入到 Supervisor 的工具列表。
"""
# 动态生成工具名,例如 agent_name="math_agent" -> "transfer_to_math_agent"
name = f"transfer_to_{agent_name}"

# 如果调用者没有提供描述,则使用默认描述
description = description or f"Ask {agent_name} for help."

# 用 LangGraph 的 @tool 装饰器注册工具
@tool(name, description=description)
def handoff_tool(
state: Annotated[MessagesState, InjectedState],
tool_call_id: Annotated[str, InjectedToolCallId],
) -> Command:
"""
实际执行交接逻辑的工具函数。

参数
----
state : MessagesState
当前对话状态,由 LangGraph 注入。
tool_call_id : str
本次工具调用的唯一 ID,由 LangGraph 注入。

返回
----
Command
一个 LangGraph Command 对象,告诉框架:
- goto=agent_name : 跳转到哪个子 Agent
- update : 更新后的状态
- graph=Command.PARENT : 在父图(Supervisor)作用域内执行
"""
# 构造一条工具消息,记录交接动作
tool_message = {
"role": "tool",
"content": f"Successfully transferred to {agent_name}",
"name": name,
"tool_call_id": tool_call_id,
}

# 使用 Command 把对话状态连同新消息一起发送到目标 Agent
return Command(
goto=agent_name,
update={**state, "messages": state["messages"] + [tool_message]},
graph=Command.PARENT,
)

# 返回已装饰的工具函数,供 Supervisor 添加进 tools 列表
return handoff_tool


# 创建研究代理的交接工具
assign_to_research_agent = create_handoff_tool(
agent_name="research_agent",
description="Assign task to a researcher agent.",
)

# 创建数学代理的交接工具
assign_to_math_agent = create_handoff_tool(
agent_name="math_agent",
description="Assign task to a math agent.",
)
创建监督代理

然后,我们使用刚刚定义的交接工具来创建监督代理。我们将使用预构建的 create_react_agent :

1
2
3
4
5
6
7
8
9
10
11
12
supervisor_agent = create_react_agent(
model=llm,
tools=[assign_to_research_agent, assign_to_math_agent],
prompt=(
"你是一个管理两个代理的主管:\n"
"- 一个研究代理。将研究相关任务分配给这个代理\n"
"- 一个数学代理。将数学相关任务分配给这个代理\n"
"一次只分配工作给一个代理,不要并行调用代理。\n"
"不要自己做任何工作。"
),
name="supervisor",
)
创建多智能体图

将这些内容整合起来,让我们为我们的整体多代理系统创建一个图。我们将添加监督代理和各个代理作为子图节点。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
from langgraph.graph import END

# 定义多代理主管图
supervisor = (
StateGraph(MessagesState)
# 注意:`destinations` 仅用于可视化,不影响运行时行为
.add_node(supervisor_agent, destinations=("research_agent", "math_agent", END))
.add_node(research_agent)
.add_node(math_agent)
.add_edge(START, "supervisor")
# 总是返回到主管
.add_edge("research_agent", "supervisor")
.add_edge("math_agent", "supervisor")
.compile()
)

在这个代码中,去 research_agent 和 math_agent 的条件边是通过工具调用实现的,而不是显式的条件边。

工作机制:

  1. 工具作为交接手段:

    • assign_to_research_agent 和 assign_to_math_agent 这两个工具被添加到 supervisor_agent 中
    • 当 supervisor_agent 决定需要某个代理帮助时,它会调用相应的工具
  2. 工具内部实现交接:

    1
    2
    3
    4
    5
    6
    def handoff_tool(...) -> Command:
    return Command(
    goto=agent_name, # 这里指定了要跳转到哪个代理
    update={...},
    graph=Command.PARENT,
    )
  3. 隐式的条件边:

    • 当 supervisor_agent 调用 assign_to_research_agent 工具时 → 自动跳转到 research_agent
    • 当 supervisor_agent 调用 assign_to_math_agent 工具时 → 自动跳转到 math_agent

什么是 Command 机制

Command 机制是 LangGraph 提供的一种显式控制流程跳转的方式。它允许工具或节点直接指定下一步要执行什么操作,而不需要通过传统的条件边路由。

Command 的核心概念

1
2
3
4
5
6
7
from langgraph.types import Command

Command(
goto=agent_name, # 要跳转到的目标节点
update=state_update, # 要更新的状态
graph=Command.PARENT # 在哪个图中执行(父图/子图)
)

请注意,我们已经从工作代理添加了明确的边回到主管——这意味着它们保证会将控制权返回给主管。如果你希望代理直接响应用户(即,将系统转变为路由器),你可以移除这些边。

Multi-agent network

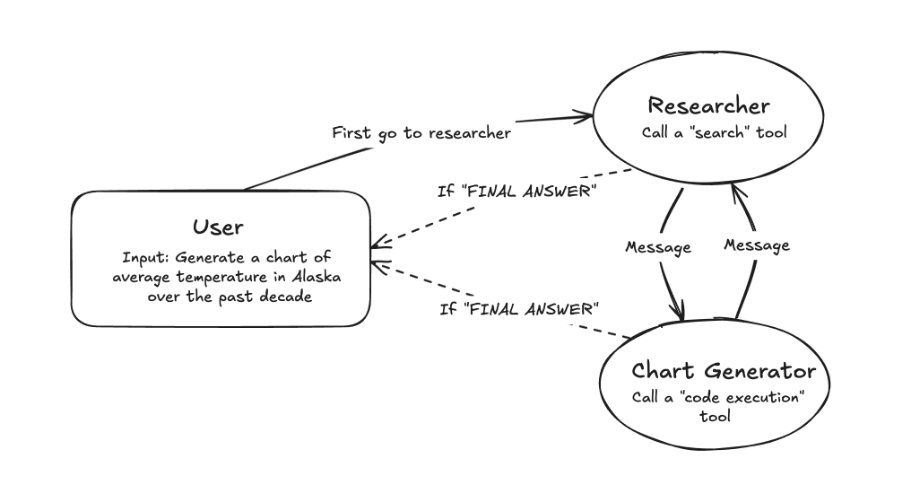
一个单一智能体通常可以使用单个领域内的一小批工具来有效运作,但即使使用像 gpt-4 这样强大的模型,使用多个工具时也可能效果不佳。

处理复杂任务的一种方法是采用“分而治之”的方法:为每个任务或领域创建一个专门的智能体,并将任务路由到正确的“专家”。这是一个多智能体网络架构的例子。

image-20250819150039818

这个多agent架构,就像多个agent进行讨论,所以也叫Multi Agent Collaboration,但是给我的感觉,比较混乱,agent直接的路由很难去定义,agent一多就搞不清楚了,所以这里也不实战了。

Hierarchical Agent Teams

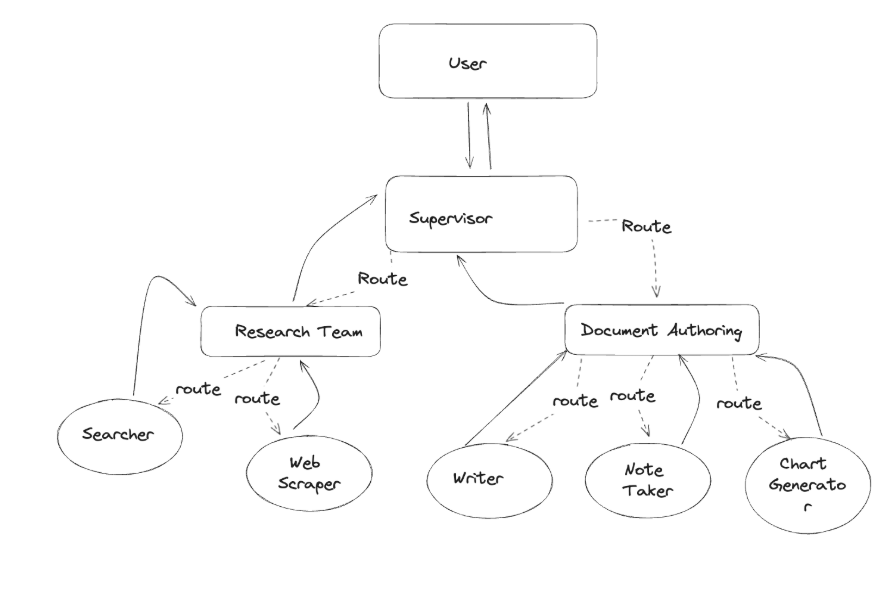
对于某些应用,如果工作按层次分布,系统可能会更有效。你可以通过组合不同的子图,并创建一个顶层监督者以及中层监督者来实现这一点。

image-20250819151813264

使用预设的supervisor构建

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
76
77
78
# 1. 定义研究团队的代理
@tool
def web_search(query: str) -> str:
"""执行网络搜索"""
return f"搜索结果:关于'{query}'的最新信息..."

@tool
def analyze_data(data: str) -> str:
"""分析数据"""
return f"数据分析结果:{data}的趋势显示..."

research_agent = create_react_agent(
model=llm,
tools=[web_search, analyze_data],
prompt="你是一个研究专家,负责进行网络搜索和数据分析。",
name="research_specialist"
)

# 2. 定义数学团队的代理
@tool
def calculate_statistics(numbers: list[float]) -> str:
"""计算统计值"""
if not numbers:
return "错误:数据列表为空"
avg = sum(numbers) / len(numbers)
return f"统计结果:平均值={avg:.2f},数据点数量={len(numbers)}"

@tool
def solve_equation(equation: str) -> str:
"""解方程"""
return f"方程 {equation} 的解为:x = 42"

math_agent = create_react_agent(
model=llm,
tools=[calculate_statistics, solve_equation],
prompt="你是一个数学专家,负责统计计算和方程求解。",
name="math_specialist"
)

# 3. 创建研究团队主管
research_supervisor = create_supervisor(
model=llm,
agents=[research_agent],
prompt=(
"你是研究团队的主管。\n"
"你的团队有一个研究专家,负责网络搜索和数据分析。\n"
"根据任务需求,将工作分配给研究专家。\n"
"等待专家完成任务后,总结结果并报告给上级主管。"
),
name="research_supervisor"
).compile(name="research_supervisor")

# 4. 创建数学团队主管
math_supervisor = create_supervisor(
model=llm,
agents=[math_agent],
prompt=(
"你是数学团队的主管。\n"
"你的团队有一个数学专家,负责统计计算和方程求解。\n"
"根据任务需求,将工作分配给数学专家。\n"
"等待专家完成任务后,总结结果并报告给上级主管。"
),
name="math_supervisor"
).compile(name="math_supervisor")

# 5. 创建顶层主管
top_supervisor = create_supervisor(
model=llm,
agents=[research_supervisor, math_supervisor],
prompt=(
"你是顶层主管,管理两个专业团队:\n"
"- 研究团队:负责市场调研、数据分析等任务\n"
"- 数学团队:负责统计计算、方程求解等任务\n"
"根据任务的性质,将工作分配给相应的团队主管。\n"
"等待团队完成任务后,整合所有结果并给出最终报告。"
),
name="top_supervisor"
).compile(name="top_supervisor")

参考资料

LangGraph:多智能体工作流 —- LangGraph: Multi-Agent Workflows

Overview

前言

为了后续自己搭建全栈项目做准备,对react做一定的了解

学习目标:大致看懂react的基本语法,可以在ai的协助下完成前端的搭建

介绍

React 是 Facebook(现 Meta)于 2013 年开源的一套用于构建用户界面的 JavaScript 库,现由 React 核心团队与社区共同维护。

项目搭建

项目创建

1
npx create-react-app my-app

npx 是什么?

npm 5.2+ 自带的“包运行器”(Node Package eXecute)。类似uv

脚手架(Scaffold / Boilerplate)是什么?

  1. 定义:官方或社区提供的“项目模板生成器”,一条命令就能创建带目录结构、配置、脚本、依赖的完整项目骨架。
  2. 目的:
    • 省掉繁琐的初始化、Webpack/Rollup/Vite 配置、ESLint/TypeScript/测试等环境搭建。
    • 统一团队规范,降低新人上手成本。

启动开发服务器

1
2
cd my-app
npm start # 或 yarn start

目录速览(核心)

1
2
3
4
5
6
my-app
├─ public/ # 静态资源,index.html 是页面模板
├─ src/
│ ├─ App.js # 根组件
│ ├─ index.js # 应用入口(ReactDOM.createRoot)
└─ package.json # 依赖与脚本

JSX

JSX(JavaScript XML 的缩写)是 React 引入的一种语法糖(syntactic sugar)。它让你在 JavaScript 文件里直接写类 HTML 标记,然后由构建工具(Babel、TypeScript、esbuild、swc)把它翻译成普通的 JavaScript 函数调用。

如下

1
2
3
4
5
6
7
8
9
10
11
12
13
// 1. 找到 public/index.html 中 id="root" 的 DOM 节点,作为 React 应用的挂载点
const root = ReactDOM.createRoot(document.getElementById('root'));

// 2. 将根组件 <App /> 渲染到该挂载点
root.render(
// 3. <React.StrictMode> 是 React 提供的开发模式辅助工具
// 作用:在开发阶段自动检测潜在问题(如过时的 API、副作用重复执行等)
// 注意:它仅在开发环境生效,生产环境不会渲染任何额外 DOM
<React.StrictMode>
{/* 4. 项目真正的根组件 App,所有业务逻辑都从这里开始 */}
<App />
</React.StrictMode>
);

箭头函数

React(以及所有现代 JavaScript)里,“箭头”指的是 箭头函数(Arrow Function),语法是:

1
const 函数名 = (参数) => 返回值或语句块

它的作用可以概括为 “更简洁的函数声明 + 词法作用域的 this”。

通俗理解:把小括号的内容变成箭头后的内容

函数组件

函数组件 + JSX 的组合作用是:
以函数的形式返回“虚拟 DOM 描述”,交由 React 渲染成真实 DOM,而不是直接返回 HTML 组件或字符串。

  1. 函数组件的“返回值”
1
2
3
function Welcome(props) {
return <h1>Hello {props.name}</h1>;
}

经过 Babel 编译后等价于:

1
2
3
function Welcome(props) {
return React.createElement('h1', null, 'Hello ', props.name);
}

React.createElement 会生成一个纯 JS 对象(虚拟节点),而不是一段 HTML 字符串。

使用示例

1
2
3
4
5
6
7
8
9
10
// 1. 接收父组件传来的 props
function Card({ title, children }) {
// 2. 返回一段 JSX(最终会被编译成虚拟 DOM)
return (
<div className="card">
<h2>{title}</h2>
{children}
</div>
);
}

使用:

1
2
3
<Card title="函数组件">
<p>Hello, world!</p>
</Card>

DOM(Document Object Model,文档对象模型)是浏览器在内存里把一份 HTML/XML 文档表示成树形结构的编程接口(API)。

每个节点(元素、文本、注释…)都是一个对象,拥有属性与方法,例如:

1
2
3
const title = document.getElementById('title');
title.textContent = 'Hi React'; // 改文本
title.style.color = 'red'; // 改样式

插值写法

在 React 中,“插值”专指把一段 JavaScript 表达式的实时结果塞进 JSX 的写法。
核心符号只有一对花括号 { },记住口诀:“JSX 里凡是 {} 包起来的,就是 JavaScript 运行后的值。”

基本文本插值

1
2
const name = 'React';
<h1>Hello, {name}!</h1> // → Hello, React!

属性插值

1
2
3
4
5
6
function App() {
const mytitle="hello"
return (
<div title={mytitle}></div>
);
}

数据渲染

条件渲染

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
function App() {
const mytitle="hello"

let mycontent=null
const flag=true
if(flag){
mycontent=<h2>hello</h2>
}
else{
mycontent=<h2>world</h2>
}
return (
<div title={mytitle}>{mycontent}</div>
);
}

列表渲染

1
2
3
4
5
6
7
8
9
function App() {
const list=['1','2','3']
const mycontent=list.map((item)=>{
return <li>{item}</li>
})
return (
<div>{mycontent}</div>
);
}
  1. .map((item) => { ... })
    ‑ Array.prototype.map:遍历数组,把每个元素依次交给回调函数处理,并返回一个新数组。
    ‑ (item) 是每次循环拿到的当前元素。
  2. return <li>{item}</li>
    ‑ 每一次循环里,把当前元素 item 用 JSX 插值语法 {item} 放进 <li> 标签里。

状态处理

1
2
3
4
5
6
7
8
9
10
11
12
13
import { useState } from 'react';
function App() {
const [mycontent,setmycontent]=useState("hello world");
function changeContent(){
setmycontent("hello world2");
}
return (
<>
<div>{mycontent}</div>
<button onClick={changeContent}>change</button>
</>
);
}

useState 是 React 提供的 Hook,让函数组件也能拥有内部状态(state)。可以通过更新函数,调用后触发重新渲染。

对象的状态更新

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
import { useState } from 'react';
function App() {
const [mycontent,setmycontent]=useState({
title:'hello world',
content :'hello world content'
});
function changeContent(){
setmycontent({
...mycontent,
content:'new content'
});
}
return (
<>
<div title={mycontent.title}>{mycontent.content}</div>
<button onClick={changeContent}>change</button>
</>
);
}

...mycontent 是 ES6 的 对象展开运算符(object spread)。
一句话:把 mycontent 里所有“旧属性”先抄出来,然后再覆盖/新增你后面写的属性。

react组件的使用

1
2
3
4
5
6
7
8
import { useState } from 'react';
function App() {
return (
<>
<img src={logo} className="App-logo" alt="logo" style={{ width: '100px',backgroundColor: 'grey'}}/>
</>
);
}
  1. className 代替 class
    传统 HTML 写 <img class="App-logo">;React 组件里必须用 className,因为 JSX 最终会被编译成 JavaScript 对象,而 class 是 JS 的保留关键字。

  2. 样式写成对象

HTML 写行内样式:style="width:100px;background-color:grey"
React 必须写成对象:

1
2
3
4
style={{
width: '100px',
backgroundColor: 'grey' // 驼峰命名
}}

因为 JSX 属性最终会变成 JS 对象的键值对,键名必须合法(驼峰),值可以是任何 JS 值(数字、变量、计算结果)。

  1. 最终产物是虚拟 DOM 节点

<img src={logo} ... /> 在浏览器里不会直接变成 <img> 标签,而是先被编译成:

1
2
3
4
5
6
React.createElement('img', {
src: logo,
className: 'App-logo',
alt: 'logo',
style: { width: '100px', backgroundColor: 'grey' }
});

React 再拿这个对象去做 diff、更新真实 DOM,而不是直接 innerHTML。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
function App() {

const imgdata={
className:"App-logo",
style:{
width:'100px',
backgroundColor:'grey'
}
}

return (
<>
<img src={logo} alt="logo" {...imgdata}/>
</>
);
}

利用 JSX 展开运算符(spread attributes) 把 imgdata 里的所有键值一次性“拍平”到 <img> 标签上

组件复用

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
function Article(props) {
return (
<div>
<h2>{props.title}</h2>
<p>{props.content}</p>
</div>
);
}

function App() {
return (
<>
<Article title="标签1" content="内容1" />
<Article title="标签2" content="内容2" />
</>
);
}

组件通信

组件通信的 4 条主线

1️⃣ 父 → 子:props
2️⃣ 子 → 父:回调函数
3️⃣ 隔代/任意:Context
4️⃣ 全局/远端:状态管理库(Zustand、Redux、React Query)

父 → 子

1
2
3
4
5
6
7
8
function Parent() {
const title = 'Hello React';
return <Child title={title} />;
}

function Child({ title }) {
return <h1>{title}</h1>;
}

子 → 父

1
2
3
4
5
6
7
8
9
10
11
12
13
function Parent() {
const [count, setCount] = useState(0);
return (
<>
<p>父:{count}</p>
<Child onInc={() => setCount(c => c + 1)} />
</>
);
}

function Child({ onInc }) {
return <button onClick={onInc}>子按钮 +1</button>;
}

父组件把“修改函数”通过 props 传给子组件,子组件在合适的时机调用它,把数据作为参数传回去。

react hooks

Hook 是什么?
Hook 是 React 16.8 引入的 函数级 API,让函数组件拥有

  • 状态(useState)
  • 生命周期(useEffect)
  • 上下文(useContext)
  • 自定义逻辑(自定义 Hook)
    而不必写 class。

参考资料

20分钟学会React Hooks 前端开发必看 AI编程工具 CodeGeeX 体验_哔哩哔哩_bilibili

前言

本文简单测试了一下langgraph官方提供的记忆管理工具,发现还是存在bug,我在a线程先让他记住我是张熙浚,然后又告诉他我不是张熙浚我是张俊细,在线程b询问他我是谁时,他还是认为我是张熙浚。记忆的管理部分确实是一个很大的问题,但中小开发者我认为还是直接使用人家造好的轮子方便些(我尝试去阅读了他的记忆管理工具的源码,以我目前的水平,想手搓花费的精力还是太多了)

我还有一个疑惑,我的理解是,当前记忆的存储基本上依赖于agent的决定,所以并不稳定,我也搞不清楚他什么时候会把哪些信息存入记忆,可以设置 schemas结构,控制存储的内容,但是长期记忆仅存储指定的这些信息,感觉还是有些鸡肋啊

代码见learn-rag-langchain/langmem at main · zxj-2023/learn-rag-langchain

介绍

LangMem 是 LangChain 推出的开源 SDK,通过一套存储-提取-优化机制,让 Agent 能够在多轮、多天甚至多用户之间持续学习、记住用户偏好并不断改进回答。

LangMem 的记忆工具按两个层次的集成模式组织:

  1. 核心 API

LangMem 的核心是提供无副作用地转换记忆状态的函数。这些原语是记忆操作的构建块:

  • 记忆管理器:根据新的对话信息,提取新记忆、更新或删除过时记忆,并从现有记忆中进行整合和泛化。
  • 提示优化器:根据对话信息(可选反馈)更新提示规则和核心行为。

这些核心函数不依赖于任何特定的数据库或存储系统。您可以在任何应用程序中使用它们。

  1. 有状态集成

上一层依赖于 LangGraph 的长期记忆存储。这些组件使用上述核心 API 来转换存储中存在的记忆,并在新对话信息传入时根据需要进行更新/插入或删除:

image-20250814152044798

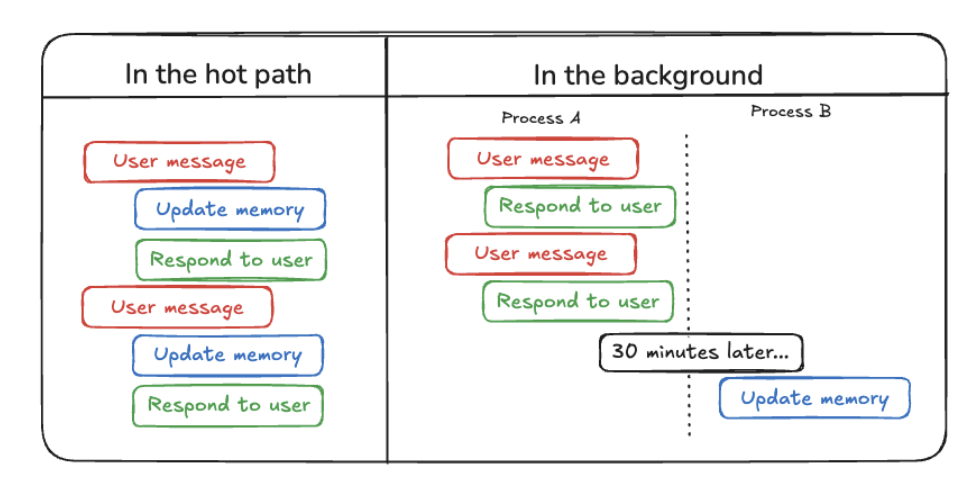
langmem可以通过两种方式创建记忆

  1. 在热路径中: Agent 使用工具主动保存笔记。
  2. 在后台:记忆从对话中自动“潜意识地”提取。

热路径快速入门指南

在本指南中,我们将创建一个 LangGraph Agent,它通过 LangMem 的 manage_memory 工具来主动管理自己的长期记忆。

create_manage_memory_tool

create_manage_memory_tool通过创建一个工具(Tool),这个工具可以被 agent用来管理持久化记忆。这些记忆可以在不同的对话、会话甚至应用重启后依然存在。

  1. 持久化存储 (Persistent Storage): 它利用了 LangGraph 提供的 BaseStore 接口。这使得数据可以存储在内存、数据库(如 Postgres)等地方,而不是仅仅存在于程序的运行时内存中。
  2. 命名空间 (Namespace): 为了组织和隔离不同用户或不同类型的记忆,数据被存储在层级化的命名空间中。例如,("memories", "user-123") 可以确保用户 “user-123” 的记忆与其他用户或系统记忆分开。命名空间可以包含占位符(如 {langgraph_user_id}),在实际执行时会被具体的配置值替换。

  3. 记忆 (Memory): 在这个上下文中,一个“记忆”就是存储在 BaseStore 中的一个数据项(Item)。它有一个唯一的 key(通常是 UUID),一个 namespace,一个 value(存储实际内容),以及创建和更新时间戳。

  4. 工具 (Tool): 在 AI 应用中,工具是代理(Agent)可以调用的函数或能力。这个函数创建的工具就是一个封装好的、可以被 Agent 调用的函数,用于执行创建、更新、删除记忆的操作。

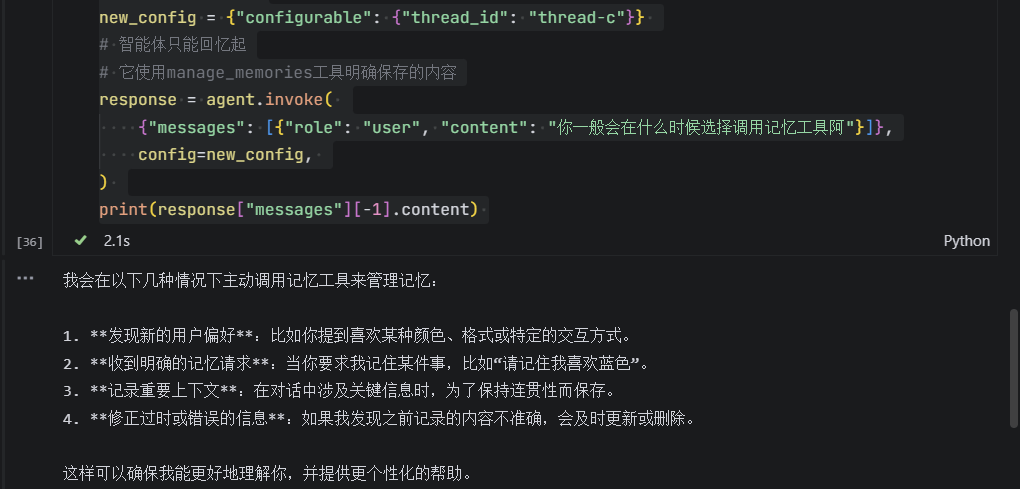
什么时候agent会调用记忆工具

image-20250814163150589

ai是这样回答的,ReAct架构的agent是否调用工具由他自己决定

实战

导入库

1
2
3
4
5
6
7
8
from langgraph.checkpoint.memory import MemorySaver
from langgraph.prebuilt import create_react_agent
from langgraph.store.memory import InMemoryStore
from langgraph.utils.config import get_store
from langmem import (
# 让智能体创建、更新和删除记忆
create_manage_memory_tool,
)

返回记忆提示词

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
def prompt(state):
"""为LLM准备消息。"""
# 从配置的上下文变量中获取存储;
store = get_store() # 与提供给 `create_react_agent` 的相同
memories = store.search(
# 在与我们为智能体配置的相同命名空间内搜索
("memories",),
query=state["messages"][-1].content,
)
system_msg = f"""You are a helpful assistant.

## Memories
<memories>
{memories}
</memories>
"""
return [{"role": "system", "content": system_msg}, *state["messages"]]

定义store与checkpoint

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
from langchain import embeddings
from langchain_openai import OpenAIEmbeddings
embedding=OpenAIEmbeddings(
api_key="sk-",
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
model="text-embedding-v4",
check_embedding_ctx_length = False,
dimensions=1536
)
store = InMemoryStore(
index={ # 存储提取的记忆
"dims": 1536,
"embed": embedding,
}
)
checkpointer = MemorySaver() # 检查点图状态

定义agent

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
from langchain_openai import ChatOpenAI
model_qwen=ChatOpenAI(
api_key="sk-",
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
model="qwen3-30b-a3b-instruct-2507",
)

agent = create_react_agent(
model=model_qwen,
prompt=prompt,
tools=[ # 添加记忆工具
# 智能体可以调用 "manage_memory" 来
# 通过ID创建、更新和删除记忆
# 命名空间为记忆添加作用域。要
# 为每个用户限定记忆范围,使用 ("memories", "{user_id}"):
create_manage_memory_tool(namespace=("memories",)),
],
# 我们的记忆将存储在这个提供的BaseStore实例中
store=store,
# 图的"状态"将在每个节点完成执行后进行检查点
# 用于跟踪聊天历史和持久执行
checkpointer=checkpointer,
)

可视化图

1
agent.get_graph().draw_mermaid_png(output_file_path="agent.png")

在线程a让agent记住我们的偏好

1
2
3
4
5
6
7
8
9
10
11
12
config = {"configurable": {"thread_id": "thread-a"}} 
agent.invoke(
{
"messages": [
{"role": "user", "content": "我喜欢黑色的显示模式"}
]
},
# 我们将通过使用具有相同thread_id的config
# 来继续对话(thread-a)
config=config,
)
print(response["messages"][-1].content)
1
是的,我知道!你偏好黑色显示模式。我会在后续交互中保持这一设置。

在线程b查看是否记住

1
2
3
4
5
6
7
8
9
10
# 新线程 = 新对话!
new_config = {"configurable": {"thread_id": "thread-b"}}
# 智能体只能回忆起
# 它使用manage_memories工具明确保存的内容
response = agent.invoke(
{"messages": [{"role": "user", "content": "你好。你还记得我吗?你知道我有什么偏好吗?"}]},
config=new_config,
)
print(response["messages"][-1].content)

1
你好!虽然我无法记住你作为个体的详细信息,但我可以访问一些关于你的偏好信息。根据之前的记录,我知道你偏好使用黑色显示模式。如果你还有其他偏好或希望我记住什么,请告诉我,我会帮你记录下来。

后台快速入门指南

本指南将向您展示如何使用 create_memory_store_manager 在后台提取和整合记忆。当记忆在后台处理时,智能体将正常继续运行。

  1. Runnable: LangChain/LangGraph 中的核心抽象,代表一个可以被调用(invoke/ainvoke)来处理输入并产生输出的单元。MemoryStoreManager 本身就是一个 Runnable。

  2. BaseStore: LangGraph 提供的持久化存储接口。Manager 会使用它来读取(搜索)和写入(创建、更新、删除)记忆。

  3. Memory (记忆): 在 Manager 的上下文中,记忆通常是指从对话中提取的、值得保存的片段信息(如用户偏好、事实等)。它们存储在 BaseStore 中,有自己的 namespace 和 key。

  4. Schema (模式): 一个 Pydantic 模型,用于定义记忆的结构。这允许你强制记忆遵循特定的格式(例如,包含 category, preference, context 字段)。如果未提供 schemas,则默认使用非结构化的字符串。

  5. Namespace (命名空间): 用于组织存储在 BaseStore 中的记忆。支持使用占位符(如 {langgraph_user_id})进行动态配置。

  6. 自动化流程:

    Manager 会自动执行以下步骤:

    • 搜索 (Search): 根据新对话内容,在 BaseStore 中查找相关的现有记忆。
    • 分析/提取 (Analyze/Extract): 使用 LLM 分析新对话和检索到的记忆,决定是否需要创建新记忆、更新现有记忆或删除过时记忆。
    • 应用更改 (Apply Changes): 将分析结果(记忆的增删改)写回到 BaseStore。

实战

导入库

1
2
3
4
5
from langchain.chat_models import init_chat_model 
from langgraph.func import entrypoint
from langgraph.store.memory import InMemoryStore

from langmem import ReflectionExecutor, create_memory_store_manager

定义store

1
2
3
4
5
6
7
8
9
10
11
12
13
14
from langchain_openai import OpenAIEmbeddings
embedding=OpenAIEmbeddings(
api_key="sk-",
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
model="text-embedding-v4",
check_embedding_ctx_length = False,
dimensions=1536
)
store = InMemoryStore(
index={ # 存储提取的记忆
"dims": 1536,
"embed": embedding,
}
)

创建记忆管理器

1
2
3
4
5
6
7
8
9
10
# 创建记忆管理器 Runnable 来从对话中提取记忆
memory_manager = create_memory_store_manager(
model_qwen,
# 将记忆存储在 "memories" 命名空间(即目录)中
namespace=("memories",),
instructions="用中文存储记忆。"
)

# 包装 memory_manager 以处理延迟的后台处理
executor = ReflectionExecutor(memory_manager)

对每条消息都进行记忆处理存在以下缺点: - 当消息快速连续到达时,会产生冗余工作 - 在对话中途进行处理时,上下文不完整 - 不必要的 token 消耗

ReflectionExecutor 可以延迟记忆处理并取消冗余工作。

创建工作流

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
from langchain_openai import ChatOpenAI
model_qwen=ChatOpenAI(
api_key="sk-",
base_url="https://dashscope.aliyuncs.com/compatible-mode/v1",
model="qwen3-30b-a3b-instruct-2507",
)

@entrypoint(store=store) # 创建一个 LangGraph 工作流
async def chat(message: str):
response = model_qwen.invoke(message)

# memory_manager 从对话历史中提取记忆
# 我们将以 OpenAI 的消息格式提供它
to_process = {"messages": [{"role": "user", "content": message}] + [response]}
await memory_manager.ainvoke(to_process)
return response.content

# 正常运行对话
response = await chat.ainvoke(
"记住我是张熙浚",
)
print(response)

查看记忆

1
print(store.search(("memories",)))

参考资料

简介 - LangChain 框架

核心概念 - LangChain 框架

前言

就是client调用agent那一块,感觉还是比较困惑,我看例子是要通过定义给的execut和cancel函数,那就意味着agent提供者都要去自己去定义这些怎么执行的函数,还有描述agent的skill和card,工作量明显比mcp大了很多,可能这也是现在a2a传播没有mcp好的一大原因吧,我的理解,不知道对不对


思考:现在利用a2a搭建多agent的现实例子多吗,从概念上,我认为a2a的思路是没问题的,但感觉下来,现在大多数的多agent的实现方式还是像langgraph中条件边来控制使用哪个agent,是不是因为a2a对于中小开发者搭建起来还是有些复杂,但我还是认为他这种于mcp类似,模块化,可以自定义的形式会是后续方向。就像现在的mcp client,可以在市场上下载自己想要的mcp,利用a2a协议,用户可以在市场上下载想用的agent,搭建自己的多agent管家,现在市场上有类似的产品吗?

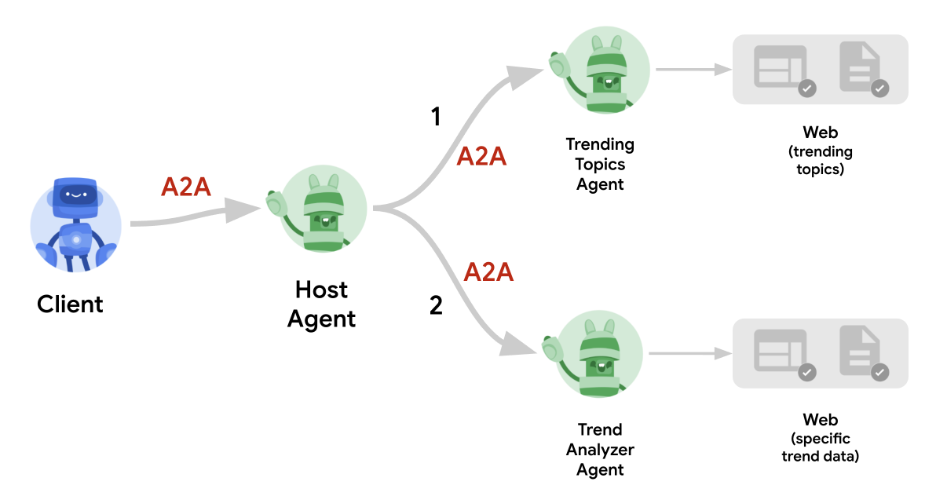
a2a协议其实与mcp类似,对象不同,一个是mcp client与mcp server(tool),一个是agent client与agent server。具体实现中,需要完成对agent server的信息暴露与executor的编写,以便让client正确调用agent,调用前要启动服务。

一个agent server所要包含的要素包括:1.AgentSkill,用于描述agent可以实现的能力

2.AgentCard,描述agent的信息,包括运行的url,输入和返回的数据类型,所包含的skills

3.AgentExecutor,定义了如何执行智能体,通过定义execute方法,以便正确调用agent server

4.通过DefaultRequestHandler,封装调用agent的接口,不用再手写接口,只要提供一个 executor 和一个 store 即可,收到对话内容后,DefaultRequestHandler 会把对话打包成任务,交给 HelloWorldAgentExecutor 去执行。、

5.通过A2AStarletteApplication打包成应用(如fastapi),他的作用如下:1.把这个 handler 注册成真正的 HTTP 路由,于是外部就能通过 POST / 调用上述 JSON-RPC 方法。2.对外暴露名片

什么是A2A协议

A2A 协议(Agent2Agent Protocol,智能体间通信协议)是 Google 在 2025 年 4 月发布并开源的首个 AI 智能体交互标准。它通过统一的通信规范,解决不同团队、不同框架、不同供应商开发的 AI 智能体如何“对话”和协同工作的问题。

与mcp区分,MCP 解决 “单个智能体如何调用外部工具/数据” 的问题,而A2A 解决 “多个智能体如何协同完成任务” 的问题。

image-20250809222720192

为什么要使用A2A协议

随着 AI 应用深化,单一“万能”模型难以兼顾所有领域。A2A 鼓励构建“小而专”的智能体生态:

  • 每个智能体专注一个领域(如订票、报税、图像处理)。
  • 通过 A2A 协议,它们像乐高积木一样自由组合,快速响应新的业务需求。

比如你让一个agent使用多个工具,不仅会浪费tokens,也会降低其调用工具的准确性。所有,专业的领域使用专业的agent,而agent间的通信便要依靠A2A协议

环境配置

克隆仓库

如果你还没有克隆,请克隆 A2A Samples 仓库:

1
2
git clone https://github.com/a2aproject/a2a-samples.git -b main --depth 1
cd a2a-samples

Python 环境和 SDK 安装

我们推荐为 Python 项目使用虚拟环境。A2A Python SDK 使用 uv 进行依赖管理,但你也可以使用 pip 与 venv。

  1. 创建并激活虚拟环境:

    使用 venv(标准库):

    1
    2
    python -m venv .venv
    source .venv/bin/activate
  2. 安装所需的 Python 依赖项以及 A2A SDK 及其依赖项:

    1
    pip install -r samples/python/requirements.txt

Agent Skills & Agent Card

Agent Skills

一个代理技能描述了代理可以执行的具体能力或功能。它是告诉客户端代理擅长哪些任务的构建模块。

AgentSkill 的关键属性(定义在 a2a.types 中):

  • id: 技能的唯一标识符。
  • name: 人类可读的名称。
  • description:对技能功能的更详细说明。
  • tags:用于分类和发现的关键词。
  • examples:示例提示或使用案例。
  • inputModes / outputModes: 支持的输入和输出媒体类型(例如,”text/plain”,”application/json”)。

在 __main__.py 中,你可以看到如何为 Helloworld 代理定义一个技能:

1
2
3
4
5
6
7
skill = AgentSkill(
id='hello_world',
name='Returns hello world',
description='just returns hello world',
tags=['hello world'],
examples=['hi', 'hello world'],
)

这个技能非常简单:它的名称是 “Returns hello world”,并且主要处理文本。

Agent Card

代理卡是一个 A2A 服务器提供的 JSON 文档,通常位于 .well-known/agent-card.json 端点。它就像代理的数字名片。

AgentCard 的关键属性(定义在 a2a.types 中):

  • name, description, version: 基本身份信息。
  • url:A2A 服务可访问的端点。
  • capabilities:指定支持的 A2A 功能,如 streaming 或 pushNotifications。
  • defaultInputModes / defaultOutputModes: 代理的默认媒体类型。
  • skills: 代理提供的 AgentSkill 对象列表。

helloworld 示例定义其 Agent Card 如下:

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
# This will be the public-facing agent card
public_agent_card = AgentCard(
name='Hello World Agent',
description='Just a hello world agent',
url='http://localhost:9999/',
version='1.0.0',
# 默认输入模式:Agent 能够接收的输入类型列表,这里仅支持纯文本
default_input_modes=['text'],
# 默认输出模式:Agent 能够产生的输出类型列表,这里仅返回纯文本
default_output_modes=['text'],
# 能力声明:告知调用方 Agent 支持的能力,例如是否支持流式输出(streaming)
capabilities=AgentCapabilities(streaming=True),
skills=[skill], # Only the basic skill for the public card
supports_authenticated_extended_card=True,
)

这张卡片告诉我们代理名为 “Hello World Agent”,运行在 http://localhost:9999/,支持文本交互,并具有 hello_world 技能。它还表明支持公开认证,意味着无需特定凭证。
Agent Executor

A2A 代理处理请求和生成响应/事件的核心逻辑由一个 Agent Executor 负责。A2A Python SDK 提供了一个抽象基类 a2a.server.agent_execution.AgentExecutor 供你实现。

AgentExecutor 接口

AgentExecutor 类定义了两个主要方法:

  • async def execute(self, context: RequestContext, event_queue: EventQueue) : 处理期望响应或事件流的传入请求。它处理用户输入(可通过 context 获取)并使用 event_queue 发送 Message、Task、TaskStatusUpdateEvent 或 TaskArtifactUpdateEvent 对象。
  • async def cancel(self, context: RequestContext, event_queue: EventQueue) : 处理取消正在进行的任务的请求。

RequestContext 提供有关传入请求的信息,例如用户消息和任何现有的任务详情。EventQueue 由执行器使用,用于将事件发送回客户端。

Helloworld AgentExecutor

让我们看看 agent_executor.py。它定义了 HelloWorldAgentExecutor。

  1. 代理(HelloWorldAgent):这是一个简单的辅助类,封装了实际的“业务逻辑”。

    1
    2
    3
    4
    5
    class HelloWorldAgent:
    """Hello World Agent."""

    async def invoke(self) -> str:
    return 'Hello World'

    它有一个简单的 invoke 方法,返回字符串”Hello World”。

  2. 执行器(HelloWorldAgentExecutor):这个类实现了 AgentExecutor 接口。

    • __init__:

      1
      2
      3
      4
      5
      class HelloWorldAgentExecutor(AgentExecutor):
      """Test AgentProxy Implementation."""

      def __init__(self):
      self.agent = HelloWorldAgent()

      它实例化了 HelloWorldAgent。

    • execute:

      1
      2
      3
      4
      5
      6
      7
      async def execute(
      self,
      context: RequestContext,
      event_queue: EventQueue,
      ) -> None:
      result = await self.agent.invoke()
      await event_queue.enqueue_event(new_agent_text_message(result))

      当收到一个 message/send 或 message/stream 请求时(这两种请求在这个简化的执行器中均由 execute 处理):

      1. 它调用 self.agent.invoke() 来获取 “Hello World” 字符串。
      2. 它使用 new_agent_text_message 工具函数创建一个 A2A Message 对象。
      3. 它将此消息入队到 event_queue。底层的 DefaultRequestHandler 随后会处理这个队列以向客户端发送响应。对于像这样的一条消息,在流关闭之前,它将导致一个 message/send 的单一响应或一个 message/stream 的单一事件。
    • cancel: Helloworld 示例的 cancel 方法简单地抛出一个异常,表明这个基本代理不支持取消操作。

      1
      2
      3
      4
      async def cancel(
      self, context: RequestContext, event_queue: EventQueue
      ) -> None:
      raise Exception('cancel not supported')

AgentExecutor 充当 A2A 协议(由请求处理器和服务器应用程序管理)与您的代理特定逻辑之间的桥梁。它接收关于请求的上下文信息,并使用事件队列来通信结果或更新。

启动server

现在我们已经有了 Agent Card 和 Agent Executor,可以设置并启动 A2A 服务器。

A2A Python SDK 提供了一个 A2AStarletteApplication 类,简化了运行符合 A2A 标准的 HTTP 服务器。它使用 Starlette 作为 Web 框架,通常与 Uvicorn 等 ASGI 服务器一起运行。

让我们再次查看 __main__.py,看看服务器是如何初始化和启动的。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
43
44
45
46
47
48
49
50
51
52
53
54
55
56
57
58
59
60
61
62
63
64
65
66
67
68
69
70
71
72
73
74
75
import uvicorn

from a2a.server.apps import A2AStarletteApplication
from a2a.server.request_handlers import DefaultRequestHandler
from a2a.server.tasks import InMemoryTaskStore
from a2a.types import (
AgentCapabilities,
AgentCard,
AgentSkill,
)
from agent_executor import (
HelloWorldAgentExecutor, # type: ignore[import-untyped]
)


if __name__ == '__main__':
skill = AgentSkill(
id='hello_world',
name='返回 hello world',
description='简单地返回 hello world',
tags=['hello world'],
examples=['hi', 'hello world'],
)

extended_skill = AgentSkill(
id='super_hello_world',
name='返回 SUPER Hello World',
description='仅限已认证用户使用的更热情的问候。',
tags=['hello world', 'super', 'extended'],
examples=['super hi', 'give me a super hello'],
)

# 这是面向公众的 Agent 卡片
public_agent_card = AgentCard(
name='Hello World Agent',
description='只是一个 hello world 代理',
url='http://localhost:9999/',
version='1.0.0',
default_input_modes=['text'],
default_output_modes=['text'],
capabilities=AgentCapabilities(streaming=True),
skills=[skill], # 公开卡片仅包含基础技能
supports_authenticated_extended_card=True,
)

# 这是已认证用户的扩展 Agent 卡片
# 额外包含 'extended_skill'
specific_extended_agent_card = public_agent_card.model_copy(
update={
'name': 'Hello World Agent - Extended Edition', # 使用不同名称以便区分
'description': '面向已认证用户的完整功能 hello world 代理。',
'version': '1.0.1', # 甚至可以是不同的版本
# capabilities 及其他字段(如 url、default_input_modes、default_output_modes、
# supports_authenticated_extended_card)均从 public_agent_card 继承,
# 除非在此处另行指定。
'skills': [
skill,
extended_skill,
], # 扩展卡片包含两个技能
}
)

request_handler = DefaultRequestHandler(
agent_executor=HelloWorldAgentExecutor(),
task_store=InMemoryTaskStore(),
)

server = A2AStarletteApplication(
agent_card=public_agent_card,
http_handler=request_handler,
extended_agent_card=specific_extended_agent_card,
)

# 使用 uvicorn 启动服务,监听 0.0.0.0:9999
uvicorn.run(server.build(), host='0.0.0.0', port=9999)

我们来分解一下:

  1. DefaultRequestHandler:
    • SDK 提供了 DefaultRequestHandler。这个处理器接收你的 AgentExecutor 实现(这里,HelloWorldAgentExecutor)和一个 TaskStore(这里,InMemoryTaskStore)。
    • 它将传入的 A2A RPC 调用路由到你的执行器的适当方法上(比如 execute 或 cancel)。
    • TaskStore 被 DefaultRequestHandler 用来管理任务的生命周期,特别是对于有状态交互、流式传输和重新订阅。即使你的代理执行器很简单,处理器也需要一个任务存储。
  2. A2AStarletteApplication:
    • A2AStarletteApplication 类使用 agent_card 和 request_handler(在其构造函数中称为 http_handler)进行实例化。
    • agent_card 至关重要,因为服务器将在 /.well-known/agent-card.json 端点(默认情况下)上公开它。
    • request_handler 负责通过与其 AgentExecutor 交互来处理所有传入的 A2A 方法调用。
  3. uvicorn.run(server_app_builder.build(), ...):
    • A2AStarletteApplication 有一个 build() 方法,用于构建实际的 Starlette 应用程序。
    • 然后使用 uvicorn.run() 运行该应用程序,使您的代理可通过 HTTP 访问。
    • host='0.0.0.0' 使服务器可在您机器上的所有网络接口上访问。
    • port=9999 指定监听的端口。这需要与 AgentCard 中的 url 匹配。
  4. specific_extended_agent_card
    • 给同一个 Agent 准备“两张不同权限的名片”,分别用于“普通访客”和“已认证用户”。、

与服务器交互

Helloworld A2A 服务器运行后,让我们向它发送一些请求。SDK 包含一个客户端(A2AClient),可以简化这些交互。

让我们看一下 test_client.py 的关键部分:

  1. 获取代理卡 & 初始化客户端 :

    1
    2
    3
    4
    5
    6
    7
    8
    9
    base_url = 'http://localhost:9999'

    async with httpx.AsyncClient() as httpx_client:
    # 初始化 A2ACardResolver
    resolver = A2ACardResolver(
    httpx_client=httpx_client,
    base_url=base_url,
    # agent_card_path 使用默认值,extended_agent_card_path 也使用默认值
    )

    A2ACardResolver 类是一个便捷工具。它首先从服务器端的 /.well-known/agent-card.json 端点(基于提供的基 URL)获取 AgentCard,然后使用它初始化客户端。

  2. 发送非流式消息 (send_message):

    1
    2
    3
    4
    5
    6
    7
    8
    9
    10
    11
    12
    13
    14
    15
    16
    17
    18
    19
    20
    21
    client = A2AClient(
    httpx_client=httpx_client,
    agent_card=final_agent_card_to_use#这个card为经过认证处理后暴露的card
    )
    logger.info('A2AClient initialized.')

    send_message_payload: dict[str, Any] = {
    'message': {
    'role': 'user',
    'parts': [
    {'kind': 'text', 'text': 'how much is 10 USD in INR?'}
    ],
    'messageId': uuid4().hex,
    },
    }
    request = SendMessageRequest(
    id=str(uuid4()), params=MessageSendParams(**send_message_payload)
    )

    response = await client.send_message(request)
    print(response.model_dump(mode='json', exclude_none=True))
    • send_message_payload 构建了 MessageSendParams 的数据。
    • 这些数据被封装在 SendMessageRequest 中。
    • 它包含一个 message 对象,其中 role 设置为”用户”,内容在 parts 中。
    • Helloworld 代理的 execute 方法将入队一条”Hello World”消息。DefaultRequestHandler 将获取这条消息并将其作为响应发送。
    • response 将是一个 SendMessageResponse 对象,其中包含 SendMessageSuccessResponse(以代理的 Message 作为结果)或 JSONRPCErrorResponse。
  3. 处理任务 ID(Helloworld 的说明性注释):

    Helloworld 客户端(test_client.py)不会直接尝试 get_task 或 cancel_task,因为简单的 Helloworld 代理的 execute 方法,通过 message/send 调用时,会导致 DefaultRequestHandler 返回一个直接的 Message 响应,而不是 Task 对象。更复杂的、明确管理任务的代理(如 LangGraph 示例)会从 message/send 返回一个 Task 对象,然后其 id 可用于 get_task 或 cancel_task。

  4. 发送流式消息(send_message_streaming):

    1
    2
    3
    4
    5
    6
    7
    8
    streaming_request = SendStreamingMessageRequest(
    id=str(uuid4()), params=MessageSendParams(**send_message_payload)
    )

    stream_response = client.send_message_streaming(streaming_request)

    async for chunk in stream_response:
    print(chunk.model_dump(mode='json', exclude_none=True))
    • 此方法调用代理的 message/stream 端点。DefaultRequestHandler 将调用 HelloWorldAgentExecutor.execute 方法。
    • execute 方法将一个”Hello World”消息入队,然后关闭事件队列。
    • 客户端将接收这条单条消息为一个 SendStreamingMessageResponse 事件,然后流将终止。
    • stream_response 是一个 AsyncGenerator。

参考资料

a2aproject/a2a-samples: Samples using the Agent2Agent (A2A) Protocol

Agent2Agent (A2A) Protocol

a2aproject/a2a-python: Agent2Agent (A2A) 协议的官方 Python SDK —- a2aproject/a2a-python: Official Python SDK for the Agent2Agent (A2A) Protocol

训练框架-LLaMA-Factor

安装 - LLaMA Factory

docker部署镜像,以便后续传入内网

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
git clone --depth 1 https://github.com/hiyouga/LLaMA-Factory.git
cd LLaMA-Factory

docker build -f ./docker/docker-cuda/Dockerfile \
--build-arg PIP_INDEX=https://pypi.org/simple \
--build-arg EXTRAS=metrics \
-t llamafactory:latest .

docker run -dit --ipc=host --gpus=all \
-p 7860:7860 \
-p 8001:8000 \ # 主机 8001 → 容器 8000,主机8000端口被占用了
--name llamafactory \
-v /aisys/:/aisys/ \
docker.1ms.run/hiyouga/llamafactory

docker run -dit --ipc=host --gpus=all -p 7860:7860 -p 8001:8000 -v /aisys/:/aisys/ --name llamafactory docker.1ms.run/hiyouga/llamafactory

docker exec -it llamafactory bash
1
2
3
4
5
docker pull docker.1ms.run/hiyouga/llamafactory                                    

docker save docker.1ms.run/hiyouga/llamafactory:latest -o llamafactory-image.tar

docker load -i llamafactory-image.tar

LLaMA Board 可视化微调(由 Gradio 驱动)

1
llamafactory-cli webui
  • Web UI 访问:http://localhost:7860
  • API 服务访问:http://localhost:8001

数据集-easy-dataset

docker部署镜像,以便后续传入内网

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
git clone https://github.com/ConardLi/easy-dataset.git
cd easy-dataset

docker build -t easy-dataset .

docker load -i easy-dataset.tar

docker run -d \
-p 1717:1717 \
-v /aisys/repo_dev/xizhang/lora_database:/app/local-db \
-v /aisys/repo_dev/xizhang/lora_databse_prisma:/app/prisma \
--name easy-dataset \
easy-dataset


docker exec -it easy-dataset sh

docker stop easy-dataset
docker rm easy-dataset

#实时跟踪
docker logs -f easy-dataset

注意: 请将 {YOUR_LOCAL_DB_PATH}、{LOCAL_PRISMA_PATH} 替换为你希望存储本地数据库的实际路径,建议直接使用当前代码仓库目录下的 local-db 和 prisma 文件夹,这样可以和 NPM 启动时的数据库路径保持一致。

注意: 如果需要挂载数据库文件(PRISMA),需要提前执行 npm run db:push 初始化数据库文件。

使用开源项目制作数据集

打开浏览器,访问 http://localhost:1717

上传内网

使用scp

1
scp -r "F:\project python\实习\微调\universal-llm_latest.tar" root@10.117.128.50:/aisys/repo_dev/xizhang/images

SCP 全称是 Secure Copy Protocol(安全复制协议),是一种用于在计算机之间安全地复制文件的网络协议。

它基于 SSH(Secure Shell)协议工作,因此所有传输的数据都是加密的,可以防止被窃听或篡改,非常适合在不安全的网络(如互联网)中使用。

模型部署与调用

制作模型运行镜像

qwen3部署版本要求如下

使用 Python 3.10 或以上版本, PyTorch 2.6 或以上版本

transformers>=4.51.0 版本

使用 sglang>=0.4.6.post1 或 vllm>=0.8.5 来创建一个与 OpenAI 兼容的 API 端点

镜像信息

类别 组件 版本 / 来源 说明
OS Ubuntu 22.04 LTS (Jammy) 上游镜像继承
Python CPython 3.11 镜像自带
PyTorch PyTorch 2.6.0+cu126 官方 wheel,CUDA 12.6
CUDA Runtime 12.6.3 与宿主机 535 驱动兼容
cuDNN cuDNN 9 包含在镜像
核心库 transformers ≥4.51.0 官方最新
tokenizers ≥0.21 transformers 依赖
accelerate ≥1.0.0 训练 / 推理加速
sentencepiece ≥0.2.0 Qwen3 分词器必需
protobuf ≥5.28.0 序列化 / 模型加载
tiktoken ≥0.8.0 OpenAI 格式分词
推理框架 vLLM ≥0.8.5 支持 tensor-parallel、PagedAttention
SGLang ≥0.4.6.post1 支持 outline 解码、MoE 优化
可选加速 flash-attn ≥2.7 长上下文 / 大 batch 推理
权重下载 modelscope 最新 国内镜像加速
工具链 git / git-lfs 最新 拉取 HuggingFace 权重
curl / jq / vim 最新 调试 & 健康检查

基础镜像pytorch/pytorch:2.6.0-cuda12.6-cudnn9-devel 是 PyTorch 官方在 Docker Hub 上提供的“全家桶”开发镜像,发布日期 2025-01-29,镜像大小约 13 GB,定位是 “开箱即用”的 GPU 训练 / 推理 / 调试环境

dockerfile

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
41
42
# ---------- 1. 基础镜像 ----------
FROM pytorch/pytorch:2.6.0-cuda12.6-cudnn9-devel

# ---------- 2. 国内镜像源 ----------
RUN sed -i 's|http://archive.ubuntu.com|https://mirrors.tuna.tsinghua.edu.cn|g' /etc/apt/sources.list && \
sed -i 's|http://security.ubuntu.com|https://mirrors.tuna.tsinghua.edu.cn|g' /etc/apt/sources.list && \
pip config set global.index-url https://pypi.tuna.tsinghua.edu.cn/simple && \
pip config set global.trusted-host pypi.tuna.tsinghua.edu.cn

# ---------- 3. 系统依赖 ----------
RUN apt-get update && \
DEBIAN_FRONTEND=noninteractive apt-get install -y \
git git-lfs build-essential ninja-build curl wget vim jq && \
rm -rf /var/lib/apt/lists/*

# ---------- 4. Python 依赖 ----------
RUN pip install --no-cache-dir --upgrade pip setuptools wheel && \
pip install --no-cache-dir \
"torch==2.6.0+cu126" \
"transformers>=4.51.0" \
"tokenizers>=0.21" \
"accelerate>=1.0.0" \
"sentencepiece>=0.2.0" \
"protobuf>=5.28.0" \
"tiktoken>=0.8.0" \
"vllm>=0.8.5" \
"sglang[all]>=0.4.6.post1" \
"modelscope" \
"fastapi" "uvicorn[standard]" "pydantic"

# ---------- 5. 可选性能加速 ----------
RUN pip install --no-cache-dir "flash-attn>=2.7" --no-build-isolation || true

# ---------- 6. 国内 HuggingFace 镜像 ----------
ENV HF_ENDPOINT=https://hf-mirror.com

# ---------- 7. 工作目录 ----------
WORKDIR /app
EXPOSE 4000 4001 4002

# ---------- 8. 默认命令 ----------
CMD ["/bin/bash"]

运行容器

1
2
3
4
5
6
7
8
9
10
docker run -it \
--name llm-service \
--gpus all \
-p 4000:4000 \
-p 4001:4001 \
-p 4002:4002 \
-v /aisys/repo_dev/xizhang/models:/app/models \
-v /aisys/repo_dev/xizhang/models/cache:/app/models/.cache \
--shm-size=8g \
universal-llm:latest bash

vllm部署qwen3

1
2
3
4
5
6
7
8
vllm serve /app/models/qwen3-32b-lora-new \
--port 4001 \
--tensor-parallel-size 4 \
--max-model-len 1024 \
--reasoning-parser qwen3 \
--gpu-memory-utilization 0.8 \
--max-num-seqs 8 \
--host 0.0.0.0
参数 含义 推荐/注意
--port 8000 服务监听端口 与 -p 8000:8000 保持一致;如需多实例,可改 8001/8002 …
--tensor-parallel-size 4 把模型权重切成 4 份,跨 4 张 GPU 并行计算 必须 ≤ 实际 GPU 数量;Qwen3-32B 在 4×L20 上显存刚好够,不可再大
--max-model-len 1024 单次推理最大 token 数(含 prompt + 生成) 若场景需要 4k/8k/32k,可调到 4096/8192;显存占用 ∝ 长度²
--reasoning-parser qwen3 vLLM ≥0.8.5 新增开关,解析 Qwen3 的 <think>…</think> 标签,把推理过程单独返回 仅在 Qwen3 系列模型有效,其他模型请去掉
--gpu-memory-utilization 0.8 显存使用上限 80 %;剩余 20 % 留给 CUDA kernel、KV cache 膨胀 若出现 OOM,可降到 0.7;若想多并发,可尝试 0.85(风险 OOM)
--max-num-seqs 8 同一时刻最多并发处理的 请求条数 与 --max-model-len 和显存同时决定;若长度 ↑,此值需 ↓
--host 0.0.0.0 监听所有网卡,使容器外可访问 生产环境可改为内网 IP 或 127.0.0.1 提高安全性

测试

1
2
3
4
5
6
7
8
9
10
curl http://localhost:4001/v1/chat/completions \
-H "Content-Type: application/json" \
-d '{
"model": "/app/models/qwen3-32b-lora-new",
"messages": [
{"role": "user", "content": "请用中文介绍一下你自己"}
],
"temperature": 0.7,
"max_tokens": 512
}'

调用

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
import os
from openai import OpenAI

# 指向本地 vLLM
client = OpenAI(
base_url="http://localhost:8000/v1",
api_key="dummy" # vLLM 不做鉴权,随便填
)

resp = client.chat.completions.create(
model="qwen3-32b", # 必须和 vLLM 启动路径或 --served-model-name 保持一致
messages=[
{"role": "user", "content": "9.9 和 9.11 哪个大?"}
],
max_tokens=512,
temperature=0.7,
stream=False # True 可开流式
)

print(resp.choices[0].message.content)

快速入门 - Qwen —- Quickstart - Qwen

通义千问3-32B · 模型库

微调数据集

alpaca和sharegpt的区别

▶ Alpaca 典型字段

1
2
3
4
5
6
7
{
"instruction": "把下面句子翻译成英文",
"input": "今天天气真好",
"output": "The weather is nice today.",
"system": "你是一个翻译助手", // 可选
"history": [] // 可选,放前几轮
}
  • 一条数据 = 一次独立任务
  • 字段固定:instruction / input / output 三板斧

▶ ShareGPT 典型字段

1
2
3
4
5
6
7
8
9
10
{
"conversations": [
{"from": "human", "value": "我今天心情不好"},
{"from": "gpt", "value": "怎么啦?想聊聊吗"},
{"from": "human", "value": "论文又被拒了"},
{"from": "gpt", "value": "理解你的挫败感…"}
],
"system": "你是贴心聊天机器人", // 可选
"tools": [...] // 可选,放函数描述
}
  • 一条数据 = 一段完整的多轮对话
  • 角色交替:human / gpt / function / observation 等
维度 Alpaca ShareGPT
来源 斯坦福 Alpaca 项目,为了低成本做指令微调 ShareGPT 网站爬取的真实 ChatGPT 对话
目标 让模型学会“看到指令+输入→给出答案” 让模型学会“像 ChatGPT 一样多轮对话”

详解

1
2
3
4
5
6
{
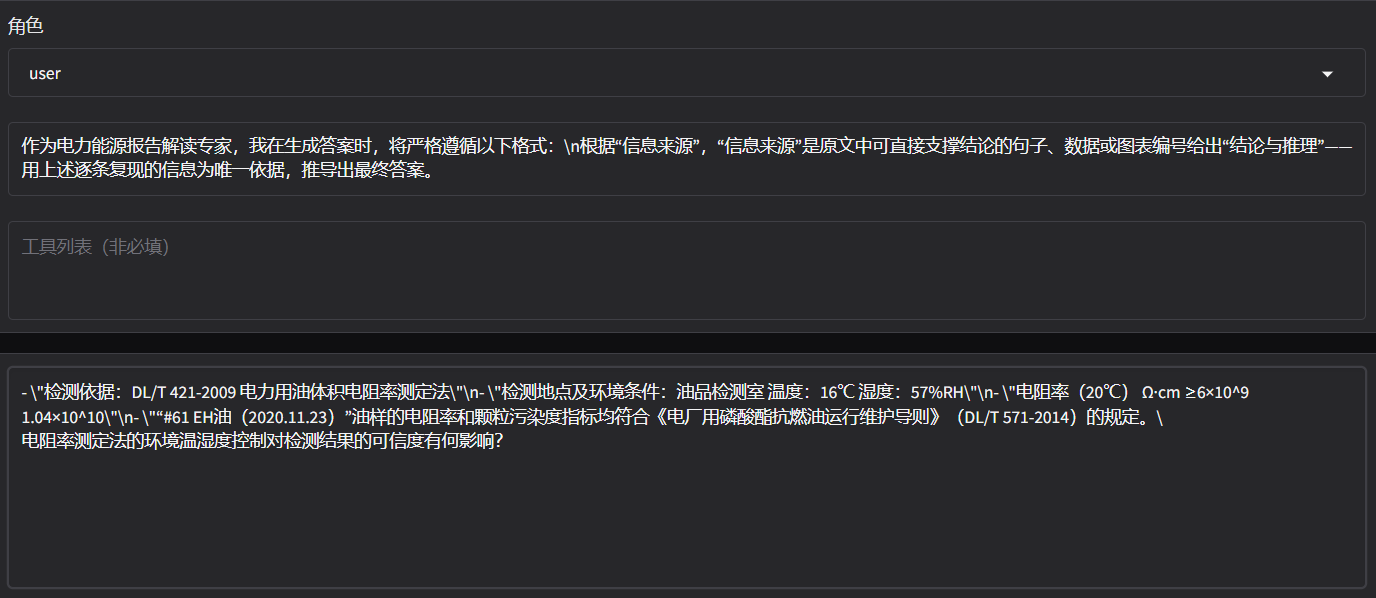
"instruction": "电阻率测定法的环境温湿度控制对检测结果的可信度有何影响?",
"input": "- \"检测依据:DL/T 421-2009 电力用油体积电阻率测定法\"\n- \"检测地点及环境条件:油品检测室 温度:16℃ 湿度:57%RH\"\n- \"电阻率(\"",
"output": "<think>### \n首先,理解问题的核心:电阻率测定法中,环境温湿度控制如何影响检测结果的可信度,这涉及到测量过程的准确性和可靠性。\n\n然后,分析关键信息:检测依据是DL/T 421-2009标准,它规定了电阻率测定的方法;环境条件被记录为温度16℃和湿度57%RH;检测结果显示电阻率为1.04×10^10 Ω·cm,符合DL/T 571-2014标准的要求(≥6×10^9 Ω·cm)。\n\n接着,推理温湿度控制的影响:环境温湿度是测量过程中的关键变量,控制这些条件确保",
"system": "作为电力能源报告解读专家,我在生成答案时,将严格遵循以下格式:\n根据“信息来源”,“信息来源”是原文中可直接支撑结论的句子、数据或图表编号给出“结论与推理”——用上述逐条复现的信息为唯一依据,推导出最终答案。"
}

instruction为问题;input为上下文;output包含思维链与答案;system为系统提示词

微调参数设置

DeepSpeed stage(DeepSpeed 阶段)

deepSpeed 的 ZeRO 分布式优化阶段,用于在多 GPU 上高效训练大模型。

Stage 功能 说明
Stage 0 不做任何优化 基础分布式训练(DDP),显存占用高
Stage 1 梯度分片(Gradient Sharding) 将梯度切分到不同 GPU,减少显存
Stage 2 参数 + 梯度分片 进一步降低显存,但需通信同步
Stage 3 ✅ 参数 + 梯度 + 优化器状态分片 最强显存优化,支持超大模型

使用 DeepSpeed offload(使用 offload)

将 部分或全部模型参数、优化器状态卸载到 CPU 内存,进一步释放 GPU 显存。

1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
21
22
23
24
25
26
27
28
29
30
31
32
33
34
35
36
37
38
39
40
llamafactory-cli train \
--stage sft \
--do_train True \
--model_name_or_path /aisys/repo_dev/xizhang/models/qwen3-32b-lora-new \
--preprocessing_num_workers 16 \
--finetuning_type lora \
--template qwen3 \
--flash_attn auto \
--dataset_dir /aisys/repo_dev/xizhang/lora_database/P9er76jCWCFW \
--dataset [Easy Dataset] [P9er76jCWCFW] Alpaca \
--cutoff_len 4096 \
--learning_rate 5e-05 \
--num_train_epochs 3.0 \
--max_samples 100000 \
--per_device_train_batch_size 2 \
--gradient_accumulation_steps 1 \
--lr_scheduler_type cosine \
--max_grad_norm 1.0 \
--logging_steps 5 \
--save_steps 200 \
--warmup_steps 0 \
--packing False \
--enable_thinking True \
--report_to none \
--output_dir saves/Qwen3-32B-Thinking/lora/train_2025-08-28-03-04-52 \
--bf16 True \
--plot_loss True \
--trust_remote_code True \
--ddp_timeout 180000000 \
--include_num_input_tokens_seen True \
--optim adamw_torch \
--lora_rank 8 \
--lora_alpha 16 \
--lora_dropout 0 \
--lora_target all \
--val_size 0.15 \
--eval_strategy steps \
--eval_steps 200 \
--per_device_eval_batch_size 2 \
--deepspeed cache/ds_z3_config.json

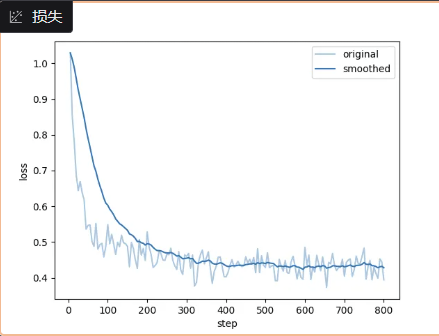
训练结果

image-20250827091214108

评估

不知道为什么使用llamafactory的评估会爆显存,我怀疑是因为那个webui评估可能不支持多卡,就进行一下人工评估吧

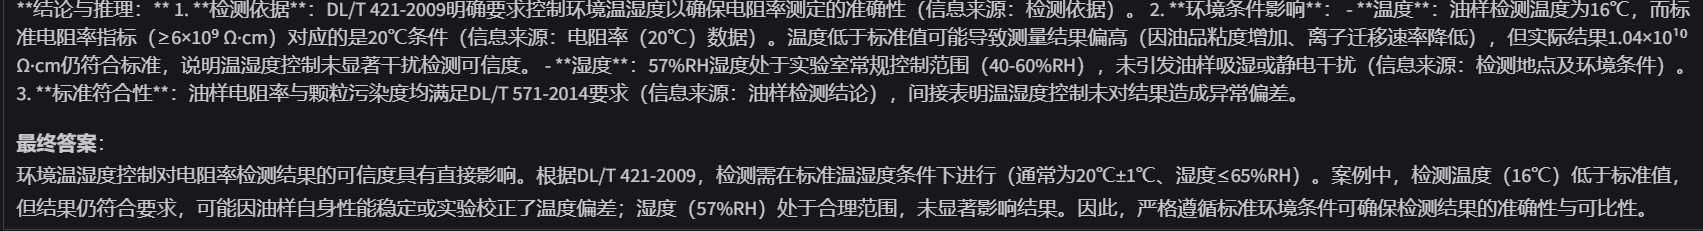
输入

image-20250828144300339

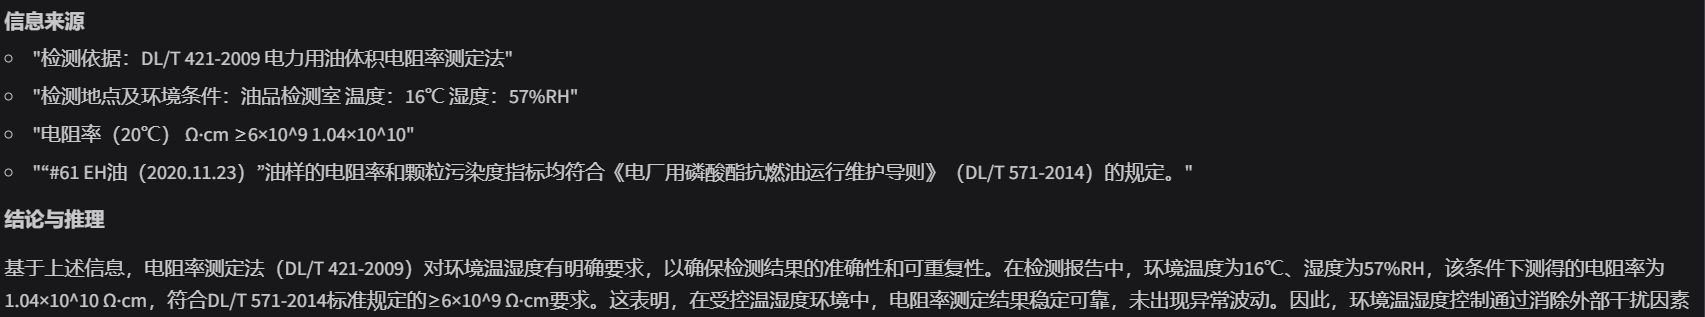
微调模型

image-20250828145106050

初始模型

image-20250828145750115

在内网计算节点访问SwanLab Cloud

在内网计算节点访问SwanLab Cloud | SwanLab官方文档

如何计算训练步数

1. 训练集样本量

公式
训练集样本量 = 总数据量 × (1 − 验证集比例)

示例
总数据 2876 条,验证集占 15%
2876 × (1 − 0.15) = 2876 × 0.85 = 2446 条

2. 每次参数更新处理的样本数(effective batch size)

公式
每次更新样本数 = 单设备批次大小 × GPU 数 × 梯度累积步数

示例

  • per_device_train_batch_size = 1
  • GPU 数 = 2
  • gradient_accumulation_steps = 8

1 × 2 × 8 = 16 条

通俗理解:
GPU 一次只能看 1 条 → 2 卡并行就是 2 条 → 累积 8 次才更新一次参数,所以一次更新真正看了 16 条数据。

3. 每轮(epoch)的训练步数

公式
每轮步数 = ⌊ 训练集样本量 ÷ 每次更新样本数 ⌋
(⌊ ⌋ 表示向下取整)

示例
2446 ÷ 16 = 152.875 → 152 步

4. 总训练步数

公式
总步数 = 每轮步数 × 训练轮数 (epochs)

示例
152 × 3 = 456 步

如何计算一个模型占用的显存

基础模型的权重

  • 定义:预训练模型的参数矩阵,即选择的预训练模型所占用显存的大小。
  • 计算公式:
    显存占用 = 模型参数数量 × 单个参数的字节数

常见模型精度下的单个参数显存占用:

表格

复制

精度类型 二进制位数 字节数
FP32 32位 4字节
FP16 16位 2字节
BF16 16位 2字节(指数位同FP32)
INT8 8位 1字节
INT4 4位 0.5字节
INT2 2位 0.25字节

例如

  • 模型选择:Qwen2.5-7B-Instruct
  • 参数规模:70亿(7B)
  • 计算精度:BF16(2字节/参数)
  • 预估显存占用:
    70亿 × 2字节 = 140亿字节 = 14GB

框架开销(Framework Overhead)

  • 定义:LLaMAFactory 底层使用的深度学习框架(如 PyTorch)本身的显存占用。
  • 包含内容:
    • 张量缓存
    • 线程资源
    • 内核调度开销
    • 自动微分图结构等
  • 计算方法:难以精确计算
  • 估算方法:通常占用不大,默认估算为 1 GB

LoRA 适配器(LoRA Adapters)

  • 定义:在 LoRA 微调中,不直接修改原始模型的庞大权重,而是插入轻量级的“LoRA适配器模块”来学习微调所需的变化。

  • 计算方法:

    显存占用=LoRA层数×秩(Rank)×(输入维度+输出维度)×2B

  • 估算方法:

    • 与 LoRA 的秩(Rank)大小相关
    • 一般占用不大,常规配置下通常不超过 0.5 GB,保守估计为 0.5 GB

激活值(Activations)

  • 定义:前向传播过程中各层的输出张量(如隐藏层状态、注意力矩阵等),即模型“处理数据时产生的所有中间结果”。

  • 计算方法:

    显存占用=批量大小×序列长度×隐藏层维度×模型层数×单个元素字节数

  • 估算方法:

    • 单次处理的 Token 量每增加 1K,显存约增加 2.5 GB
    • 与单 GPU 的批量大小和数据集的截断长度(序列长度)正相关
    • 在固定其他配置(基础模型权重、框架开销、LoRA适配器)后,剩余显存即为激活值占用

加速方式

加速方式 全称 / 来源 核心原理与特点 适用场景与注意事项
auto 自动选择 由框架(如 transformers、LLaMA-Factory、DeepSpeed 等)根据当前硬件、驱动、CUDA 版本自动挑选最快的可用算子或路径。 优点:零配置、开箱即用;缺点:不一定能启用最新、最快的内核。 初次实验、不想手动调参时首选。
flashattn2 FlashAttention-2 通过 IO-Aware 的算法和 GPU Tensor Core 优化,将标准 Multi-Head Attention 的显存访问次数大幅降低,从而显著加快训练/推理速度(通常 2-4×),并减少显存占用。 需要 A100、H100、RTX 30/40 系列等 Ampere/Lovelace 架构;依赖 CUDA≥11.8、PyTorch≥2.0 且需安装 flash-attn wheel。 训练/微调 LLM 时首选;序列越长收益越大。若编译失败可退回 xformers 或原生实现。
unsloth Unsloth 开源库 针对 Llama、Mistral、Qwen 等架构,使用动态量化、手工 fused-kernel 和梯度检查点优化,使 LoRA 微调在消费级 GPU 上也能跑更大 batch/更长序列。官方宣称速度提升 2-5×,显存节省 50-70%。 安装简单:pip install unsloth(会自动替换部分 PyTorch 层)。 单卡 4090/3090 上 LoRA 微调 7B-13B 模型效果最佳;目前仅支持有限模型。
liger_kernel Liger-Kernel(微软开源) 以 Triton 编写的高性能 fused-kernel 合集(SwiGLU、RMSNorm、CrossEntropy、RoPE 等),在保持数值精度的同时减少 kernel launch 和显存写回,训练吞吐量可提升 10-20%。 纯 Python/Triton 实现,无需额外 CUDA 编译。 对训练框架侵入性小,可与 FlashAttention 并存;适合想“无痛”提速 10-20% 的场景。

参考资料

LLaMA Factory

0%