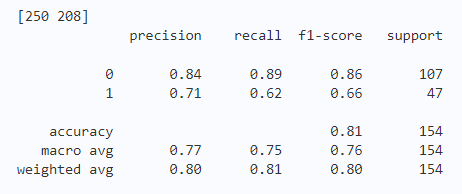
import pandas as pd from sklearn.model_selection import train_test_split from sklearn.preprocessing import StandardScaler from sklearn.metrics import classification_report from sklearn.svm import SVC
# 读取数据 data = pd.read_csv('diabetes.csv')
# 请在下方作答 # # 将目标特征与其他特征分离 X = data.drop('class', axis=1) y = data['class']
import numpy as np import pandas as pd from sklearn.model_selection import train_test_split from sklearn.preprocessing import StandardScaler from sklearn.metrics import classification_report from sklearn.svm import SVC from sklearn.datasets import load_iris from sklearn.model_selection import train_test_split import matplotlib.pyplot as plt
/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/sklearn/utils/validation.py:760: DataConversionWarning: A column-vector y was passed when a 1d array was expected. Please change the shape of y to (n_samples, ), for example using ravel().
  y = column_or_1d(y, warn=True)


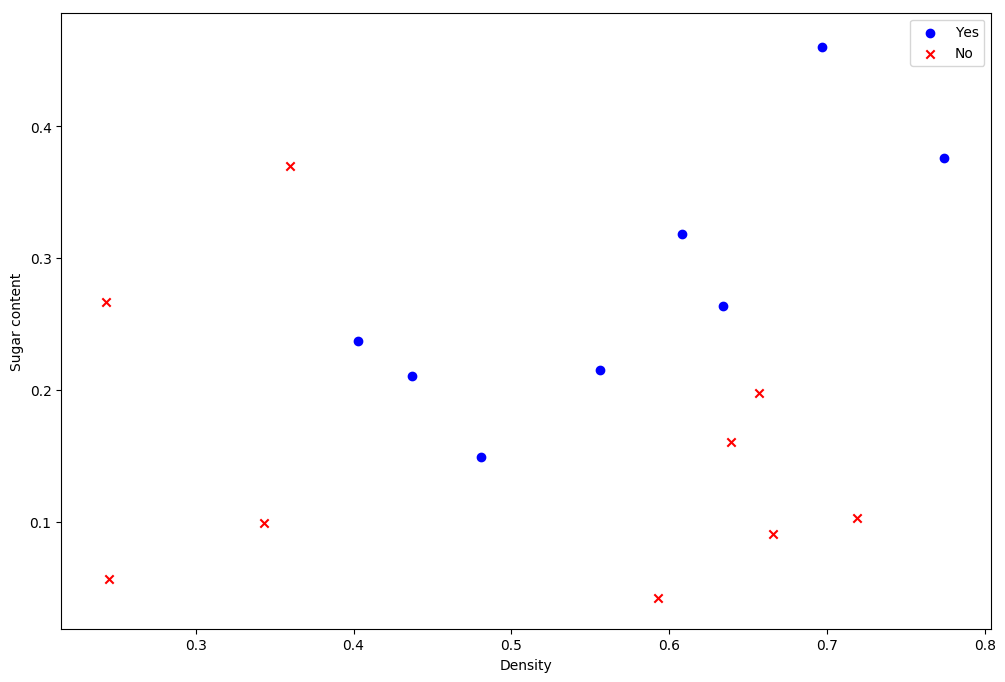
array([[0.666, 0.091],
       [0.243, 0.267],
       [0.343, 0.099],
       [0.639, 0.161],
       [0.657, 0.198],
       [0.36 , 0.37 ],
       [0.593, 0.042],
       [0.719, 0.103],
       [0.697, 0.46 ],
       [0.774, 0.376],
       [0.634, 0.264],
       [0.608, 0.318],
       [0.556, 0.215],
       [0.403, 0.237],
       [0.481, 0.149],
       [0.437, 0.211]])
/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/sklearn/utils/validation.py:760: DataConversionWarning: A column-vector y was passed when a 1d array was expected. Please change the shape of y to (n_samples, ), for example using ravel().
  y = column_or_1d(y, warn=True)

array([[0.666, 0.091],
       [0.243, 0.267],
       [0.245, 0.057],
       [0.343, 0.099],
       [0.639, 0.161],
       [0.657, 0.198],
       [0.36 , 0.37 ],
       [0.593, 0.042],
       [0.719, 0.103],
       [0.697, 0.46 ],
       [0.774, 0.376],
       [0.634, 0.264],
       [0.608, 0.318],
       [0.556, 0.215],
       [0.403, 0.237],
       [0.481, 0.149],
       [0.437, 0.211]])
@staticmethod def__gaussian__(a, b, kern_param): mat = np.zeros([len(a), len(b)]) for i inrange(0, len(a)): for j inrange(0, len(b)): mat[i][j] = np.exp(-np.sum(np.square(np.subtract(a[i], b[j]))) / (2 * kern_param * kern_param)) return mat
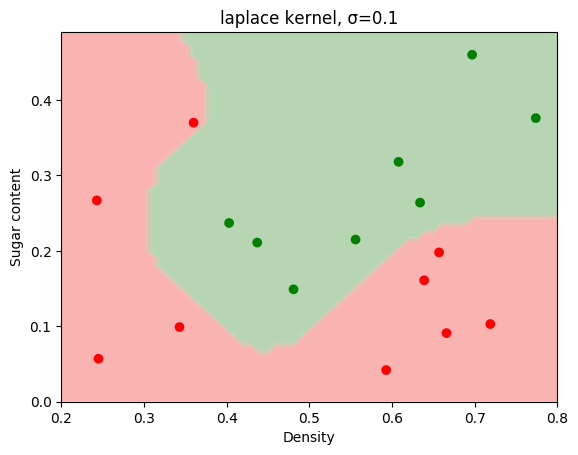
@staticmethod def__laplace__(a, b, kern_param): mat = np.zeros([len(a), len(b)]) for i inrange(0, len(a)): for j inrange(0, len(b)): mat[i][j] = np.exp(-np.linalg.norm(np.subtract(a[i], b[j])) / kern_param) return mat
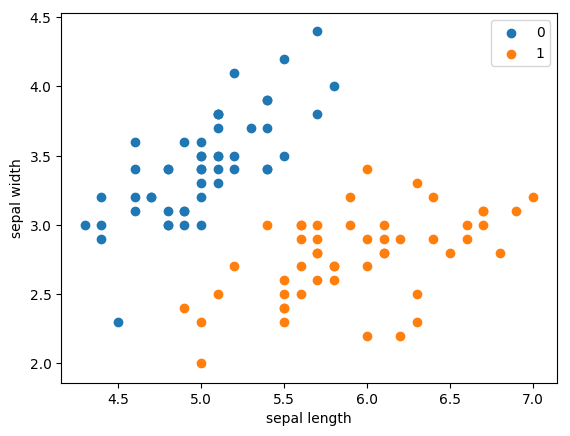
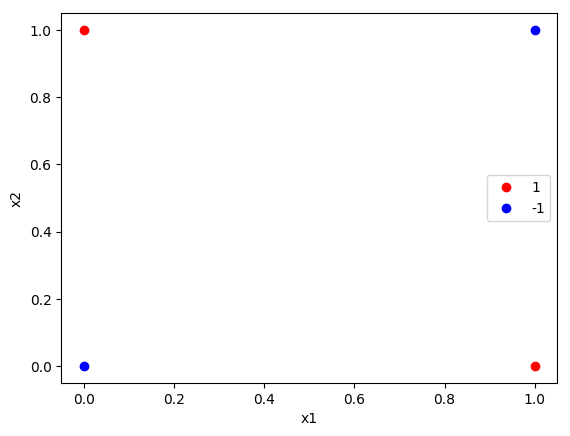
<matplotlib.legend.Legend at 0x7f177628f110>


/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/matplotlib/font_manager.py:1331: UserWarning: findfont: Font family ['sans-serif'] not found. Falling back to DejaVu Sans
  (prop.get_family(), self.defaultFamily[fontext]))
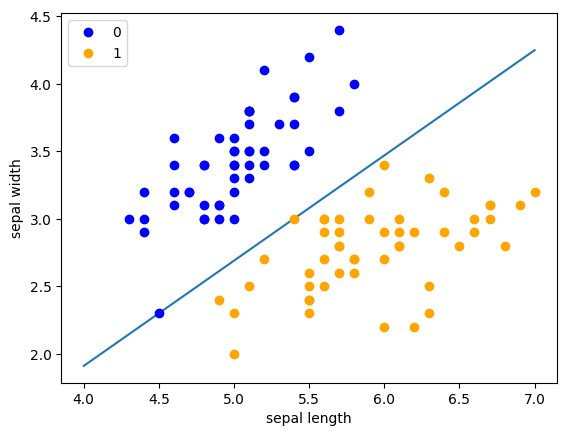
<matplotlib.legend.Legend at 0x7f1769a4eb50>


/opt/conda/envs/python35-paddle120-env/lib/python3.7/site-packages/matplotlib/font_manager.py:1331: UserWarning: findfont: Font family ['sans-serif'] not found. Falling back to DejaVu Sans
  (prop.get_family(), self.defaultFamily[fontext]))
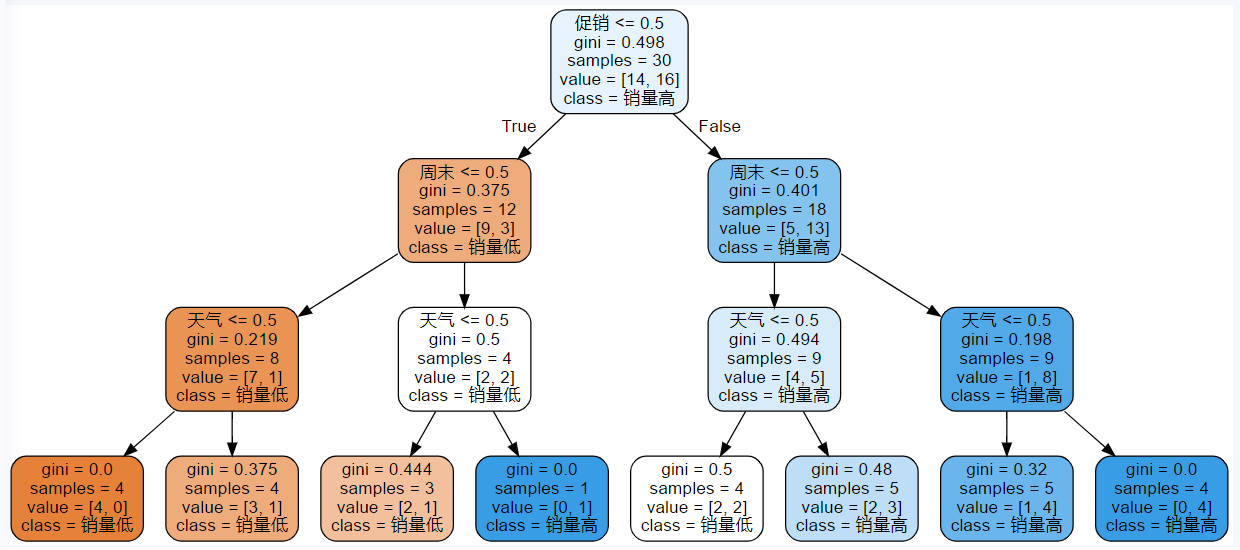
import pandas as pd from sklearn.tree import DecisionTreeClassifier, export_graphviz # 补全export_graphviz导入 from sklearn.model_selection import train_test_split from sklearn.metrics import classification_report
data = pd.read_csv('product.csv')
## 对数据集切片,获取除目标特征以外的其他特征的数据记录X X = data[["天气", "是否周末", "是否有促销"]] # 使用双括号选择多列