复习:在前面我们已经学习了Pandas基础,知道利用Pandas读取csv数据的增删查改,今天我们要学习的就是探索性数据分析,主要介绍如何利用Pandas进行排序、算术计算以及计算描述函数describe()的使用。

1 第一章:探索性数据分析

开始之前,导入numpy、pandas包和数据

1
2
3
#加载所需的库
import numpy as np
import pandas as pd
1
2
#载入之前保存的train_chinese.csv数据,关于泰坦尼克号的任务,我们就使用这个数据
train_chinese = pd.read_csv('./titanic/train_chinese.csv')

1.6 了解你的数据吗?

教材《Python for Data Analysis》第五章

1.6.1 任务一:利用Pandas对示例数据进行排序,要求升序

1
2
3
4
5
6
7
8
9
# 具体请看《利用Python进行数据分析》第五章 排序和排名 部分

#自己构建一个都为数字的DataFrame数据
frame = pd.DataFrame(np.arange(8).reshape((2, 4)),
index=['2', '1'],
columns=['d', 'a', 'b', 'c'])
frame


d a b c
2 0 1 2 3
1 4 5 6 7

【代码解析】

pd.DataFrame() :创建一个DataFrame对象

np.arange(8).reshape((2, 4)) : 生成一个二维数组(2*4),第一列:0,1,2,3 第二列:4,5,6,7

index=[’2, 1] :DataFrame 对象的索引列

columns=[‘d’, ‘a’, ‘b’, ‘c’] :DataFrame 对象的索引行

【问题】:大多数时候我们都是想根据列的值来排序,所以将你构建的DataFrame中的数据根据某一列,升序排列

1
2
3
#回答代码
#指定按列名 'b' 的值进行排序,ascending=False设置降序排列(默认是升序)
frame.sort_values(by='b',ascending=False)
d a b c
1 4 5 6 7
2 0 1 2 3

【思考】通过书本你能说出Pandas对DataFrame数据的其他排序方式吗?

【总结】下面将不同的排序方式做一个总结

1.让行索引升序排序

1
2
#代码
frame.sort_index(ascending=True)
d a b c
1 4 5 6 7
2 0 1 2 3

2.让列索引升序排序

1
2
3
#代码
#axis=1指定对 列索引(columns) 进行排序(默认 axis=0 是对行索引排序)。
frame.sort_index(axis=1)
a b c d
2 1 2 3 0
1 5 6 7 4

3.让列索引降序排序

1
2
#代码
frame.sort_index(axis=1, ascending=False)
d c b a
2 0 3 2 1
1 4 7 6 5

4.让任选两列数据同时降序排序

1
2
#代码
frame.sort_values(by=['a','b'],ascending=False)
d a b c
1 4 5 6 7
2 0 1 2 3

1.6.2 任务二:对泰坦尼克号数据(trian.csv)按票价和年龄两列进行综合排序(降序排列),从这个数据中你可以分析出什么?

1
2
3
4
5
6
'''
在开始我们已经导入了train_chinese.csv数据,而且前面我们也学习了导入数据过程,根据上面学习,我们直接对目标列进行排序即可
head(20) : 读取前20条数据
'''

train_chinese.sort_values(by=['票价','年龄'], ascending=False).head(20)
乘客ID 是否幸存 仓位等级 姓名 性别 年龄 兄弟姐妹个数 父母子女个数 船票信息 票价 客舱 登船港口
679 680 1 1 Cardeza, Mr. Thomas Drake Martinez male 36.0 0 1 PC 17755 512.3292 B51 B53 B55 C
258 259 1 1 Ward, Miss. Anna female 35.0 0 0 PC 17755 512.3292 NaN C
737 738 1 1 Lesurer, Mr. Gustave J male 35.0 0 0 PC 17755 512.3292 B101 C
438 439 0 1 Fortune, Mr. Mark male 64.0 1 4 19950 263.0000 C23 C25 C27 S
341 342 1 1 Fortune, Miss. Alice Elizabeth female 24.0 3 2 19950 263.0000 C23 C25 C27 S
88 89 1 1 Fortune, Miss. Mabel Helen female 23.0 3 2 19950 263.0000 C23 C25 C27 S
27 28 0 1 Fortune, Mr. Charles Alexander male 19.0 3 2 19950 263.0000 C23 C25 C27 S
742 743 1 1 Ryerson, Miss. Susan Parker “Suzette” female 21.0 2 2 PC 17608 262.3750 B57 B59 B63 B66 C
311 312 1 1 Ryerson, Miss. Emily Borie female 18.0 2 2 PC 17608 262.3750 B57 B59 B63 B66 C
299 300 1 1 Baxter, Mrs. James (Helene DeLaudeniere Chaput) female 50.0 0 1 PC 17558 247.5208 B58 B60 C
118 119 0 1 Baxter, Mr. Quigg Edmond male 24.0 0 1 PC 17558 247.5208 B58 B60 C
380 381 1 1 Bidois, Miss. Rosalie female 42.0 0 0 PC 17757 227.5250 NaN C
716 717 1 1 Endres, Miss. Caroline Louise female 38.0 0 0 PC 17757 227.5250 C45 C
700 701 1 1 Astor, Mrs. John Jacob (Madeleine Talmadge Force) female 18.0 1 0 PC 17757 227.5250 C62 C64 C
557 558 0 1 Robbins, Mr. Victor male NaN 0 0 PC 17757 227.5250 NaN C
527 528 0 1 Farthing, Mr. John male NaN 0 0 PC 17483 221.7792 C95 S
377 378 0 1 Widener, Mr. Harry Elkins male 27.0 0 2 113503 211.5000 C82 C
779 780 1 1 Robert, Mrs. Edward Scott (Elisabeth Walton Mc… female 43.0 0 1 24160 211.3375 B3 S
730 731 1 1 Allen, Miss. Elisabeth Walton female 29.0 0 0 24160 211.3375 B5 S
689 690 1 1 Madill, Miss. Georgette Alexandra female 15.0 0 1 24160 211.3375 B5 S
1
2
#代码

【思考】排序后,如果我们仅仅关注年龄和票价两列。根据常识我知道发现票价越高的应该客舱越好,所以我们会明显看出,票价前20的乘客中存活的有14人,这是相当高的一个比例,那么我们后面是不是可以进一步分析一下票价和存活之间的关系,年龄和存活之间的关系呢?当你开始发现数据之间的关系了,数据分析就开始了。

当然,这只是我的想法,你还可以有更多想法,欢迎写在你的学习笔记中。

多做几个数据的排序

1.6.3 任务三:利用Pandas进行算术计算,计算两个DataFrame数据相加结果

1
2
3
4
5
6
7
8
9
10
11
12
# 具体请看《利用Python进行数据分析》第五章 算术运算与数据对齐 部分

#自己构建两个都为数字的DataFrame数据

frame1_a = pd.DataFrame(np.arange(9.).reshape(3, 3),
columns=['a', 'b', 'c'],
index=['one', 'two', 'three'])
frame1_b = pd.DataFrame(np.arange(12.).reshape(4, 3),
columns=['a', 'e', 'c'],
index=['first', 'one', 'two', 'second'])
frame1_a, frame1_b

(         a    b    c
 one    0.0  1.0  2.0
 two    3.0  4.0  5.0
 three  6.0  7.0  8.0,
           a     e     c
 first   0.0   1.0   2.0
 one     3.0   4.0   5.0
 two     6.0   7.0   8.0
 second  9.0  10.0  11.0)

将frame_a和frame_b进行相加

1
2
#代码
frame1_a+frame1_b
a b c e
first NaN NaN NaN NaN
one 3.0 NaN 7.0 NaN
second NaN NaN NaN NaN
three NaN NaN NaN NaN
two 9.0 NaN 13.0 NaN

【提醒】两个DataFrame相加后,会返回一个新的DataFrame,对应的行和列的值会相加,没有对应的会变成空值NaN。
当然,DataFrame还有很多算术运算,如减法,除法等,有兴趣的同学可以看《利用Python进行数据分析》第五章 算术运算与数据对齐 部分,多在网络上查找相关学习资料。

1.6.4 任务四:通过泰坦尼克号数据如何计算出在船上最大的家族有多少人?

1
2
3
4
'''
还是用之前导入的chinese_train.csv如果我们想看看在船上,最大的家族有多少人(‘兄弟姐妹个数’+‘父母子女个数’),我们该怎么做呢?
'''
max(train_chinese['兄弟姐妹个数'] + train_chinese['父母子女个数'])
10

【提醒】我们只需找出”兄弟姐妹个数“和”父母子女个数“之和最大的数,当然你还可以想出很多方法和思考角度,欢迎你来说出你的看法。

多做几个数据的相加,看看你能分析出什么?

1.6.5 任务五:学会使用Pandas describe()函数查看数据基本统计信息

1
2
3
4
5
6
7
8
9
10
11
12
#(1) 关键知识点示例做一遍(简单数据)
# 具体请看《利用Python进行数据分析》第五章 汇总和计算描述统计 部分

#自己构建一个有数字有空值的DataFrame数据

frame2 = pd.DataFrame([[1.4, np.nan],
[7.1, -4.5],
[np.nan, np.nan],
[0.75, -1.3]
], index=['a', 'b', 'c', 'd'], columns=['one', 'two'])
frame2

one two
a 1.40 NaN
b 7.10 -4.5
c NaN NaN
d 0.75 -1.3
1
2
3
4
5
6
7
8
9
10
11
12
#代码
frame2.describe() #描述统计
'''
count : 样本数据大小
mean : 样本数据的平均值
std : 样本数据的标准差
min : 样本数据的最小值
25% : 样本数据25%的时候的值
50% : 样本数据50%的时候的值
75% : 样本数据75%的时候的值
max : 样本数据的最大值
'''
one two
count 3.000000 2.000000
mean 3.083333 -2.900000
std 3.493685 2.262742
min 0.750000 -4.500000
25% 1.075000 -3.700000
50% 1.400000 -2.900000
75% 4.250000 -2.100000
max 7.100000 -1.300000

调用 describe 函数,观察frame2的数据基本信息

1.6.6 任务六:分别看看泰坦尼克号数据集中 票价、父母子女 这列数据的基本统计数据,你能发现什么?

1
2
3
'''
看看泰坦尼克号数据集中 票价 这列数据的基本统计数据
'''
'\n看看泰坦尼克号数据集中 票价 这列数据的基本统计数据\n'
1
2
#代码
train_chinese['票价'].describe()
count    891.000000
mean      32.204208
std       49.693429
min        0.000000
25%        7.910400
50%       14.454200
75%       31.000000
max      512.329200
Name: 票价, dtype: float64

【思考】从上面数据我们可以看出, 一共有891个票价数据, 平均值约为:32.20, 标准差约为49.69,说明票价波动特别大, 25%的人的票价是低于7.91的,50%的人的票价低于14.45,75%的人的票价低于31.00, 票价最大值约为512.33,最小值为0。 当然,答案只是我的想法,你还可以有更多想法,欢迎写在你的学习笔记中。

多做几个组数据的统计,看看你能分析出什么?

1
2
3
# 写下你的其他分析
train_chinese['父母子女个数'].describe()

count    891.000000
mean       0.381594
std        0.806057
min        0.000000
25%        0.000000
50%        0.000000
75%        0.000000
max        6.000000
Name: 父母子女个数, dtype: float64

【思考】有更多想法,欢迎写在你的学习笔记中。

【总结】本节中我们通过Pandas的一些内置函数对数据进行了初步统计查看,这个过程最重要的不是大家得掌握这些函数,而是看懂从这些函数出来的数据,构建自己的数据分析思维,这也是第一章最重要的点,希望大家学完第一章能对数据有个基本认识,了解自己在做什么,为什么这么做,后面的章节我们将开始对数据进行清洗,进一步分析。

复习:在前面我们已经学习了Pandas基础,第二章我们开始进入数据分析的业务部分,在第二章第一节的内容中,我们学习了数据的清洗,这一部分十分重要,只有数据变得相对干净,我们之后对数据的分析才可以更有力。而这一节,我们要做的是数据重构,数据重构依旧属于数据理解(准备)的范围。

开始之前,导入numpy、pandas包和数据

1
2
3
# 导入基本库
import numpy as np
import pandas as pd
1
2
3
# 载入data文件中的:train-left-up.csv
text=pd.read_csv('../第二章项目集合/data/train-left-up.csv')
text.head()
PassengerId Survived Pclass Name
0 1 0 3 Braund, Mr. Owen Harris
1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th…
2 3 1 3 Heikkinen, Miss. Laina
3 4 1 1 Futrelle, Mrs. Jacques Heath (Lily May Peel)
4 5 0 3 Allen, Mr. William Henry

2 第二章:数据重构

2.4 数据的合并

2.4.1 任务一:将data文件夹里面的所有数据都载入,观察数据的之间的关系

1
2
3
4
5
6
7
#写入代码
text_left_up=pd.read_csv('../第二章项目集合/data/train-left-up.csv')
text_left_down=pd.read_csv('../第二章项目集合/data/train-left-down.csv')
text_right_up=pd.read_csv('../第二章项目集合/data/train-right-up.csv')
text_right_down=pd.read_csv('../第二章项目集合/data/train-right-down.csv')
text_left_up.head()

PassengerId Survived Pclass Name
0 1 0 3 Braund, Mr. Owen Harris
1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th…
2 3 1 3 Heikkinen, Miss. Laina
3 4 1 1 Futrelle, Mrs. Jacques Heath (Lily May Peel)
4 5 0 3 Allen, Mr. William Henry

【提示】结合之前我们加载的train.csv数据,大致预测一下上面的数据是什么

2.4.2:任务二:使用concat方法:将数据train-left-up.csv和train-right-up.csv横向合并为一张表,并保存这张表为result_up

1
2
3
4
5
#写入代码
#pandas.concat 是 Pandas 中用于连接 Series 或 DataFrame 对象的核心方法,支持横向(列方向)或纵向(行方向)拼接
list_up = [text_left_up,text_right_up]
result_up = pd.concat(list_up,axis=1)
result_up.head()
PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin Embarked
0 1 0 3 Braund, Mr. Owen Harris male 22.0 1 0 A/5 21171 7.2500 NaN S
1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th… female 38.0 1 0 PC 17599 71.2833 C85 C
2 3 1 3 Heikkinen, Miss. Laina female 26.0 0 0 STON/O2. 3101282 7.9250 NaN S
3 4 1 1 Futrelle, Mrs. Jacques Heath (Lily May Peel) female 35.0 1 0 113803 53.1000 C123 S
4 5 0 3 Allen, Mr. William Henry male 35.0 0 0 373450 8.0500 NaN S

2.4.3 任务三:使用concat方法:将train-left-down和train-right-down横向合并为一张表,并保存这张表为result_down。然后将上边的result_up和result_down纵向合并为result。

1
2
3
4
5
6
#写入代码
list_down=[text_left_down,text_right_down]
result_down = pd.concat(list_down,axis=1)
result = pd.concat([result_up,result_down])
result.head()

PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin Embarked
0 1 0 3 Braund, Mr. Owen Harris male 22.0 1 0 A/5 21171 7.2500 NaN S
1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th… female 38.0 1 0 PC 17599 71.2833 C85 C
2 3 1 3 Heikkinen, Miss. Laina female 26.0 0 0 STON/O2. 3101282 7.9250 NaN S
3 4 1 1 Futrelle, Mrs. Jacques Heath (Lily May Peel) female 35.0 1 0 113803 53.1000 C123 S
4 5 0 3 Allen, Mr. William Henry male 35.0 0 0 373450 8.0500 NaN S

2.4.4 任务四:使用DataFrame自带的方法join方法和append:完成任务二和任务三的任务

1
2
3
4
5
#写入代码
resul_up = text_left_up.join(text_right_up)
result_down = text_left_down.join(text_right_down)
result = result_up.append(result_down)
result.head()

2.4.5 任务五:使用Panads的merge方法和DataFrame的append方法:完成任务二和任务三的任务

1
2
3
4
5
6
7
8
9
#写入代码
'''
该代码使用 pandas.merge 方法,以索引(index)为键,将两个 DataFrame (text_left_up 和 text_right_up) 横向合并。
'''
result_up = pd.merge(text_left_up,text_right_up,left_index=True,right_index=True)
result_down = pd.merge(text_left_down,text_right_down,left_index=True,right_index=True)
result = resul_up.append(result_down)
result.head()

【思考】对比merge、join以及concat的方法的不同以及相同。思考一下在任务四和任务五的情况下,为什么都要求使用DataFrame的append方法,如何只要求使用merge或者join可不可以完成任务四和任务五呢?

2.4.6 任务六:完成的数据保存为result.csv

1
2
3
4
#写入代码

result.to_csv('result.csv')
result.head()
PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin Embarked
0 1 0 3 Braund, Mr. Owen Harris male 22.0 1 0 A/5 21171 7.2500 NaN S
1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th… female 38.0 1 0 PC 17599 71.2833 C85 C
2 3 1 3 Heikkinen, Miss. Laina female 26.0 0 0 STON/O2. 3101282 7.9250 NaN S
3 4 1 1 Futrelle, Mrs. Jacques Heath (Lily May Peel) female 35.0 1 0 113803 53.1000 C123 S
4 5 0 3 Allen, Mr. William Henry male 35.0 0 0 373450 8.0500 NaN S

2.5 换一种角度看数据

2.5.1 任务一:将我们的数据变为Series类型的数据

1
2
3
4
5
#写入代码
#text.stack() 是 Pandas 中用于将 DataFrame 的列旋转为行的方法
text = pd.read_csv('result.csv')
unit_result=text.stack().head(20)
unit_result.head()
0  Unnamed: 0                           0
   PassengerId                          1
   Survived                             0
   Pclass                               3
   Name           Braund, Mr. Owen Harris
dtype: object
1
2
3
#写入代码

unit_result.to_csv('unit_result.csv')

复习:回顾学习完第一章,我们对泰坦尼克号数据有了基本的了解,也学到了一些基本的统计方法,第二章中我们学习了数据的清理和重构,使得数据更加的易于理解;今天我们要学习的是第二章第三节:数据可视化,主要给大家介绍一下Python数据可视化库Matplotlib,在本章学习中,你也许会觉得数据很有趣。在打比赛的过程中,数据可视化可以让我们更好的看到每一个关键步骤的结果如何,可以用来优化方案,是一个很有用的技巧。

2 第二章:数据可视化

开始之前,导入numpy、pandas以及matplotlib包和数据

1
2
3
4
5
6
# 加载所需的库
# 如果出现 ModuleNotFoundError: No module named 'xxxx'
# 你只需要在终端/cmd下 pip install xxxx 即可
import numpy as np
import pandas as pd
import matplotlib.pyplot as plt
1
2
3
#加载result.csv这个数据
text = pd.read_csv(r'result.csv')
text.head()
Unnamed: 0 PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin Embarked
0 0 1 0 3 Braund, Mr. Owen Harris male 22.0 1 0 A/5 21171 7.2500 NaN S
1 1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th… female 38.0 1 0 PC 17599 71.2833 C85 C
2 2 3 1 3 Heikkinen, Miss. Laina female 26.0 0 0 STON/O2. 3101282 7.9250 NaN S
3 3 4 1 1 Futrelle, Mrs. Jacques Heath (Lily May Peel) female 35.0 1 0 113803 53.1000 C123 S
4 4 5 0 3 Allen, Mr. William Henry male 35.0 0 0 373450 8.0500 NaN S

2.7 如何让人一眼看懂你的数据?

《Python for Data Analysis》第九章

2.7.1 任务一:跟着书本第九章,了解matplotlib,自己创建一个数据项,对其进行基本可视化

【思考】最基本的可视化图案有哪些?分别适用于那些场景?(比如折线图适合可视化某个属性值随时间变化的走势)

1
2
3
#思考回答
#这一部分需要了解可视化图案的的逻辑,知道什么样的图案可以表达什么样的信号b

2.7.2 任务二:可视化展示泰坦尼克号数据集中男女中生存人数分布情况(用柱状图试试)。

1
2
3
4
5
6
#代码编写
sex = text.groupby('Sex')['Survived'].sum()
sex.plot.bar()
plt.title('survived_count')
plt.show()

第二章:第四节数据可视化-课程_10_0

【思考】计算出泰坦尼克号数据集中男女中死亡人数,并可视化展示?如何和男女生存人数可视化柱状图结合到一起?看到你的数据可视化,说说你的第一感受(比如:你一眼看出男生存活人数更多,那么性别可能会影响存活率)。

1
2
3
#思考题回答


2.7.3 任务三:可视化展示泰坦尼克号数据集中男女中生存人与死亡人数的比例图(用柱状图试试)。

1
2
3
4
5
6
7
#代码编写
# 提示:计算男女中死亡人数 1表示生存,0表示死亡
text.groupby(['Sex','Survived'])['Survived'].count().unstack().plot(kind='bar',stacked='True')
plt.title('survived_count')
plt.ylabel('count')


Text(0, 0.5, 'count')
第二章:第四节数据可视化-课程_14_1

【提示】男女这两个数据轴,存活和死亡人数按比例用柱状图表示

2.7.4 任务四:可视化展示泰坦尼克号数据集中不同票价的人生存和死亡人数分布情况。(用折线图试试)(横轴是不同票价,纵轴是存活人数)

【提示】对于这种统计性质的且用折线表示的数据,你可以考虑将数据排序或者不排序来分别表示。看看你能发现什么?

1
2
3
4
5
6
7
#代码编写
# 计算不同票价中生存与死亡人数 1表示生存,0表示死亡
#print(text.groupby(['Fare'])['Survived'].value_counts())
fare_sur = text.groupby(['Fare'])['Survived'].value_counts().sort_values(ascending=False)
fare_sur


Fare     Survived
8.0500   0           38
7.8958   0           37
13.0000  0           26
7.7500   0           22
26.0000  0           16
                     ..
6.9500   0            1
6.9750   0            1
         1            1
7.0458   0            1
7.1417   1            1
Name: count, Length: 330, dtype: int64
1
2
3
4
5
# 排序后绘折线图
fig = plt.figure(figsize=(20, 18))
fare_sur.plot(grid=True)
plt.legend()
plt.show()
第二章:第四节数据可视化-课程_19_0
1
2
3
4
5
6
7
8
# 写入代码
# 排序前绘折线图
fare_sur1 = text.groupby(['Fare'])['Survived'].value_counts()
fare_sur1
fig = plt.figure(figsize=(20, 18))
fare_sur1.plot(grid=True)
plt.legend()
plt.show()
第二章:第四节数据可视化-课程_20_0

2.7.5 任务五:可视化展示泰坦尼克号数据集中不同仓位等级的人生存和死亡人员的分布情况。(用柱状图试试)

1
2
3
4
#代码编写
# 1表示生存,0表示死亡
pclass_sur = text.groupby(['Pclass'])['Survived'].value_counts()
pclass_sur
Pclass  Survived
1       1           136
        0            80
2       0            97
        1            87
3       0           372
        1           119
Name: count, dtype: int64
1
2
import seaborn as sns
sns.countplot(x="Pclass", hue="Survived", data=text)
<Axes: xlabel='Pclass', ylabel='count'>
第二章:第四节数据可视化-课程_23_1

【思考】看到这个前面几个数据可视化,说说你的第一感受和你的总结

1
2
3
#思考题回答


2.7.6 任务六:可视化展示泰坦尼克号数据集中不同年龄的人生存与死亡人数分布情况。(不限表达方式)

1
2
3
4
5
#代码编写
facet = sns.FacetGrid(text, hue="Survived",aspect=3)
facet.map(sns.kdeplot,'Age',shade= True)
facet.set(xlim=(0, text['Age'].max()))
facet.add_legend()
/root/.pyenv/versions/3.11.1/lib/python3.11/site-packages/seaborn/axisgrid.py:854: FutureWarning: 

`shade` is now deprecated in favor of `fill`; setting `fill=True`.
This will become an error in seaborn v0.14.0; please update your code.

  func(*plot_args, **plot_kwargs)
/root/.pyenv/versions/3.11.1/lib/python3.11/site-packages/seaborn/axisgrid.py:854: FutureWarning: 

`shade` is now deprecated in favor of `fill`; setting `fill=True`.
This will become an error in seaborn v0.14.0; please update your code.

  func(*plot_args, **plot_kwargs)

<seaborn.axisgrid.FacetGrid at 0x7f9c6bce1f50>
第二章:第四节数据可视化-课程_27_2

2.7.7 任务七:可视化展示泰坦尼克号数据集中不同仓位等级的人年龄分布情况。(用折线图试试)

1
2
3
4
5
6
7
#代码编写

text.Age[text.Pclass == 1].plot(kind='kde')
text.Age[text.Pclass == 2].plot(kind='kde')
text.Age[text.Pclass == 3].plot(kind='kde')
plt.xlabel("age")
plt.legend((1,2,3),loc="best")
<matplotlib.legend.Legend at 0x7f9c69946e90>
第二章:第四节数据可视化-课程_29_1

【思考】上面所有可视化的例子做一个总体的分析,你看看你能不能有自己发现

【总结】到这里,我们的可视化就告一段落啦,如果你对数据可视化极其感兴趣,你还可以了解一下其他可视化模块,如:pyecharts,bokeh等。

如果你在工作中使用数据可视化,你必须知道数据可视化最大的作用不是炫酷,而是最快最直观的理解数据要表达什么,你觉得呢?

复习:在前面我们已经学习了Pandas基础,第二章我们开始进入数据分析的业务部分,在第二章第一节的内容中,我们学习了数据的清洗,这一部分十分重要,只有数据变得相对干净,我们之后对数据的分析才可以更有力。而这一节,我们要做的是数据重构,数据重构依旧属于数据理解(准备)的范围。

开始之前,导入numpy、pandas包和数据

1
2
3
# 导入基本库
import numpy as np
import pandas as pd
1
2
3
# 载入上一个任务人保存的文件中:result.csv,并查看这个文件
text = pd.read_csv('result.csv')
text.head()
Unnamed: 0 PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin Embarked
0 0 1 0 3 Braund, Mr. Owen Harris male 22.0 1 0 A/5 21171 7.2500 NaN S
1 1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th… female 38.0 1 0 PC 17599 71.2833 C85 C
2 2 3 1 3 Heikkinen, Miss. Laina female 26.0 0 0 STON/O2. 3101282 7.9250 NaN S
3 3 4 1 1 Futrelle, Mrs. Jacques Heath (Lily May Peel) female 35.0 1 0 113803 53.1000 C123 S
4 4 5 0 3 Allen, Mr. William Henry male 35.0 0 0 373450 8.0500 NaN S

2 第二章:数据重构

第一部分:数据聚合与运算

2.6 数据运用

2.6.1 任务一:通过教材《Python for Data Analysis》P303、Google or anything来学习了解GroupBy机制

1
2
3
4
5
6
7
8
#写入心得
'''
GroupBy机制是Pandas中用于数据分组与聚合的核心操作,其本质是遵循"Split-Apply-Combine"模式:

Split:按指定键(列、函数、数组等)将数据分割成多个子集
Apply:对每个子集独立应用聚合函数(如mean/max)、转换函数(如标准化)或过滤操作
Combine:将结果合并为新的数据结构
'''

2.4.2:任务二:计算泰坦尼克号男性与女性的平均票价

1
2
3
4
5
# 写入代码
df = text['Fare'].groupby(text['Sex'])
print(df.groups)
means = df.mean()
means
{'female': [1, 2, 3, 8, 9, 10, 11, 14, 15, 18, 19, 22, 24, 25, 28, 31, 32, 38, 39, 40, 41, 43, 44, 47, 49, 52, 53, 56, 58, 61, 66, 68, 71, 79, 82, 84, 85, 88, 98, 100, 106, 109, 111, 113, 114, 119, 123, 128, 132, 133, 136, 140, 141, 142, 147, 151, 156, 161, 166, 167, 172, 177, 180, 184, 186, 190, 192, 194, 195, 198, 199, 205, 208, 211, 215, 216, 218, 229, 230, 233, 235, 237, 240, 241, 246, 247, 251, 254, 255, 256, 257, 258, 259, 264, 268, 269, 272, 274, 275, 276, ...], 'male': [0, 4, 5, 6, 7, 12, 13, 16, 17, 20, 21, 23, 26, 27, 29, 30, 33, 34, 35, 36, 37, 42, 45, 46, 48, 50, 51, 54, 55, 57, 59, 60, 62, 63, 64, 65, 67, 69, 70, 72, 73, 74, 75, 76, 77, 78, 80, 81, 83, 86, 87, 89, 90, 91, 92, 93, 94, 95, 96, 97, 99, 101, 102, 103, 104, 105, 107, 108, 110, 112, 115, 116, 117, 118, 120, 121, 122, 124, 125, 126, 127, 129, 130, 131, 134, 135, 137, 138, 139, 143, 144, 145, 146, 148, 149, 150, 152, 153, 154, 155, ...]}

Sex
female    44.479818
male      25.523893
Name: Fare, dtype: float64

在了解GroupBy机制之后,运用这个机制完成一系列的操作,来达到我们的目的。

下面通过几个任务来熟悉GroupBy机制。

2.4.3:任务三:统计泰坦尼克号中男女的存活人数

1
2
3
# 写入代码
survived_sex = text['Survived'].groupby(text['Sex']).sum()
survived_sex.head()
Sex
female    233
male      109
Name: Survived, dtype: int64

2.4.4:任务四:计算客舱不同等级的存活人数

1
2
3
# 写入代码
survived_pclass = text['Survived'].groupby(text['Pclass'])
survived_pclass.sum()
Pclass
1    136
2     87
3    119
Name: Survived, dtype: int64

提示:】表中的存活那一栏,可以发现如果还活着记为1,死亡记为0

思考】从数据分析的角度,上面的统计结果可以得出那些结论

【思考】从任务二到任务三中,这些运算可以通过agg()函数来同时计算。并且可以使用rename函数修改列名。你可以按照提示写出这个过程吗?

1
2
3
4
5
6
7
#思考心得
'''
agg() 函数是 Pandas 中用于对分组后的数据 同时执行多个聚合操作 的核心工具,其全称为 Aggregate(聚合)。它允许你对不同列应用不同的聚合函数,并支持自定义函数,极大提升数据分析效率。
'''

text.groupby('Sex').agg({'Fare': 'mean', 'Pclass': 'count'}).rename(columns=
{'Fare': 'mean_fare', 'Pclass': 'count_pclass'})
mean_fare count_pclass
Sex
female 44.479818 314
male 25.523893 577

2.4.5:任务五:统计在不同等级的票中的不同年龄的船票花费的平均值

1
2
3
4
# 写入代码
temp=text.groupby(['Pclass','Age'])['Fare']
temp.groups
temp.mean().head()
Pclass  Age  
1       0.92     151.5500
        2.00     151.5500
        4.00      81.8583
        11.00    120.0000
        14.00    120.0000
Name: Fare, dtype: float64

2.4.6:任务六:将任务二和任务三的数据合并,并保存到sex_fare_survived.csv

1
2
3
4
# 写入代码
result = pd.merge(means,survived_sex,on='Sex')
result
result.to_csv('sex_fare_survived.csv')

2.4.7:任务七:得出不同年龄的总的存活人数,然后找出存活人数最多的年龄段,最后计算存活人数最高的存活率(存活人数/总人数)

1
2
3
4
# 写入代码
survived_age = text['Survived'].groupby(text['Age']).sum()
survived_age.head()

Age
0.42    1
0.67    1
0.75    2
0.83    2
0.92    1
Name: Survived, dtype: int64
1
2
# 写入代码
survived_age[survived_age.values==survived_age.max()]
Age
24.0    15
Name: Survived, dtype: int64
1
2
_sum = text['Survived'].sum()
print(_sum)
342
1
2
3
4
5
print("sum of person:"+str(_sum))

precetn =survived_age.max()/_sum

print("最大存活率:"+str(precetn))
sum of person:342
最大存活率:0.043859649122807015

【回顾&引言】前面一章的内容大家可以感觉到我们主要是对基础知识做一个梳理,让大家了解数据分析的一些操作,主要做了数据的各个角度的观察。那么在这里,我们主要是做数据分析的流程性学习,主要是包括了数据清洗以及数据的特征处理,数据重构以及数据可视化。这些内容是为数据分析最后的建模和模型评价做一个铺垫。

开始之前,导入numpy、pandas包和数据

1
2
3
#加载所需的库
import numpy as np
import pandas as pd
1
2
3
#加载数据train.csv
df = pd.read_csv('./titanic/train.csv')
df.head(3)
PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin Embarked
0 1 0 3 Braund, Mr. Owen Harris male 22.0 1 0 A/5 21171 7.2500 NaN S
1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th… female 38.0 1 0 PC 17599 71.2833 C85 C
2 3 1 3 Heikkinen, Miss. Laina female 26.0 0 0 STON/O2. 3101282 7.9250 NaN S

2 第二章:数据清洗及特征处理

我们拿到的数据通常是不干净的,所谓的不干净,就是数据中有缺失值,有一些异常点等,需要经过一定的处理才能继续做后面的分析或建模,所以拿到数据的第一步是进行数据清洗,本章我们将学习缺失值、重复值、字符串和数据转换等操作,将数据清洗成可以分析或建模的亚子。

2.1 缺失值观察与处理

我们拿到的数据经常会有很多缺失值,比如我们可以看到Cabin列存在NaN,那其他列还有没有缺失值,这些缺失值要怎么处理呢

2.1.1 任务一:缺失值观察

  1. 请查看每个特征缺失值个数
  2. 请查看Age, Cabin, Embarked列的数据 以上方式都有多种方式,所以大家多多益善
1
2
#写入代码
df.info()
<class 'pandas.core.frame.DataFrame'>
RangeIndex: 891 entries, 0 to 890
Data columns (total 12 columns):
 #   Column       Non-Null Count  Dtype  
---  ------       --------------  -----  
 0   PassengerId  891 non-null    int64  
 1   Survived     891 non-null    int64  
 2   Pclass       891 non-null    int64  
 3   Name         891 non-null    object 
 4   Sex          891 non-null    object 
 5   Age          714 non-null    float64
 6   SibSp        891 non-null    int64  
 7   Parch        891 non-null    int64  
 8   Ticket       891 non-null    object 
 9   Fare         891 non-null    float64
 10  Cabin        204 non-null    object 
 11  Embarked     889 non-null    object 
dtypes: float64(2), int64(5), object(5)
memory usage: 83.7+ KB
1
2
#写入代码
df.isnull().sum()
PassengerId      0
Survived         0
Pclass           0
Name             0
Sex              0
Age            177
SibSp            0
Parch            0
Ticket           0
Fare             0
Cabin          687
Embarked         2
dtype: int64
1
2
3
#写入代码
df[['Age','Cabin','Embarked']].head(3)
#df['Age'].head(3)
Age Cabin Embarked
0 22.0 NaN S
1 38.0 C85 C
2 26.0 NaN S

外层 [] 是 DataFrame 的索引操作符。 内层 [] 是 Python 原生的列表语法,用于传递多个列名。

2.1.2 任务二:对缺失值进行处理

(1)处理缺失值一般有几种思路

  1. 请尝试对Age列的数据的缺失值进行处理

  2. 请尝试使用不同的方法直接对整张表的缺失值进行处理

1
2
3
4
5
#处理缺失值的一般思路:
#提醒:可使用的函数有--->dropna函数与fillna函数
#print(df.head(3))
df[df['Age']==None]=0
df.head(3)
PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin Embarked
0 1 0 3 Braund, Mr. Owen Harris male 22.0 1 0 A/5 21171 7.2500 NaN S
1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th… female 38.0 1 0 PC 17599 71.2833 C85 C
2 3 1 3 Heikkinen, Miss. Laina female 26.0 0 0 STON/O2. 3101282 7.9250 NaN S
1
2
3
#写入代码
df[df['Age'].isnull()]
df[df['Age'].isnull()] = 0
1
2
#写入代码
df[df['Age'] == np.nan] = 0

【思考1】dropna和fillna有哪些参数,分别如何使用呢?

1
2
#dropna() 是 Pandas 中用于删除包含缺失值(NaN 或 None)的行或列的函数。其核心作用是清理数据中的缺失值,适用于数据清洗阶段。
df.dropna().head(3)
PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin Embarked
1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th… female 38.0 1 0 PC 17599 71.2833 C85 C
3 4 1 1 Futrelle, Mrs. Jacques Heath (Lily May Peel) female 35.0 1 0 113803 53.1000 C123 S
5 0 0 0 0 0 0.0 0 0 0 0.0000 0 0
1
2
#fillna() 是 Pandas 中用于填充缺失值(NaN 或 None)的核心函数,常用于数据清洗阶段。其核心作用是将缺失值替换为合理值,以便后续分析或建模。
df.fillna(0).head(3)
PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin Embarked
0 1 0 3 Braund, Mr. Owen Harris male 22.0 1 0 A/5 21171 7.2500 0 S
1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th… female 38.0 1 0 PC 17599 71.2833 C85 C
2 3 1 3 Heikkinen, Miss. Laina female 26.0 0 0 STON/O2. 3101282 7.9250 0 S

【思考】检索空缺值用np.nan,None以及.isnull()哪个更好,这是为什么?如果其中某个方式无法找到缺失值,原因又是为什么?

【参考】https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.dropna.html

【参考】https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.DataFrame.fillna.html

2.2 重复值观察与处理

由于这样那样的原因,数据中会不会存在重复值呢,如果存在要怎样处理呢

2.2.1 任务一:请查看数据中的重复值

1
2
3
#写入代码
#df.duplicated()返回一个布尔序列 (Series),标记每一行是否为重复行
df[df.duplicated()]
PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin Embarked
17 0 0 0 0 0 0.0 0 0 0 0.0 0 0
19 0 0 0 0 0 0.0 0 0 0 0.0 0 0
26 0 0 0 0 0 0.0 0 0 0 0.0 0 0
28 0 0 0 0 0 0.0 0 0 0 0.0 0 0
29 0 0 0 0 0 0.0 0 0 0 0.0 0 0
859 0 0 0 0 0 0.0 0 0 0 0.0 0 0
863 0 0 0 0 0 0.0 0 0 0 0.0 0 0
868 0 0 0 0 0 0.0 0 0 0 0.0 0 0
878 0 0 0 0 0 0.0 0 0 0 0.0 0 0
888 0 0 0 0 0 0.0 0 0 0 0.0 0 0

176 rows × 12 columns

2.2.2 任务二:对重复值进行处理

(1)重复值有哪些处理方式呢?

(2)处理我们数据的重复值

方法多多益善

1
2
3
4
#重复值有哪些处理方式:
#删除 DataFrame 中的重复行(完全相同的行只保留一次)。
df = df.drop_duplicates()
df.head()
PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin Embarked
0 1 0 3 Braund, Mr. Owen Harris male 22.0 1 0 A/5 21171 7.2500 NaN S
1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th… female 38.0 1 0 PC 17599 71.2833 C85 C
2 3 1 3 Heikkinen, Miss. Laina female 26.0 0 0 STON/O2. 3101282 7.9250 NaN S
3 4 1 1 Futrelle, Mrs. Jacques Heath (Lily May Peel) female 35.0 1 0 113803 53.1000 C123 S
4 5 0 3 Allen, Mr. William Henry male 35.0 0 0 373450 8.0500 NaN S

2.2.3 任务三:将前面清洗的数据保存为csv格式

1
2
3
4
#写入代码

df.to_csv('test_clear.csv')

2.3 特征观察与处理

我们对特征进行一下观察,可以把特征大概分为两大类:
数值型特征:Survived ,Pclass, Age ,SibSp, Parch, Fare,其中Survived, Pclass为离散型数值特征,Age,SibSp, Parch, Fare为连续型数值特征
文本型特征:Name, Sex, Cabin,Embarked, Ticket,其中Sex, Cabin, Embarked, Ticket为类别型文本特征,数值型特征一般可以直接用于模型的训练,但有时候为了模型的稳定性及鲁棒性会对连续变量进行离散化。文本型特征往往需要转换成数值型特征才能用于建模分析。

2.3.1 任务一:对年龄进行分箱(离散化)处理

  1. 分箱操作是什么?

  2. 将连续变量Age平均分箱成5个年龄段,并分别用类别变量12345表示

  3. 将连续变量Age划分为[0,5) [5,15) [15,30) [30,50) [50,80)五个年龄段,并分别用类别变量12345表示

  4. 将连续变量Age按10% 30% 50% 70% 90%五个年龄段,并用分类变量12345表示

  5. 将上面的获得的数据分别进行保存,保存为csv格式

1
2
3
4
#分箱操作是什么:
'''
分箱操作(Binning)是数据预处理中的一种常用技术,主要用于将连续型数值转换为离散的区间(即“箱子”或“分组”)
'''
1
2
3
4
5
6
#写入代码
#将连续变量Age平均分箱成5个年龄段,并分别用类别变量12345表示
df['AgeBand'] = pd.cut(df['Age'], 5,labels = [1,2,3,4,5])
df.head()


PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin Embarked AgeBand
0 1 0 3 Braund, Mr. Owen Harris male 22.0 1 0 A/5 21171 7.2500 NaN S 2
1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th… female 38.0 1 0 PC 17599 71.2833 C85 C 3
2 3 1 3 Heikkinen, Miss. Laina female 26.0 0 0 STON/O2. 3101282 7.9250 NaN S 2
3 4 1 1 Futrelle, Mrs. Jacques Heath (Lily May Peel) female 35.0 1 0 113803 53.1000 C123 S 3
4 5 0 3 Allen, Mr. William Henry male 35.0 0 0 373450 8.0500 NaN S 3
1
2
3
4
5
#写入代码
#将连续变量Age划分为(0,5] (5,15] (15,30] (30,50] (50,80]五个年龄段,并分别用类别变量12345表示
df['AgeBand'] = pd.cut(df['Age'],[0,5,15,30,50,80],labels = [1,2,3,4,5])
df.head(3)

PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin Embarked AgeBand
0 1 0 3 Braund, Mr. Owen Harris male 22.0 1 0 A/5 21171 7.2500 NaN S 3
1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th… female 38.0 1 0 PC 17599 71.2833 C85 C 4
2 3 1 3 Heikkinen, Miss. Laina female 26.0 0 0 STON/O2. 3101282 7.9250 NaN S 3
1
2
3
4
#写入代码
#将连续变量Age按10% 30% 50 70% 90%五个年龄段,并用分类变量12345表示
df['AgeBand'] = pd.qcut(df['Age'],[0,0.1,0.3,0.5,0.7,0.9],labels = [1,2,3,4,5])
df.head()
PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Cabin Embarked AgeBand
0 1 0 3 Braund, Mr. Owen Harris male 22.0 1 0 A/5 21171 7.2500 NaN S 2
1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th… female 38.0 1 0 PC 17599 71.2833 C85 C 5
2 3 1 3 Heikkinen, Miss. Laina female 26.0 0 0 STON/O2. 3101282 7.9250 NaN S 3
3 4 1 1 Futrelle, Mrs. Jacques Heath (Lily May Peel) female 35.0 1 0 113803 53.1000 C123 S 4
4 5 0 3 Allen, Mr. William Henry male 35.0 0 0 373450 8.0500 NaN S 4

【参考】https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.cut.html

【参考】https://pandas.pydata.org/pandas-docs/stable/reference/api/pandas.qcut.html

2.3.2 任务二:对文本变量进行转换

  1. 查看文本变量名及种类
  2. 将文本变量Sex, Cabin ,Embarked用数值变量12345表示
  3. 将文本变量Sex, Cabin, Embarked用one-hot编码表示
1
2
3
4
5
6
#写入代码
#方法一: value_counts
print(
df['Sex'].value_counts(),
df['Cabin'].value_counts(),
df['Embarked'].value_counts())
Sex
male      453
female    261
0           1
Name: count, dtype: int64 Cabin
B96 B98        4
G6             4
C23 C25 C27    4
F2             3
C22 C26        3
              ..
E36            1
D7             1
C118           1
C99            1
D37            1
Name: count, Length: 135, dtype: int64 Embarked
S    554
C    130
Q     28
0      1
Name: count, dtype: int64
1
2
3
#写入代码
df['Sex'].unique()
df['Sex'].nunique()
3
1
2
3
4
5
6
7
8
9
10
11
12
13
14
15
16
17
18
19
20
#写入代码
#将类别文本转换为12345

#方法一: replace
df['Sex_num'] = df['Sex'].replace(['male','female'],[1,2])
df.head()
#方法二: map
df['Sex_num'] = df['Sex'].map({'male': 1, 'female': 2})
df.head()
#方法三: 使用sklearn.preprocessing的LabelEncoder
from sklearn.preprocessing import LabelEncoder
for feat in ['Cabin', 'Ticket']:
lbl = LabelEncoder()
label_dict = dict(zip(df[feat].unique(), range(df[feat].nunique())))
#print(label_dict)
df[feat + "_labelEncode"] = df[feat].map(label_dict)
df[feat + "_labelEncode"] = lbl.fit_transform(df[feat].astype(str))

df.head()

/tmp/ipykernel_1400/2627332835.py:5: FutureWarning: Downcasting behavior in `replace` is deprecated and will be removed in a future version. To retain the old behavior, explicitly call `result.infer_objects(copy=False)`. To opt-in to the future behavior, set `pd.set_option('future.no_silent_downcasting', True)`
  df['Sex_num'] = df['Sex'].replace(['male','female'],[1,2])
PassengerId Survived Pclass Name Sex Age SibSp Parch Ticket Fare Age_66.0 Age_70.0 Age_70.5 Age_71.0 Age_74.0 Age_80.0 Embarked_0 Embarked_C Embarked_Q Embarked_S
0 1 0 3 Braund, Mr. Owen Harris male 22.0 1 0 A/5 21171 7.2500 False False False False False False False False False True
1 2 1 1 Cumings, Mrs. John Bradley (Florence Briggs Th… female 38.0 1 0 PC 17599 71.2833 False False False False False False False True False False
2 3 1 3 Heikkinen, Miss. Laina female 26.0 0 0 STON/O2. 3101282 7.9250 False False False False False False False False False True
3 4 1 1 Futrelle, Mrs. Jacques Heath (Lily May Peel) female 35.0 1 0 113803 53.1000 False False False False False False False False False True
4 5 0 3 Allen, Mr. William Henry male 35.0 0 0 373450 8.0500 False False False False False False False False False True

5 rows × 109 columns

1
2
3
4
5
6
7
8
9
10
11
12
#将类别文本转换为one-hot编码

#方法一: OneHotEncoder
for feat in ["Age", "Embarked"]:
x = pd.get_dummies(df["Age"] // 6)
# x = pd.get_dummies(pd.cut(df['Age'],5))
x = pd.get_dummies(df[feat], prefix=feat)
df = pd.concat([df, x], axis=1)
#df[feat] = pd.get_dummies(df[feat], prefix=feat)

df.head()
df.to_csv('temp.csv')

2.3.3 任务三:从纯文本Name特征里提取出Titles的特征(所谓的Titles就是Mr,Miss,Mrs等)

1
2
3
4
#写入代码


1
2
#保存最终你完成的已经清理好的数据

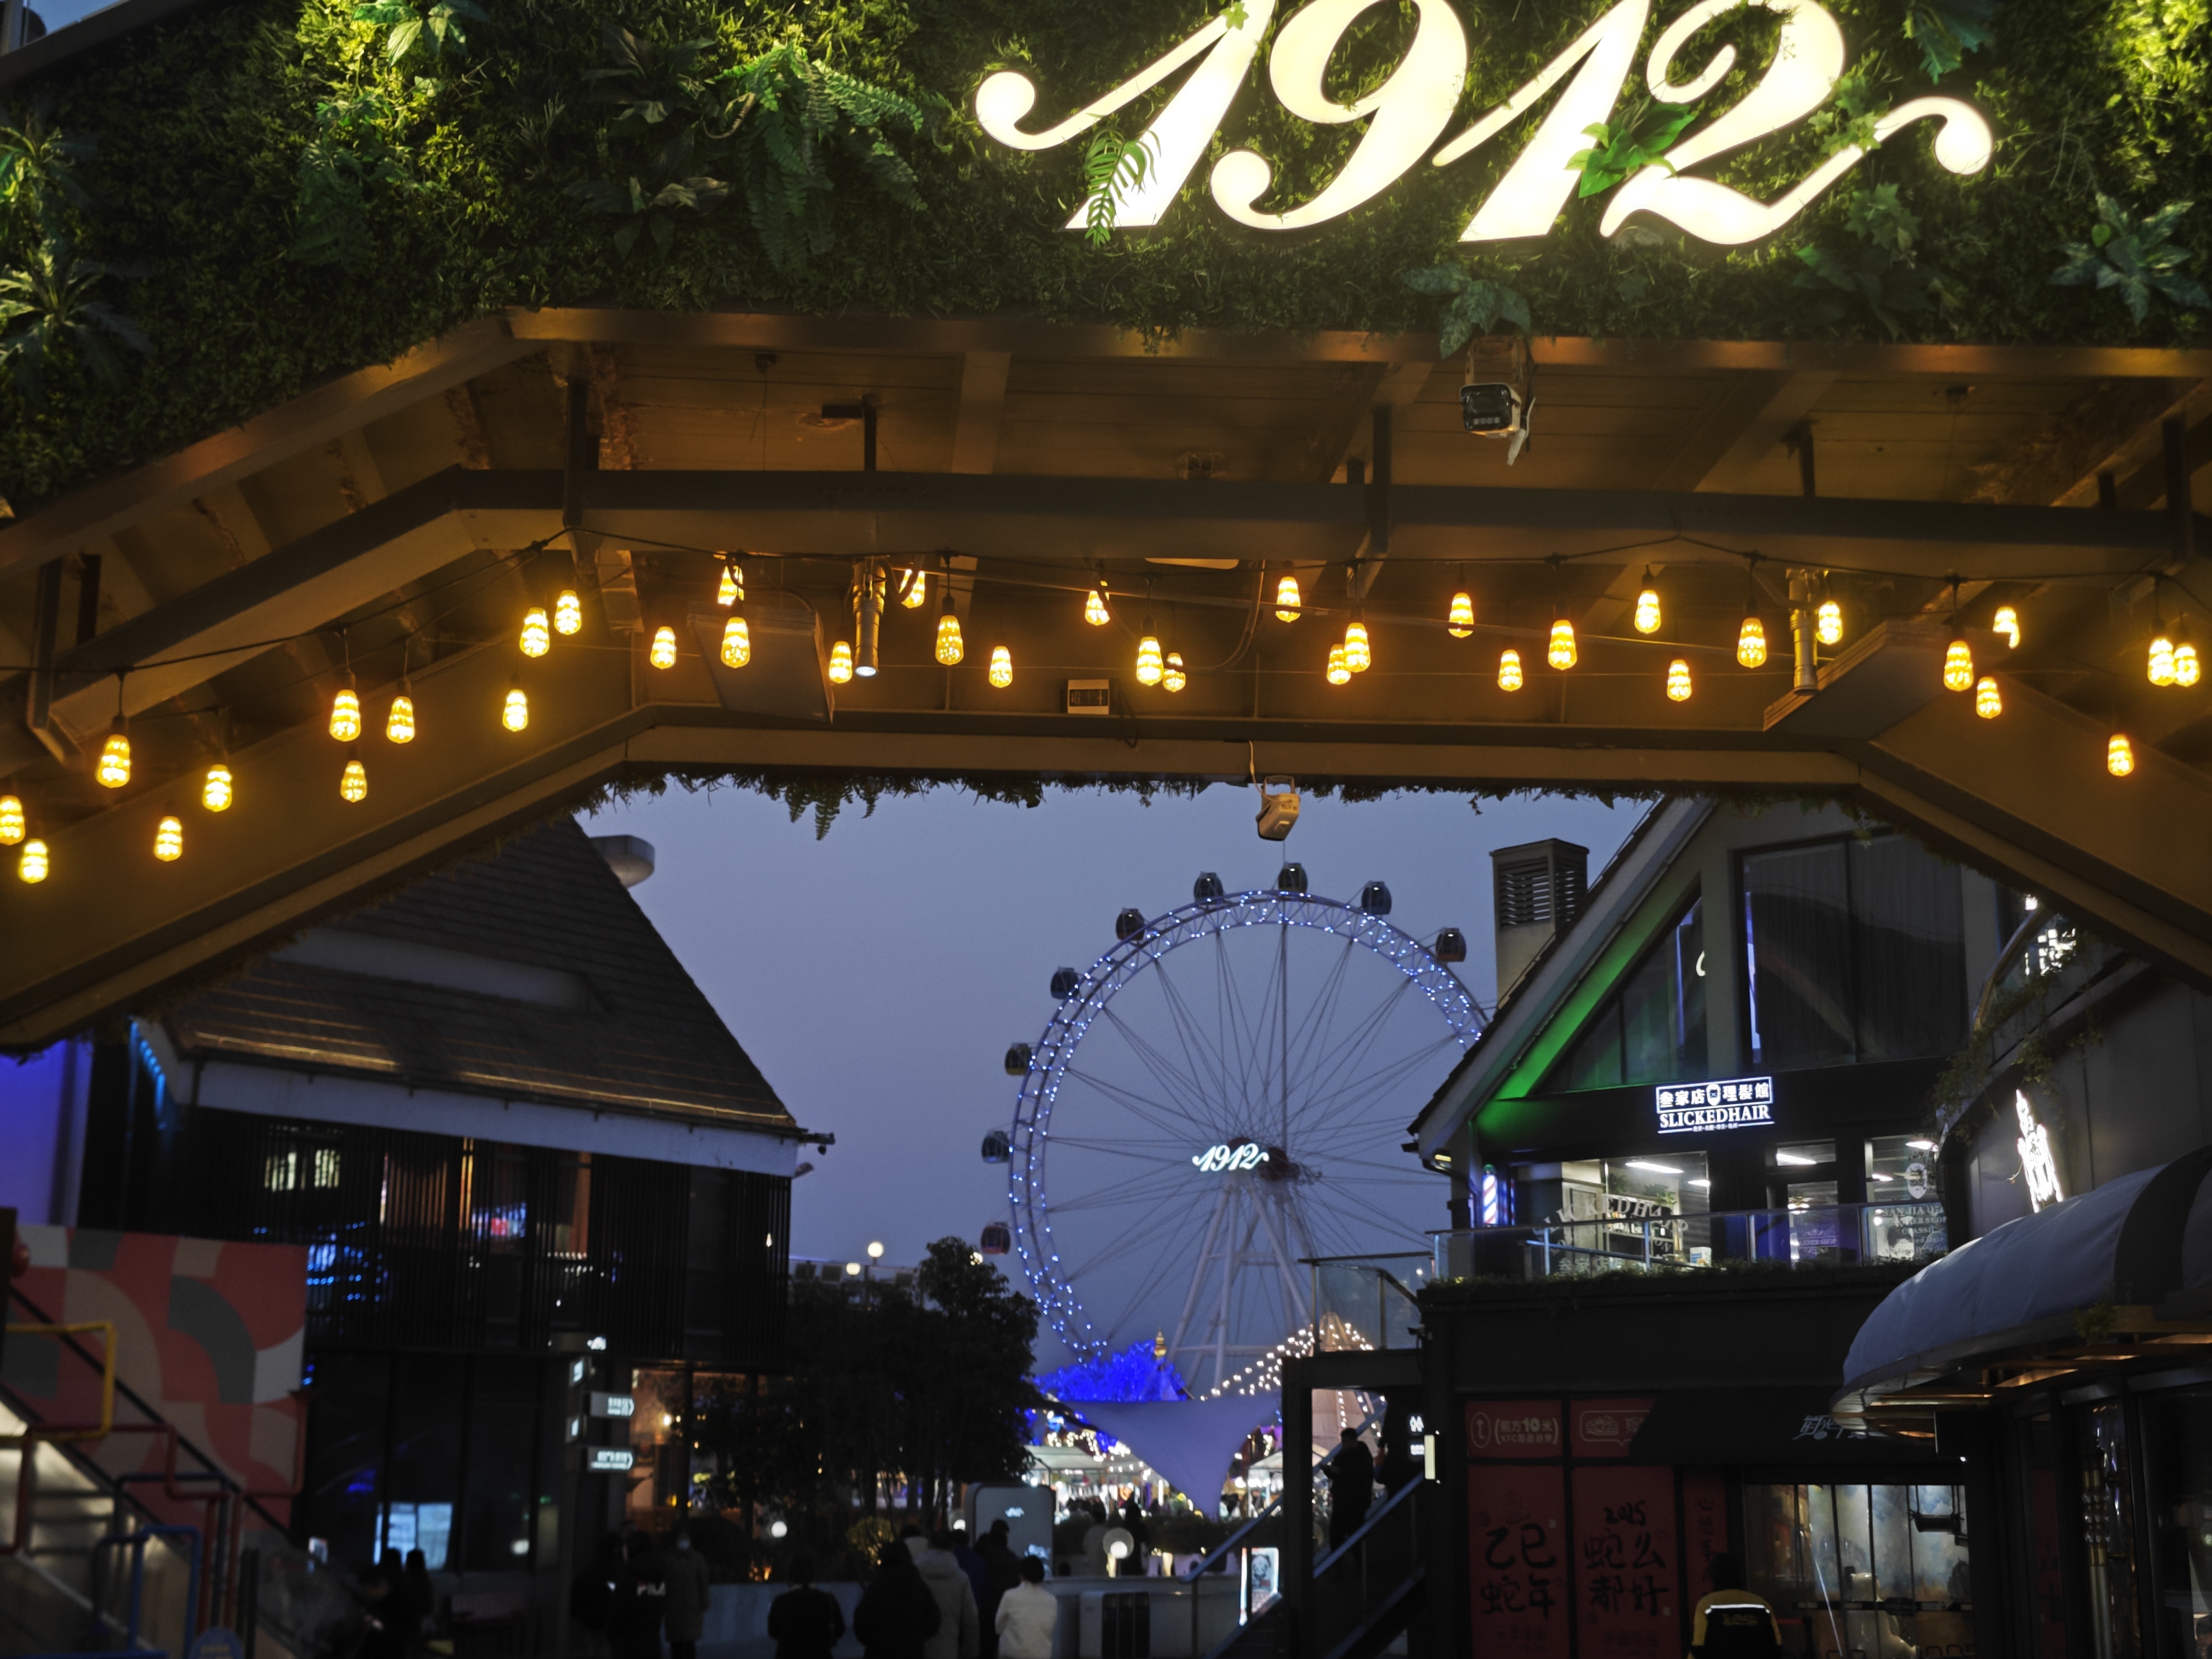
1912

2025年的生日,与李哥在百家湖1912聚餐,李哥请我吃的铁板烧,超级美味

1745080784805
1745080784820
1745080784834
1745080784848
1745080784862
1745080784789

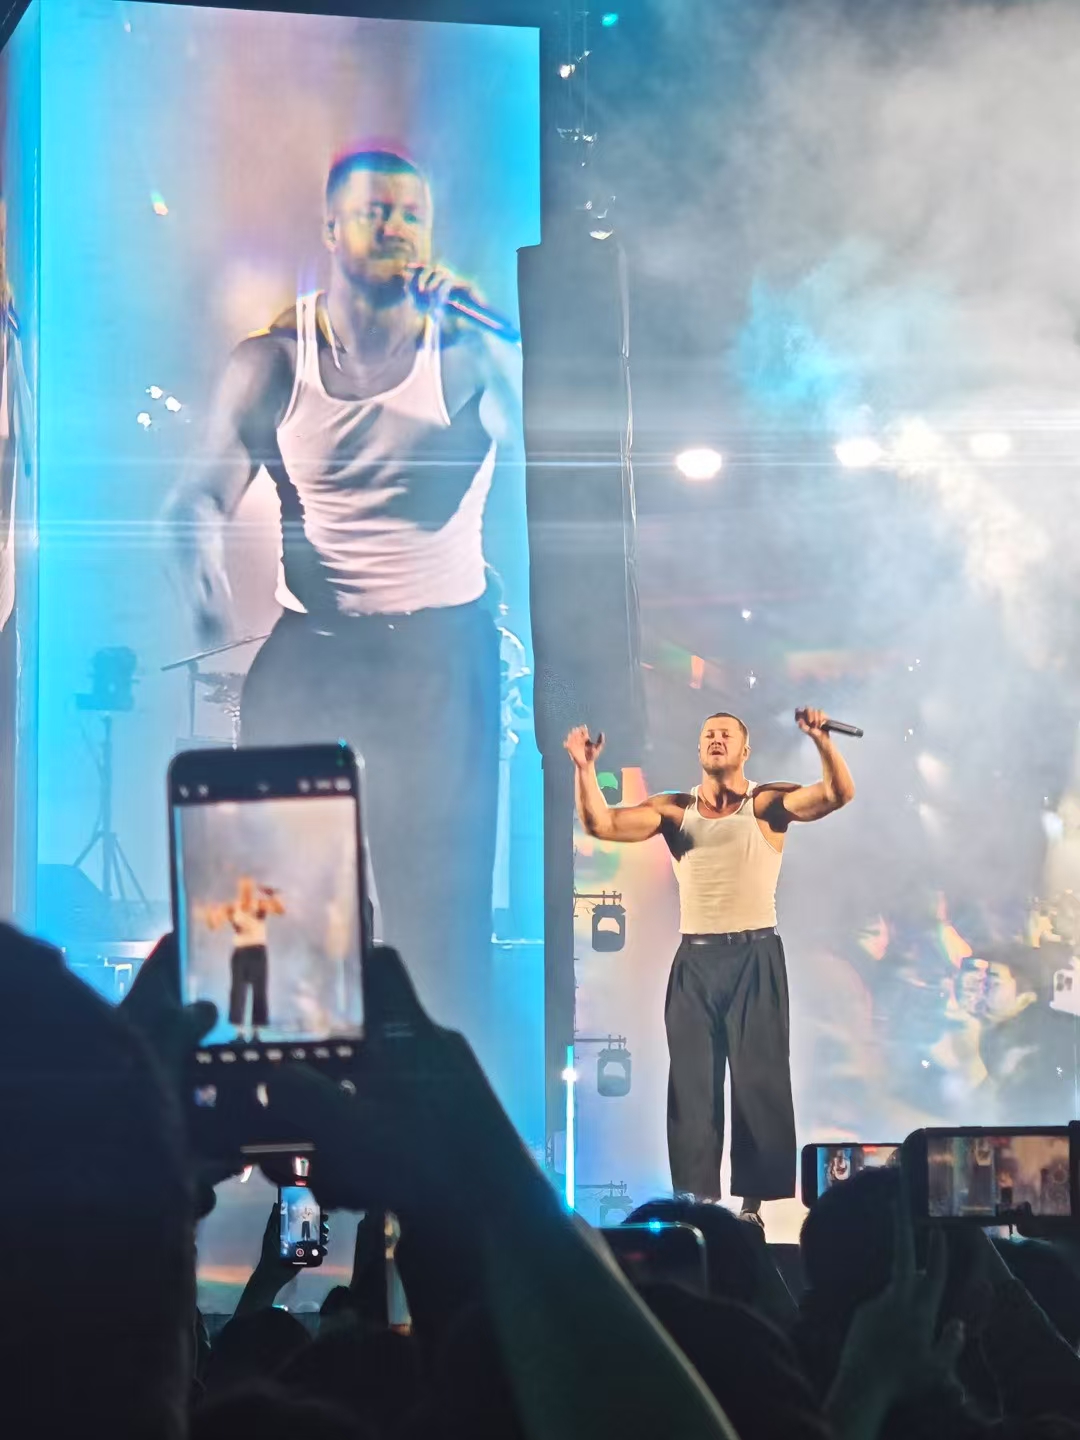
梦龙演唱会

4.6 Imagine Dragons 杭州 真的太嗨太嗨了,内场氛围巨好无比,所有人都在合唱,超值啊! 再记录一下这次比较特别的体验,在小红书找到了一个自驾去看演唱会的,五个人一辆车边走边聊边听歌,也是很不错啊

1745078837710
1745078837725
1745078837752
1745078837739
1745078837778

前言

我是一个很珍惜回忆的人,但是任何回忆都有忘却的那一天,所以我能做的就是尽可能把他ji’lu

我想听他扫弦的声音

南京1701livehouse

1745077840515
1745077840490
1745077840469
1745077840480

橘子海

橘子海,现场超超超超级赞,嗨到爆,完全超出预期

Give me the faith that we broke

请重拾我们背叛过的誓言

Reminds me the verse that we spoke

不要让我遗忘共同诵读过的诗篇

There is no chance for start it over

一切已经永远无法重来

Back to the check point be my lover

回不去那个你我还是“我们”的存盘点

1745079894738
1745079894693
1745079894721
1745079894676
1745079894659
1745079894631
1745079894645
0%